通过 Failure-Bank 自演化从运行时反馈中学习 Vision-Language-Action 模型
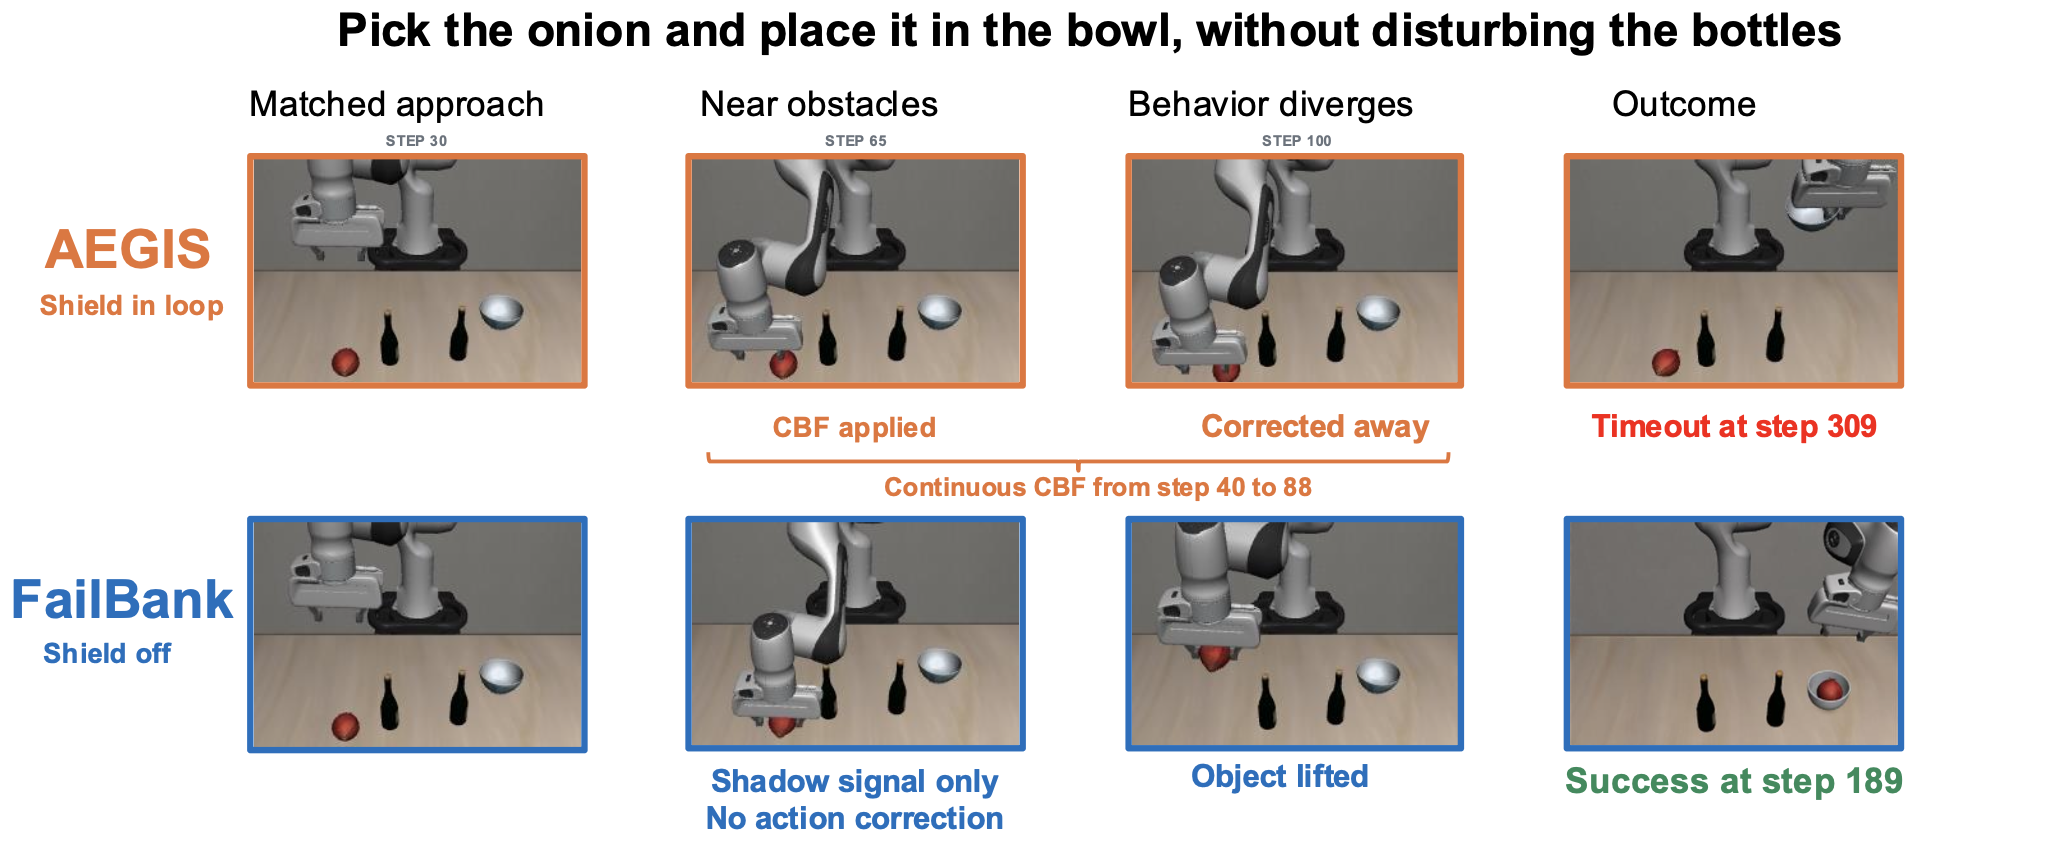
Vision-Language-Action (VLA) 模型在机器人操作任务上具有广泛泛化能力,但在复杂环境中需在任务成功与意外接触之间取得平衡。运行时 shield 虽能纠正单步动作,却无法改变底层策略,反复出现分歧会造成持续的策略-shield 失配,阻碍任务推进。 为此,作者提出 FailBank,一个四阶段自演化框架,将运行时反馈转化为持久的策略改进: 1. 采集阶段:固定的 CBF-based 安全模块作为只观察的教师,生成反事实纠正,而策略始终处于控制状态; 2. 结果感知准入:将有用的纠正建议转化为修正目标,并保留成功的未纠正动作作为「安静锚点」,用于有保护的 LoRA 更新。 实验在 VLA-Arena 基准上开展,覆盖两档难度与两种 VLA 主干。相比基座策略,FailBank 改善了成功率-代价联合运作点:两种主干的任务成功率分别提升 8.5 与 6.9 个百分点,策略导致累计代价下降 35.6% 与 23.8%。相比运行时 shielding,FailBank 成功率再提升 25.4 与 9.5 个百分点,而策略导致累计代价保持相当。 结果表明,运行时反馈可作为持久的策略监督,而非仅是临时的动作约束。
论文精读
TL;DR FailBank 通过失败银行自进化,将 CBF 运行时安全屏蔽的反事实修正转化为 VLA 策略的持久 LoRA 更新,在 VLA-Arena 上提升成功率 8.5/6.9 个百分点并降低策略诱发成本 35.6%/23.8%,打破了仅靠屏蔽的临时约束局限。
问题
问题背景
视觉-语言-动作(VLA)模型在机器人操作中展现出强泛化能力,但部署到复杂环境时,需要同时优化任务成功率与意外接触成本,二者存在固有张力。
现有方法局限
运行时屏蔽 (如 CBF 安全层)能在动作执行前进行修正,却不更新底层策略。当策略反复产生需要屏蔽的动作时,会导致策略-屏蔽器失配:屏蔽器持续拦截,任务进度停滞。此外,屏蔽只能提供临时动作约束,无法将宝贵的运行期反馈沉淀为策略能力。现有离线模仿学习或安全对齐方法要么无法利用在线反馈,要么需要人工标注或额外奖励信号,难以规模化。
为什么这个问题难/重要
将运行期反馈转化为持久策略改进面临三重挑战:
- 信号筛选:运行期可能包含大量正确动作,错误修正信号稀疏且噪声大,需要区分有效纠正与过度干预。
- 防遗忘:在持续更新策略时,要保留已学会的安全行为,避免新知识覆盖旧知识。
- 部署一致性:策略与屏蔽器在实时闭环中互动,任何更新都可能改变系统动力学,难以保证收敛。
业界对 VLA 模型的可靠部署高度关注,安全-效率权衡 是机器人通用操作从实验室走向实际场景的关键瓶颈。
行业类比
类似自动驾驶中规划器与安全控制器 反复冲突导致车辆震荡,更好的做法是将每次人工或系统干预转化为模型微调数据,而不是仅依赖事后拦截。
核心洞察
- FailBank 的核心是将运行时反馈转化为可累积的策略更新信号,而非临时动作约束。现有 runtime shielding 仅在推理时修正动作,策略本身不变,导致策略与 shield 反复冲突,任务停滞。FailBank 让 CBF 安全模块作为 observe-only teacher 产生反事实校正,收集到 failure bank,再通过 LoRA 更新策略,使策略从失败中自我进化,提升长期成功率并降低策略诱导成本。
- outcome-aware admission 与 quiet anchors 的配合实现了有选择的经验回放,避免遗忘并强化成功轨迹。仅使用失败样本更新可能导致策略偏向保守或遗忘已有技能,FailBank 将成功且未校正的动作保留为 quiet anchors,与纠正样本一起用于 LoRA 更新,平衡了安全对齐与任务能力。这种设计比直接监督学习或策略蒸馏更稳健,在 VLA-Arena 两个难度级别上同时提升成功率和降低成本。
方法
输入
VLA 策略在机器人操作任务中执行,同时一个基于 CBF 的安全模块作为 observe-only teacher 运行,产生反事实修正动作,但策略仍保持实际控制。
关键模块
FailBank 包含四个阶段:
- Stage 1: Observe and Label - 收集策略执行轨迹,CBF teacher 为每个动作生成反事实修正;记录 state、action、correction、outcome。
- Stage 2: Admit and Weight - 根据任务结果进行 outcome-aware 筛选:将有效的修正 proposal 转为 corrective targets;保留成功且未修正的动作作为 quiet anchors,用于稳定后续更新。
- Stage 3: Accumulate - 将多轮运行时反馈累积为 failure bank,形成持久化训练数据集。
- Stage 4: Update - 对 VLA 策略进行 guarded LoRA 更新,利用 corrective targets 和 quiet anchors 联合监督,最小化策略与 teacher 之间的分歧,同时避免灾难性遗忘。
输出
更新后的 VLA 策略,在后续 rollout 中减少与 shield 的冲突,提升任务成功率并降低策略引起的累积代价。
与同类方法差异:运行时 shielding 仅临时修正动作,不改变策略;FailBank 将 runtime feedback 转化为持续的策略监督信号,实现策略自进化。
实验
实验设计
FailBank 在 VLA-Arena 基准上评估,覆盖两个难度级别与两个 VLA 骨干。框架分四阶段:收集阶段用固定 CBF 安全模块 作为 observe-only 教师生成反事实纠正;随后 outcome-aware admission 将有用建议转为纠正目标,并保留成功未纠正动作作为 quiet anchors;最后通过 LoRA 更新策略。指标为任务成功率与政策诱导累积成本。
关键发现
与基础策略相比,两骨干上任务成功率分别 +8.5 / +6.9 pp,政策诱导累积成本分别 降低 35.6% / 23.8%。与 runtime shielding 相比,成功率提升 +25.4 / +9.5 pp,同时累积成本保持可比。结果表明 runtime feedback 可作为持久策略监督,而非临时动作约束。
基线对比解读
runtime shielding 只在推理时修正动作,不改变策略,易产生 policy-shield 反复冲突并阻塞任务;FailBank 将运行时反馈沉淀为策略更新,从源头降低不安全动作概率,在几乎不增加成本代价下大幅提升成功率,验证了 fail-bank 自演化的监督价值。
行业影响
落地场景
FailBank 可应用于任何部署了 VLA 策略并配备运行时安全层(如 CBF shield)的机器人操作场景,如电商仓储拣选、家庭服务机器人、工业装配。这些场景要求平衡任务成功率与意外接触成本,FailBank 将运行时反馈转为持久策略改进,减少 shield 与策略的长期冲突。
商业价值
主要价值在于降低碰撞损坏与人工干预成本,同时提升任务自主完成率。论文数据显示,相比 base policy,成功率提升 6.9–8.5 个百分点,策略诱导累积成本降低 23.8%–35.6%;相比仅用 runtime shielding,成功率提升 9.5–25.4 个百分点,而成本保持可比。这意味着更少的货损、更少的停机、更高的吞吐,直接关联运营成本与客户体验。
与现有产品/工作流的接口
FailBank 不要求替换现有安全层,而是将其作为 observe-only teacher。部署时收集 counterfactual corrections 与成功动作,离线构建 failure bank,用 LoRA 对 base policy 做 guarded update。可集成到现有 MLOps 流程:推理端持续记录,训练端周期性微调,无需改动推理架构或安全约束。
具体落地用例
- 电商仓储拣选:VLA 驱动的机械臂在货架间抓取商品,现有 CBF shield 可防止碰撞,但频繁触发会卡住任务。FailBank 让策略学会主动避障,提高拣选成功率,减少退货与损耗。
- 酒店配送机器人:在动态走廊环境中导航并操作电梯、门把手,FailBank 将避障反馈融入策略,减少对本地 planner 的干预,提升流畅性与用户满意度。
局限
- **对固定 CBF 教师的依赖**:FailBank 的核心学习信号来自固定的 CBF 安全模块产生的反事实纠正,这要求任务具有明确且可公式化的安全约束(例如避免接触)。对于更复杂的安全需求,如动态避障或语义级安全规则,CBF 可能难以设计或参数敏感。论文在动态障碍压力测试中报告了 null result(见附录 E.8),暗示该方法在非静态约束场景下收益有限。
- **数据采集与仿真依赖**:自进化过程需要多轮交互来积累 Failure Bank,当部署到真实机器人时,在线数据采集成本较高,且 sim-to-real 迁移尚未验证。实验仅在 VLA-Arena 仿真基准上进行,并使用两种 VLA 骨干(如 OpenVLA、RT-2 等),覆盖有限的任务和难度级别,限制了结论的广泛性。
- **安全与效率的权衡仍存**:虽然 FailBank 相比 runtime shielding 大幅提升了任务成功率,但策略诱导的累积成本仅“保持可比”,并未显著低于 shielding 基线。这意味着策略改进后仍可能产生一定的非预期接触成本,且 guarded LoRA 更新选择 quiet anchors 的机制可能过滤掉一些有价值但存在风险的纠正信号,进一步改善空间有限。