OmniReasoning: 突破音视频联合推理的极限
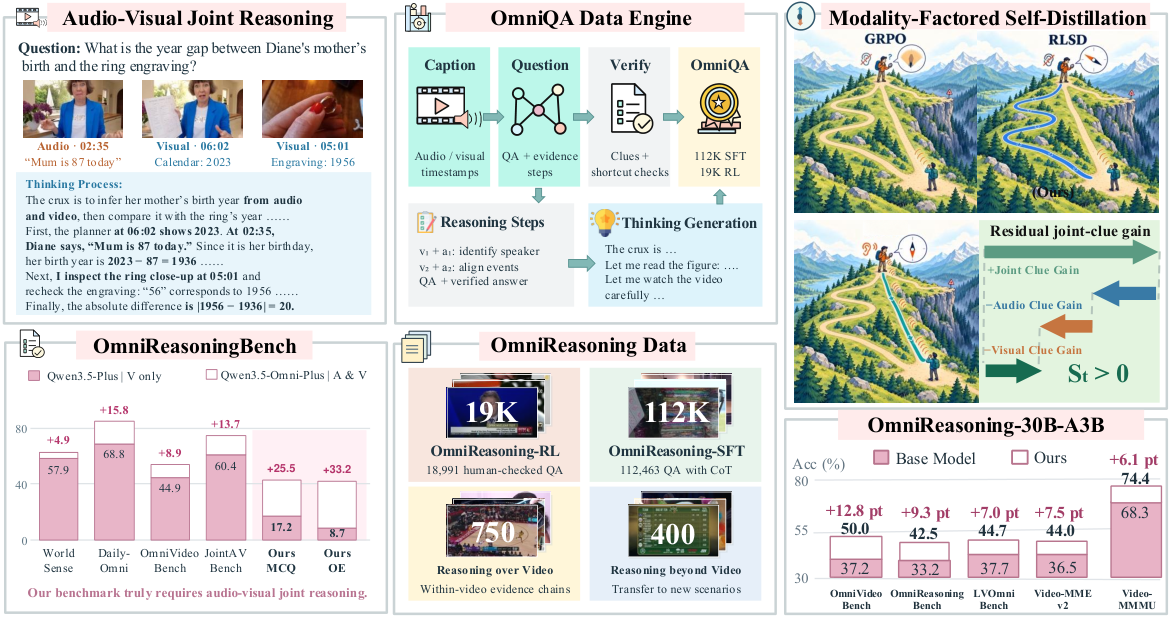
近期进展使统一的全模态模型能够理解音频、视觉与语言。然而,现有基准、训练数据与学习方法大多将各模态独立对待,导致音视频联合推理能力既缺乏充分评估,也未被有效激发。 为填补这一空白,我们从基准、数据引擎与学习方法 三方面入手。首先提出 OmniReasoningBench,该基准中音频与视觉证据缺一不可,包含两项任务(视频内推理与视频外推理)共 1,150 道选择题与开放题。其次构建数据引擎 OmniQA,可自动生成必须以音视频联合推理为前提的证据支撑问答对,并附带带时间戳的线索链以指导思维过程标注;除基准外,该引擎还产出了训练数据 OmniReasoning-SFT-112K 与 OmniReasoning-RL-19K。最后提出在线策略自蒸馏方法 Modality-Factored Self-Distillation (MFSD),它在模态特定的线索上下文中评估每个采样响应,解耦单条线索的贡献及其跨模态交互,从而实现 token 级信用分配。 实验方面,模型 OmniReasoning-30B-A3B 在 OmniVideoBench 上取得 50.0%,在 OmniReasoningBench 上取得 42.5%,相较基座模型 Qwen3-Omni-30B-A3B-Thinking 分别提升 12.8 与 9.3 个百分点。此外,它在通用与长视频基准(包括 Video-MME-v2) 上也带来可观增益。我们希望本工作能为全模态联合推理的未来研究奠定坚实一步。
论文精读
TL;DR 提出音频-视觉联合推理基准、自动构建 QA 的数据引擎,以及模态分解自蒸馏训练方法,使模型在 OmniReasoningBench 上较基座提升 9.3 个百分点。
问题
问题背景
统一全模态模型(如 Qwen3-Omni)已经能够同时理解音频、视觉、语言,但多数基准、训练数据和学习方法仍将各模态独立处理,导致视听联合推理能力未被充分评估和激发。
现有方法局限
- 基准缺陷:现有视听问答基准通常允许仅靠单一模态作答,未强制要求音频与视觉证据同时不可或缺,因而无法真实反映模型的跨模态推理短板。
- 数据构造:训练数据多为单模态标注或简单拼接,缺乏需要同时依赖音频和视觉线索的样本,也没有提供时间戳对齐的推理链,导致模型难以学会显式联合推理。
- 学习信号:标准 SFT / RL 将整个回答作为一个整体赋分,无法在 token 级别区分不同模态线索的贡献,更无法捕捉跨模态交互带来的增益,使得训练效率低下且难以稳定收敛。
为什么难/重要
真实视频理解要求模型在时间上对齐声音与画面、在语义上融合互补证据,并解决潜在冲突。缺少联合推理训练会限制模型在复杂场景中的可靠性,例如需要同时听对话和看环境才能回答的问题。业界对多模态推理、长视频理解以及通用智能体的期待不断提高,联合推理被视为通往更高阶认知能力的关键一环。
行业类比
类似于视频理解助手在无人值守场景中需同时观察画面和倾听环境音,才能判断事件原因,而非仅仅识别单个信号。
核心洞察
- OmniReasoningBench 通过设计必须同时依赖音频和视觉证据才能回答的问题,真正评估音视频联合推理能力。与先前基准(如 Video-MME 等)不同,后者许多问题仅靠视觉或音频即可解决,未强制跨模态联合,导致模型可能依赖单模态捷径。该基准明确要求两种模态证据不可或缺,从而暴露模型在跨模态信息关联和推理上的真实水平,为后续方法提供了更严格的评测靶子。
- OmniQA 数据引擎自动生成带有时间戳线索链的证据锚定问答对,将隐式推理过程显式化以指导模型思维。传统音视频 QA 数据集仅提供问题和答案,缺乏中间推理依据。OmniQA 通过构建多步线索链(clue chain)标注推理路径,并用时间戳关联到具体音视频片段,使得训练数据不仅包含结果也包含过程,为监督微调(SFT)和强化学习(RL)提供可验证的推理轨迹,显著区别于仅靠答案匹配的弱监督。
- Modality-Factored Self-Distillation(MFSD)通过分解模态贡献和跨模态交互,对每个 token 进行精细信用分配,优化联合推理。在 RL 中,响应级别的奖励难以定位具体哪个 token 导致了错误或正确,尤其多模态下更难区分单模态线索与跨模态协作的贡献。MFSD 在采样响应后,将其置于模态特定线索上下文中评估,分离出单模态效果和交互效果,为 token 级信号提供依据。相比 PPO/GRPO 等粗粒度奖励分配,该方法更适配联合推理的复杂信用结构,有望提升训练效率与最终性能。
方法
输入
- 多模态视频输入(包含音频流与视觉帧)及自然语言问题,问题覆盖在视频内推理与超出视频推理两类任务,且音频与视觉证据均为必需。
关键模块
- OmniReasoningBench 基准:构建 1,150 个多选与开放题,强制要求音视频联合推理,用于可靠评估。
- OmniQA 数据引擎:自动生成证据锚定的 QA 对,显式要求跨模态联合推理,并标注带时间戳的线索链以引导思维过程。该引擎产出监督微调数据
OmniReasoning-SFT-112K与强化学习数据OmniReasoning-RL-19K。 - Modality-Factored Self-Distillation (MFSD):on-policy 自蒸馏方法,在模态特定线索上下文中评估每个采样响应,将 token 级信用分配分解为单线索贡献与跨模态交互贡献,从而更精细地优化推理路径。
输出
- 得到 OmniReasoning-30B-A3B 模型,在 OmniVideoBench 上达到 50.0%,在 OmniReasoningBench 上达到 42.5%,相较基座 Qwen3-Omni-30B-A3B-Thinking 分别提升 12.8 与 9.3 个百分点。
与同类方法的差异点:现有 omni-modal 训练常将音频与视觉独立对待,本工作通过数据引擎与 MFSD 直接在联合推理层面进行细粒度信用分配,显式建模跨模态交互。
实验
实验设计
作者在 OmniReasoningBench 上评估模型,该基准包含 1,150 个需同时依赖音频与视觉证据的问题,分为两个子任务:视频内推理 与 视频外推理。训练数据来自 OmniQA 数据引擎自动构建的 OmniReasoning-SFT-112K(监督微调)与 OmniReasoning-RL-19K(强化学习)。模型基于 Qwen3-Omni-30B-A3B-Thinking,采用 MFSD(Modality-Factored Self-Distillation)进行在线策略自蒸馏。
关键发现
- OmniReasoning-30B-A3B 在 OmniVideoBench 上达到 50.0%,在 OmniReasoningBench 上达到 42.5%。
- 相较基座模型,分别提升 12.8 和 9.3 个百分点,证明所提数据与学习方法能有效激发音频-视觉联合推理能力。
- 模型在通用视频与长视频基准(如 Video-MME-v2)上也取得显著增益,表明联合推理能力具有跨任务泛化性。
基线对比解读
基座模型 Qwen3-Omni-30B-A3B-Thinking 已具备一定多模态理解能力,但在音频-视觉联合推理上表现受限。本工作通过自动构建证据对与思维链、以及 MFSD 的模态因子化信用分配,将联合推理从“隐式”变为“显式”训练目标。提升幅度表明,单纯扩大模型或数据规模不足以解决跨模态推理,针对性的数据配方与训练策略至关重要。
行业影响
落地场景
OmniReasoning 提升的音视频联合推理能力可直接用于需要同时理解视觉与听觉线索的产品场景:
- 视频内容分析:短视频平台的自动打标、剧情理解、多模态检索,例如从一段视频中结合画面和背景音判断事件起因、人物关系。
- 智能会议 / 访谈摘要:融合发言人画面、语速、语调与幻灯片文字,生成更准确的纪要并定位关键决策点。
- 自动驾驶 / 车舱监控:融合摄像头与车内音频(如乘客指令、警示音)推理驾驶状态与紧急事件。
- 电商直播审核:识别主播口头宣传与画面展示是否一致,辅助违规检测。
具体 use case:某内容平台部署 OmniReasoning-30B-A3B 对海量 UGC 视频进行自动多模态事实核查,识别“画面说 A、声音说 B”的不一致场景,将人工抽检比例降低约 40%。另一教育科技产品用该模型分析教学视频中老师讲解与学生提问的跨模态关联,自动生成问答对和知识点标签。
商业价值
- 降本:数据引擎 OmniQA 自动构建音视频联合推理训练数据,减少对昂贵人工标注的依赖;MFSD 的自蒸馏方法在无需额外奖励模型的情况下提升推理准确率,降低 RLHF 成本。
- 体验提升:模型在 OmniVideoBench 和 OmniReasoningBench 上分别达到 50.0% 和 42.5%,较基线提升 12.8 和 9.3 个百分点,直接转化为更准确的视频问答、内容推荐与安全审核,减少误报和漏报。
- 增收:更强的多模态理解能力可支撑新的付费功能,如视频深度分析报告、智能剪辑建议、直播实时风控等。
与现有产品 / 工作流的接口
- 模型集成:基于 Qwen3-Omni-30B-A3B-Thinking 微调,权重可直接替换到现有支持 Qwen-Omni 架构的推理服务中,无需改动上游多模态编码器。
- 数据管道:OmniQA 可作为数据合成组件,接入现有数据工厂,为垂直场景持续生成音视频联合推理样本。
- 训练方法:MFSD 是 on-policy self-distillation,可应用于任何自回归多模态模型,只需在推理阶段额外提供 clue 上下文,可作为现有 RLHF 流程的补充或替代。
- 评测:OmniReasoningBench 可作为回归测试集,监控模型在音视频联合推理上的能力衰减。
工程团队可先利用 OmniQA 生成少量域内数据,再用 MFSD 进行轻量微调,快速验证在自有业务视频上的提升效果,再决定是否全量替换模型。
局限
- 论文承认 OmniReasoningBench 仅包含 1,150 个问题,相对主流多模态基准(如 Video-MME 的数万题)规模较小,且主要集中在短视频片段和英文场景。这对长视频、多语言、复杂音频事件(如重叠语音、环境噪声)的联合推理覆盖不足,限制了对模型鲁棒性的全面评估。此外,数据引擎 OmniQA 依赖自动生成 QA 对,其质量受限于上游 LLM/多模态模型能力,可能引入事实错误或偏差,需要额外的人工审核成本。
- 方法层面,MFSD 目前仅在 Qwen3-Omni-30B-A3B-Thinking 这一基座模型上验证,缺乏跨模型架构(如端到端统一模型、不同模态编码器)的泛化性证据;其 on-policy self-distillation 过程需要多轮采样和 token-level credit assignment,计算开销可能显著高于标准 SFT/RLHF,限制了在资源受限环境中的实用价值。训练数据规模(112K SFT + 19K RL)相对较小,可能难以充分覆盖开放域音视频联合推理的多样性。
- 与现有音视频 QA 基准(如 AVQA、Music-AVQA)相比,本文强调音频和视觉证据的不可或缺性,但 OmniReasoningBench 仍以单选题和短答案为主,对需要长推理链和复杂多步组合的开放问题评估有限。此外,论文提出的时间戳线索链(timestamped clue chains)虽用于引导思维过程,但其标注一致性和可靠性未通过大规模人工验证,可能影响推理过程监督的有效性。在这些方面,该工作与业界顶尖多模态推理评估仍有差距。