STEPQuant:Delta-Rule 循环状态量化中误差何时与何处重要
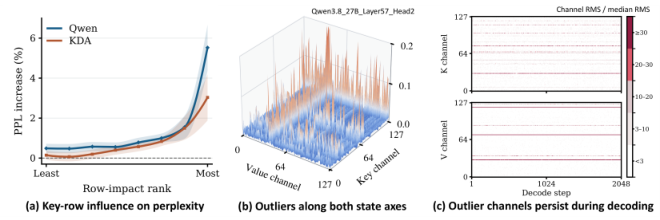
线性注意力用固定大小的循环状态取代不断增长的 KV cache,但在并发服务下,这些持久状态会成为显著的内存瓶颈。直接把循环状态量化为低精度往往导致精度严重下降,因为量化误差会随连续的状态更新不断传播。 我们发现误差的影响取决于两个互补维度:时间上,长期存活的记忆中的误差会持续影响许多解码步;空间上,不同 key 行的误差对模型输出的影响不同,且状态幅度沿行与列方向均差异显著。 基于此,我们提出 STEPQuant,一个面向 Delta-rule 循环状态的时空后训练量化 框架:按误差幅度与记忆寿命分配精度,并依据状态分布和 key 行对输出误差的影响,联合拟合 key 行与 value 列的缩放因子。 在 Qwen3.8-27B 与 Kimi-Linear-48B-A3B-Instruct 上的长、短生成基准实验表明,STEPQuant 在标称 6-bit 预算下接近 FP32 状态的精度,其 4-bit 配置也优于均匀 INT8。集成到 SGLang 并配合优化的 GPU kernel 后,6-bit STEPQuant 实现 5 倍以上 循环状态压缩,总服务内存最多降低 68.7%。代码开源于 https://github.com/Dreamer-Toby/STEPQuant。
论文精读
TL;DR STEPQuant 针对 Delta-rule 循环状态,按误差生命周期与关键行影响分配量化精度,6-bit 下接近 FP32 精度,实现 5 倍状态压缩并降低 68.7% 服务内存。
问题
问题背景
线性注意力(linear attention)通过将 KV cache 替换为固定大小的递归状态(recurrent state),显著降低了长序列推理的内存增长,但状态本身成为新的内存瓶颈,尤其在并发服务场景下。
现有方法局限
直接对递归状态做低精度量化(如 INT8/INT4)往往导致严重精度损失,因为 量化误差会随状态更新逐步累积。现有统一量化方案忽略两个关键异质性:
- 时间维度:长生命周期记忆单元中的误差会跨多个解码步骤持续放大,而短生命周期单元对误差不敏感。
- 空间维度:不同 key 行对最终输出误差的贡献差异显著,且状态矩阵在行列方向上的数值幅度分布极不均匀。 因此,全局统一 bit 分配或单一缩放因子无法匹配这种时空变化。
为什么这个问题难且重要
递归状态是 持久化且高频更新 的,误差不是一次性的而是具有累积效应,尤其在长文本生成中更为明显。同时,大规模线性注意力模型(如 Qwen3.8-27B、Kimi-Linear-48B-A3B)部署时,状态内存可占整体服务的很大比例,量化是降低显存、提升吞吐的必经之路,但必须保证精度可接受。业界对高效推理的强烈需求,使得如何在有限 bit 预算下最小化状态量化误差成为一个核心挑战。
行业类比
类似于流式计算中,将长期滑动窗口统计量用低精度存储,若不考虑时间衰减和字段重要性,偏差会随数据累积而放大,最终影响实时决策质量。
核心洞察
- STEPQuant 揭示了递归状态量化误差沿时间维度累积的关键性,并基于记忆寿命动态分配比特,而非均匀量化。以往方法通常只按状态幅度或静态敏感度分配精度,忽略了长寿命记忆单元中的误差会在多个解码步中持续放大,导致远期输出严重漂移。STEPQuant 通过估计每行状态的半衰期,对长期记忆分配更高精度,从而在相同平均比特数下显著降低累积误差,这是对递归状态量化误差传播机制的直接建模。
- STEPQuant 发现不同 key 行对输出误差的影响具有高度异质性,因此采用双轴拟合分别学习 key 行尺度和 value 列尺度,而非传统单一标量量化。现有方法通常对整个状态矩阵使用一个缩放因子,忽略了状态幅度沿行、列的非均匀分布,以及某些 key 行可能对注意力输出贡献更大。STEPQuant 通过校准行影响,将量化误差引导到不重要的行,在 4-bit 下即可超越 uniform INT8,实现了低比特下的空间误差重分配。
- STEPQuant 不仅提出量化算法,还集成到 SGLang 推理框架并定制 GPU 内核,在 6-bit 预算下实现超过 5 倍的状态压缩,总服务内存降低高达 68.7%,同时保持与 FP32 状态接近的精度。与大部分量化研究仅报告模型精度不同,这项工作展示了针对递归状态的时空量化如何在实际并发服务中缓解内存瓶颈,验证了低比特状态对长序列生成任务的实用性。
方法
输入
针对 Delta-rule 线性注意力(如 Qwen3.8-27B 与 Kimi-Linear-48B-A3B-Instruct)在解码时维护的固定大小 循环状态(recurrent states)。这些状态在并发服务下占用大量显存,直接量化到低比特会因误差在多次状态更新中传播而导致精度骤降。
关键模块
1. 时间维度:寿命感知位分配(Lifetime-aware Bit Allocation)
观察到误差影响与记忆寿命强相关:长寿命记忆(gate 衰减慢)中的量化误差会跨多个解码步骤持续累积,而短寿命记忆的误差则很快衰减。因此对状态的不同行/列根据其 记忆寿命 动态分配比特位宽,长寿命部分保留更高精度,短寿命部分可更激进压缩。
2. 空间维度:Key-Row 感知双轴拟合(Key-Row-Aware Dual-Axis Fitting)
发现不同 key rows 对最终输出误差的贡献差异显著,且状态幅值沿行与列均存在大幅变化。方法联合拟合 行因子(row factors)与 列因子(column factors),在校准阶段统计状态分布和 key-row 影响力,以加权方式优化缩放系数,从而在量化时保留对输出影响大的行精度,抑制不重要行的误差。
3. 校准与量化写回
使用校准数据统计状态分布、记忆寿命与行影响力,优化位分配和双轴缩放因子,并可能保留少量 FP16 枢轴(pivots)提升精度。解码过程中采用 量化写回,每次状态更新后直接存储量化结果,减少内存和带宽。
输出
生成 6-bit 名义预算下的量化循环状态,集成至 SGLang 自定义 GPU 内核,实现 >5x 状态压缩,总服务内存下降 68.7%。
与同类 PTQ 方法的差异:STEPQuant 显式建模循环状态的时间误差累积与空间行重要性,采用双轴拟合而非单一缩放,在 6-bit 下接近 FP32 精度,其 4-bit 配置即超越均匀 INT8。
实验
实验设计
在 Qwen3.8-27B 与 Kimi-Linear-48B-A3B-Instruct 两个模型上,覆盖长、短生成 benchmarks,验证 PTQ 效果。评估包括:6-bit 预算下与 FP32 状态对比、4-bit 下与 uniform INT8 对比、与 W4 权重量化兼容性、组件消融、生成长度、以及集成 SGLang 后的内存与吞吐。
关键发现
- 6-bit STEPQuant 在长/短任务上精度接近 FP32 状态基线。
- 4-bit STEPQuant 精度超过 uniform INT8 基线。
- 集成 SGLang 后,循环状态压缩 >5x,服务总内存降低最高 68.7%。
与基线对比解读
STEPQuant 的核心优势来自时空感知的位分配与双轴尺度拟合。相比 uniform INT8,它能在更低比特下保持甚至提升精度,证明误差传播建模有效。与 FP32 对比,6-bit 接近无损,验证了 PTQ 方案在 Delta-rule 循环状态上的可行性。SGLang 集成结果进一步表明,该量化方法可落地于高并发推理服务,显著降低内存瓶颈。
行业影响
落地场景
STEPQuant 主要面向采用 线性注意力(Linear Attention)或 Delta-rule 循环状态 的 LLM 服务场景,如 Qwen3.8-27B、Kimi-Linear-48B-A3B-Instruct 等模型。这类模型在长上下文推理和并发请求下,循环状态内存会成为吞吐瓶颈。典型应用包括多轮对话 Agent、长文档摘要、代码库级补全、实时 RAG 等。
具体 use case:
- 电商智能客服 处理长会话时,状态压缩后可支撑更高并发,降低单次交互成本。
- 金融研究平台 批量分析长篇财报、研报,降低每个请求的显存占用,提升单位 GPU 吞吐。
商业价值
核心收益在 降本:6-bit STEPQuant 实现 >5x 循环状态压缩,总服务内存降低最高 68.7%。这意味着同一硬件可承载更多并发请求,直接摊薄推理成本。同时,其在 6-bit 下接近 FP32 状态精度,4-bit 配置超过均匀 INT8,避免量化带来的用户可感知质量下降,保障商业化服务的可靠性。
此外,STEPQuant 可与 W4 权重量化 叠加使用,进一步压缩模型整体内存,为边缘或低成本 GPU 部署提供空间。
与现有产品/工作流的接口
STEPQuant 以 后训练量化(PTQ) 形式提供,无需重新训练,可对接现有量化管线。已集成 SGLang,提供优化 GPU kernel,可直接替换状态存储与更新逻辑。
集成路径:
- 从 Hugging Face 加载线性注意力模型。
- 使用 STEPQuant 校准状态码本与缩放因子。
- 导出量化配置,在 SGLang 运行时启用 packed-state 模式。
与其他推理框架(如 vLLM、TensorRT-LLM)的适配可参考 SGLang 实现,状态池内存管理可直接复用现有 KV cache 分配策略。
局限
- - 方法特化于 Delta-rule 线性注意力架构,依赖其显式的状态更新规则与读出机制进行时空误差建模。对于其他线性注意力变体(如基于 softmax 或核函数的线性注意力),状态更新方式不同,误差传播模式可能不适用,导致方法无法直接迁移。论文未验证在其他线性注意力模型上的泛化能力。
- - 校准过程需统计关键行影响、状态分布等数据,这些统计量对校准数据的选择较为敏感。如果实际推理数据分布与校准数据差异较大,分配到的位宽与双轴尺度可能失配,导致量化精度下降。论文未系统分析校准数据多样性或分布偏移对最终性能的影响。
- - 集成到 SGLang 的内核优化可能针对特定 GPU 型号与 batch size 调优,在更广泛的硬件或部署配置下通用性存疑。论文重点展示了内存压缩收益与部分吞吐数据,但缺乏对端到端延迟、不同 batch size 下性能波动以及多 GPU 扩展性的全面评估,实际部署效果仍需进一步验证。