面向长时程自回归视频生成的 Rollout-Marginal Distillation
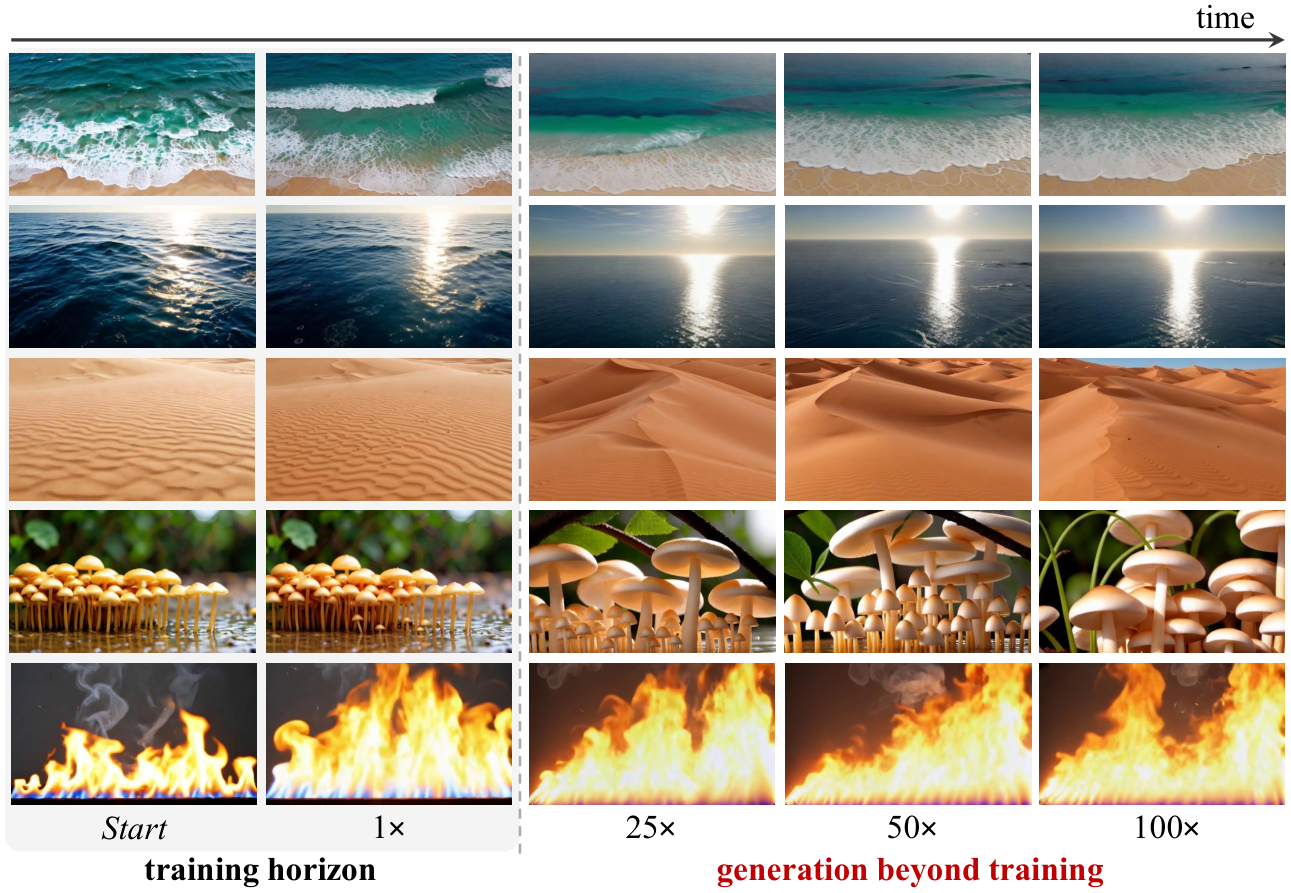
Autoregressive (AR) 视频扩散支持低延迟、可流式的视频生成,但预测误差会在长 rollout 中不断累积。让生成器在自己的 rollout 上训练,可使其暴露于这些不完美的历史之中。然而,现有的视频级 distribution matching distillation (DMD) 会对整段 rollout 联合打分:由于某个 chunk 是与其过去和未来一起被评估的,它的修正可能为了维持时序一致性而偏向匹配周边上下文中的伪影。 为提供更清晰的视觉质量信号,本文提出 Rollout-Marginal Distillation (RMD)。RMD 在 AR 预测时仍保留生成的历史,但对每个 chunk 独立地与 chunk teacher 打分,从而保证其质量修正不被不完美的时序上下文所干扰。为弥补独立 chunk 打分缺失的时序上下文,RMD 随后再施加视频级 DMD 以恢复时序连贯性。 大量实验表明,RMD 能在远超其训练时程的范围外维持高视觉质量,并优于视频级 DMD 基线。代码与视频结果见 https://cjeen.github.io/RMD 。
论文精读
TL;DR 提出 Rollout-Marginal Distillation (RMD):自回归视频生成中先独立评估每个 chunk 的视觉质量,再联合优化时序一致性,从而在长序列生成中抑制误差累积、保持高画质。
问题
问题背景
自回归(AR)视频扩散模型因支持低延迟、流式生成,成为长视频生成的主流路线之一。核心关注点在于如何在逐 chunk 扩展生成时,控制预测误差累积,保持长时程视觉质量。
现有方法局限
现有视频级分布匹配蒸馏(video-level DMD) 对整个 rollout 联合评分。由于每个 chunk 与过去和未来的上下文一起评估,纠正信号会偏向保持时间一致性,反而可能匹配周围上下文中的伪影,牺牲该 chunk 自身的视觉质量。训练时,模型无法清晰区分“区块自身质量问题”与“时序上下文不足带来的问题”,导致长 rollout 下的局部失真被掩盖或强化。
为什么这个问题难/重要
独立评分每个 chunk 能提供干净的视觉质量信号,但会失去时序上下文,导致生成不连贯;联合评分能维持连贯性,却引入上下文依赖的噪声梯度。这一矛盾使长时程 AR 生成难以在质量与一致性之间取得平衡。该问题直接决定流式视频生成、自动驾驶仿真、物理视觉模拟等应用的可用性,因为这些场景需要持续生成高质量视频帧,误差累积会迅速破坏场景合理性。
行业类比
类似流式视频服务中,每个编码片段(chunk)独立质检可确保画质,但若脱离前后片段联合优化,可能引入转场跳变;RMD 相当于先逐片段质检,再做整体转场平滑。
核心洞察
- RMD 将自回归视频扩散的蒸馏目标从整个 rollout 联合评分解耦为每个 chunk 的独立边际评分,打破了现有 video-level DMD 中 chunk 质量校正与时间一致性之间的耦合困境。在视频级 DMD 中,一个 chunk 的梯度同时受到过去和未来 chunk 的影响,为了保持整体时间一致性,模型可能会选择匹配周围上下文中的伪影,从而牺牲该 chunk 自身的视觉质量。RMD 通过只对当前 chunk 与教师模型进行分布匹配,排除了不完美的历史/未来上下文的干扰,使每个 chunk 的质量校正信号更加纯粹,针对自回归生成的误差累积特性提供了更精细的监督。
- RMD 在独立 chunk 评分之后,再引入 video-level DMD 作为第二阶段,以恢复因独立评分而缺失的时间上下文信息,形成“先质量后一致性”的两阶段蒸馏策略。独立评分虽然提升了每个 chunk 的视觉质量,但忽略了 chunk 之间的时序关系,可能导致生成视频在边界处不连贯。RMD 通过后续的视频级 DMD 在整体 rollout 上微调,确保生成序列在长时域上既保持高视觉质量又具备时间一致性。这种两阶段方式明确分离了“局部质量”与“全局一致性”两个目标,使得模型在长时生成中能够兼顾二者,实验表明其性能超越了仅用视频级 DMD 的基线。
方法
方法核心:Rollout-Marginal Distillation
输入与生成流程
自回归视频扩散模型按块生成,每个新块以上文历史为条件。RMD 的训练从模型自身 rollout 获得不完美历史,但不对完整序列做联合评分。
关键模块一:边际评分
针对当前块,RMD 将其与历史上下文解耦,使用独立的 chunk teacher 对该块单独打分,构造 rollout-marginal 目标。这一设计避免了视频级 DMD 中常见的耦合困境:当块与前后帧一同评估时,为维持时间一致性可能错误地匹配上下文中的伪影,牺牲局部视觉质量。RMD 只关注当前块的真实性与清晰度,从而提供更纯粹的质量信号。
关键模块二:视频级精炼
由于边际评分忽略了时间上下文,可能损伤块间连贯性。RMD 在边际蒸馏之后追加 video-level DMD 阶段,对完整 rollout 做二次蒸馏,以恢复时序一致性。两部分训练交替或顺序进行,最终模型既能保持长时程稳定性,又能显著提升视觉质量。
输出与效果
训练后的生成器在远超训练 horizon 的长序列上仍维持高质量,优于传统视频级 DMD 基线。RMD 与同类方法的本质差异:它显式分离“单块质量修正”与“全局时间一致性恢复”,解决了联合评分带来的伪影耦合问题。
实验
实验设计
RMD 在 AR 视频扩散模型上训练,生成器基于自身 rollout 历史预测每个 chunk,但每个 chunk 由独立的 chunk teacher 单独评分,构成 rollout-marginal objective;随后再施加 video-level DMD 以恢复时序连贯性。实验包含三部分:
- 与 video-level DMD 等基线的定量对比
- 长时域外推测试(远超训练时域)
- 消融验证 rollout-marginal objective、video-level DMD refinement 以及 asymmetric denoising exits 的有效性
关键发现
- RMD 在远超训练 horizon 的长序列生成中保持高视觉质量,显著优于 video-level DMD 基线。
- 独立 chunk 评分避免了 chunk 为了匹配周围上下文伪影而牺牲自身质量,提供了更清晰的视觉质量监督信号。
- 第二阶段 video-level DMD 精调有效恢复了因独立评分而缺失的时序连贯性,证明两阶段策略互补。
与基线对比解读
现有 video-level DMD 对整个 rollout 联合打分,将 chunk 与其过去和未来捆绑评估,导致质量修正可能偏向于维持上下文的一致性而非提升 chunk 本身的视觉质量。RMD 通过边缘化 rollout 的评分方式,将每个 chunk 的视觉质量从时序上下文中解耦,使得梯度信号更直接地指向 chunk 本身的生成质量。这种设计在长时域滚动生成中尤为关键,因为累积误差会被逐 chunk 放大。然而,完全独立的 chunk 评分会破坏时序一致性,因此后续的视频级 DMD 精调作为全局一致性约束是必要补充。实验证明该两阶段组合在长时域外推上优于单阶段 video-level DMD,说明解耦局部质量与全局连贯性的训练策略更能抵抗误差累积。
行业影响
落地场景
Rollout-Marginal Distillation (RMD) 主要赋能需要长时程、流式生成的视频应用。典型场景包括:
- 自动驾驶仿真:生成连续、长距离的驾驶场景视频,训练感知与规划模型,RMD 能显著降低长 rollout 的累积误差。
- 内容平台与电商:自动生成完整产品展示视频、虚拟主播直播切片,或教育领域的长时间教学动画。
- 游戏与影视预演:快速生成连贯的过场动画或预览片段,支持迭代创作。
商业价值
RMD 的直接价值在于降低长视频生成的重生成成本。传统 AR 视频生成在数百帧后质量明显下降,导致需要多次采样筛选或人工修复。RMD 将视觉质量保持到远超训练时长,可将一次生成成功率提升,减少推理消耗与人工纠错。同时,稳定的长视频质量改善用户体验,支撑内容平台的个性化视频广告、虚拟人直播等商业化产品,带来可观的增收空间。
与现有产品 / 工作流的接口
RMD 作为训练期蒸馏技术,不改变推理架构,可无缝集成到现有 AR 视频扩散模型(如 Wan、HunyuanVideo 等)的训练流水线。工程上,只需替换或级联使用 video-level DMD 损失为 rollout-marginal 损失,并保留原有的 chunk 教师模型。推理侧无需额外开销,因此部署成本低。代码已开源(GitHub),可直接适配自定义模型。
局限
- **训练流程复杂度较高**。RMD 需要先进行 rollout-marginal 蒸馏(chunk 独立评分),再额外进行视频级 DMD 细化,涉及多个教师模型和损失项。这增加了训练时间、显存开销及超参数调节难度。论文未对比单阶段方法的效率,也未讨论不同 chunk 长度或退出策略对训练稳定性的影响,实际部署时需在训练成本与生成质量间进行取舍。
- **泛化能力与模型依赖**。实验主要在特定基座模型和数据集上验证,长时域评估虽然远超训练时域,但并未探索极限长度下的性能衰减。方法依赖预训练 chunk teacher 的质量,若 teacher 本身在长时域上有偏,蒸馏结果将受限于其能力。与更广泛的 AR 视频生成方法(如直接长时域训练或其他蒸馏变体)缺少系统对比,泛化性仍有待检验。
- **时间一致性与视觉质量的权衡**。RMD 通过独立 chunk 评分强化视觉质量,但可能削弱全局时间连贯性。尽管后续视频级 DMD 尝试恢复,两阶段优化仍可能陷入局部权衡,对于需要强因果一致性的应用(如物理仿真、具身交互)可能产生不自然的跳变。论文未定量分析时间一致性指标(如光流平滑度、语义连续性),也未与专门增强时间一致性的方法直接对比。