通过逆向蒸馏实现数据遗忘
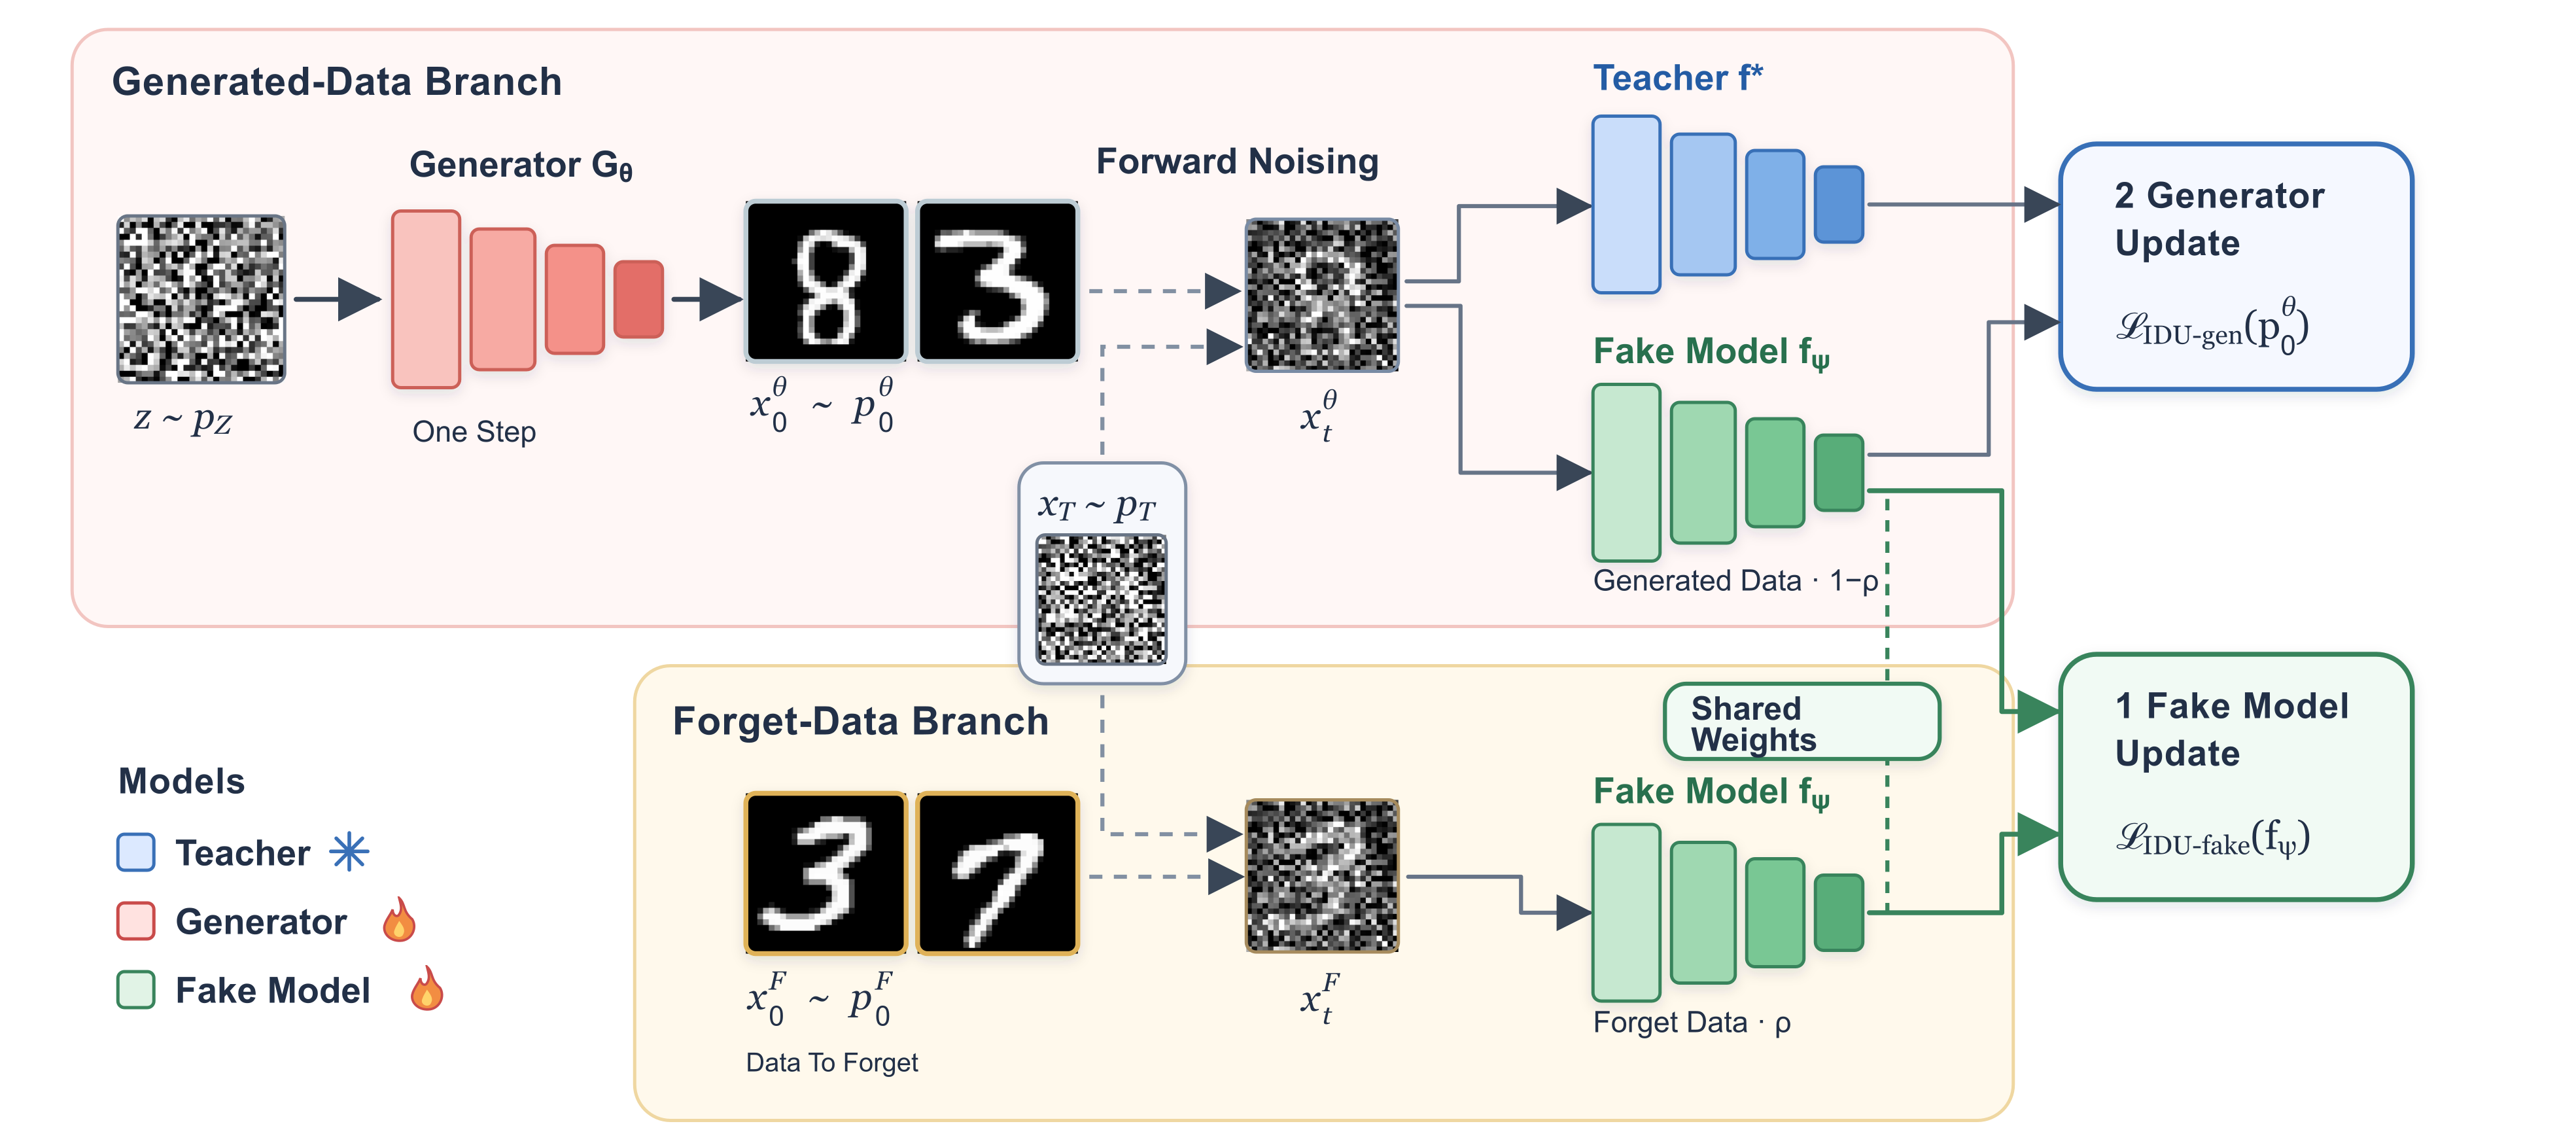
多步匹配模型 (包括 flow matching 与 diffusion 模型) 能生成高质量结果,但推理开销大,且可能复现训练数据中不希望出现的成分。为此,作者提出 Inverse Distillation Unlearning (IDU) ,一个统一框架:在将教师多步匹配模型蒸馏为高效一步学生生成器的同时,抑制对应指定训练子集的输出。 方法上,作者先把蒸馏建模为数据分布上的 min-max 目标,再将该分布表示为 forget set 与生成分布的混合,从而可与教师训练分布比较,并在最优点仅恢复保留数据。 该方法的显著优势在于: - 仅需一个在全量数据上预训练的教师模型,以及 forget set 的数据; - 无需访问保留训练样本,也不需要额外的特征提取器或分类器。 实验在 MNIST 与 CIFAR-10 上进行,涵盖 flow-matching 与 score-based diffusion 两种设定。结果表明,IDU 在显著降低被遗忘类别生成频率的同时,保持了保留类别的生成质量。据作者所知,IDU 是首个在无条件 flow-matching 与 score-based 模型中同时实现遗忘与蒸馏的统一框架。
论文精读
TL;DR IDU 首次统一数据遗忘与一步蒸馏:仅用预训练 teacher 和 forget set,即可将多步 flow/diffusion 模型压缩为单步生成器,同时抑制指定训练子集的输出,无需保留数据或额外分类器。
问题
问题背景
多步匹配模型(flow matching、score-based diffusion)已在图像生成中达到高质量,但推理需多次前向、成本高,且可能复现训练集中敏感或过时样本。
现有方法局限
当前工作通常将蒸馏与数据遗忘分开处理:蒸馏方法(如 SFD)构建单步学生模型但保留全部数据分布;遗忘方法(如 SA、SalUn)依赖保留数据、额外分类器或微调,且不适用于无条件生成或一步模型。二者缺乏统一框架,难以在降低推理成本的同时抑制特定训练子集。
为什么这个问题难/重要
挑战在于:遗忘目标与生成质量天然冲突——过度压制遗忘类会损害其他类的多样性,而单步模型容量有限,难以同时拟合保留分布。此外,实际场景中通常只有遗忘集可用,无法访问保留数据,这限制了基于数据重训练或微调的方法。业界对高效生成与隐私合规的需求同时上升,需要轻量级、无分类器、无保留数据的方法。
行业类比
在定制化图像生成服务中,既要单步快速出图,又要从模型中移除用户投诉或版权受限的素材,类似模型敏捷合规与推理降本必须同时实现。
核心洞察
- 将数据遗忘形式化为逆向蒸馏的分布匹配问题:IDU 把教师训练分布视为保留集分布与遗忘集分布的混合,学生通过 min-max 目标逼近教师分布中的保留成分,同时最小化遗忘集分布的重现。这一角度与现有 unlearning 方法不同,后者通常需要在模型权重上施加梯度更新或依赖辅助分类器,而 IDU 仅在蒸馏目标中对生成分布进行约束,无需访问保留训练样本,实现了单步生成器上的分布级遗忘。
- 统一了蒸馏与遗忘:在 flow-matching 和 score-based diffusion 两种主流多步匹配模型下,IDU 是首个同时完成一步蒸馏和指定子集遗忘的框架。相比分别做蒸馏再遗忘的两阶段方案,联合优化避免了遗忘步骤对已蒸馏模型质量的破坏,并在 MNIST/CIFAR-10 上证明可显著降低遗忘类生成频率且保持保留类生成质量,为部署高效且符合数据治理要求的生成模型提供了新路径。
方法
输入与目标
IDU 接收三类输入:
- 预训练的多步教师模型(flow-matching 或 score-based diffusion),其训练分布记为
p_teacher; - 需要遗忘的数据子集(遗忘集
D_forget),例如特定类别样本; - 待训练的单步学生生成器
G(通常用教师初始化或随机初始化)。
目标是训练 G,使其生成分布 p_G 满足:去除遗忘集影响后的保留分布。
关键模块:混合分布与 min-max 匹配
IDU 的核心是构造一个混合分布 p_mix = α·p_G + (1-α)·p_forget,其中 p_forget 是遗忘集的经验分布,α 是混合权重。
然后定义分布距离(如积分概率度量),并形式化为一个 min-max 目标:学生生成器最小化 p_mix 与 p_teacher 的距离,而判别器(或 critic)最大化该距离以提供梯度信号。
- 当优化至最优时,
p_mix = p_teacher,因此p_G = (p_teacher - (1-α)·p_forget)/α,即学生生成分布恰好是教师分布减去遗忘集成分后的保留分布。 - 该过程称为逆蒸馏:不是从教师输出直接蒸馏,而是通过反向混合抵消遗忘数据的影响。
输出与训练要点
训练完成后,G 是一个单步生成器,推理时只需一次前向,生成质量接近多步教师但不再包含遗忘类别。
- 无需访问保留训练样本,无需额外分类器或特征提取器。
- 适用于 flow-matching 与 score-based diffusion 两种主流匹配模型。
与同类方法的差异
与现有机器遗忘方法(如梯度修正、权重扰动)不同,IDU 将蒸馏与遗忘统一在一个分布匹配框架中,且是首个针对无条件 flow-matching 和 score-based 模型的同时遗忘与蒸馏方法。
实验
实验设计
IDU 在 MNIST 和 CIFAR-10 上验证,覆盖 flow-matching 与 score-based diffusion 两种生成框架。实验使用预训练全量教师模型,仅给定 forget set 数据,蒸馏一步学生生成器同时执行遗忘。评估指标包括遗忘类别生成频率、保留类别 FID 及分类准确率。
关键发现
IDU 大幅降低遗忘类别的生成频率,同时保留类别生成质量接近教师或 fine-tune 基线。作者强调该方法是首个在无条件 flow-matching 与 score-based 模型中同时实现 unlearning 与蒸馏的统一框架,且无需访问 retained 数据或额外特征提取器。
基线对比解读
与传统 unlearning 方法(如 fine-tuning、classifier-guided)相比,IDU 避免了保留数据依赖与额外分类器开销;与纯蒸馏方法相比,其 min-max 目标显式建模 forget-set 混合分布,理论上在最优解处恢复仅保留数据的分布,从而兼顾效率与隐私合规。
行业影响
落地场景
IDU 适用于需要生成模型遗忘 与高效推理 并存的业务:如 AI 图像生成服务需删除版权内容或敏感类别(人脸、医疗影像),同时保持其他生成能力;内容平台需移除特定风格或用户数据;电商商品图生成需去除品牌 logo 后仍快速产出。典型 use case:医疗影像生成中剔除某患者数据以符合隐私法规,但不损失疾病特征;数字艺术平台删除侵权风格。
商业价值
降本:蒸馏至一步生成器大幅降低推理算力,相比多步扩散模型成本下降数倍;增收:合规遗忘能力帮助进入强监管市场,避免罚款与诉讼;体验提升:一步生成带来更低延迟,适合实时交互场景。IDU 无需保留训练集,仅需遗忘集和教师模型,显著降低存储与合规成本。
与现有工作流接口
可作为后训练工具 接入现有模型生产线:已有全数据教师模型时,直接以遗忘集运行 IDU 得到一步学生模型,无需重训或额外分类器。兼容 flow matching 与 score-based diffusion。可集成到 MLOps 中作为模型更新步骤,与现有蒸馏框架(如 progressive distillation)并行或替换。
局限
- 实验规模与任务类型有限:论文仅在 MNIST 和 CIFAR-10 两个小规模数据集上验证了无条件生成场景,未涉及更高分辨率图像或条件生成(如文本到图像)。因此,IDU 在大规模扩散模型上的可扩展性、内存与计算开销、以及蒸馏后学生模型在高维复杂分布上的保真度仍未得到检验。这限制了该方法在工业级生成模型中的直接可部署性。
- 方法依赖 forget set 数据的数量与质量:IDU 需要从忘记集采样来构造混合分布,因此对 forget set 的代表性较敏感。在概念级遗忘或数据子集难以精确界定时,可能无法获得充分样本,导致欠遗忘或过遗忘。同时,遗忘权重 ρ 需手动调节,论文仅展示了部分类别下的灵敏度分析,未提供自动选择或鲁棒的超参数策略,实际使用时需要额外调参成本。
- 蒸馏到 one-step student 可能引入容量瓶颈:学生生成器需同时完成蒸馏与遗忘,单步模型的表达能力上限低于多步 teacher,可能导致保留类别上的生成质量(如 FID)与 teacher 仍有差距。论文未通过消融实验分离遗忘约束与蒸馏容量限制对质量损失的影响,也未与单独蒸馏或单独遗忘的强基线进行充分对比,难以判断性能下降的主要原因。