校正何时成为修复?工具使用型 LLM 内部干预的机制审计
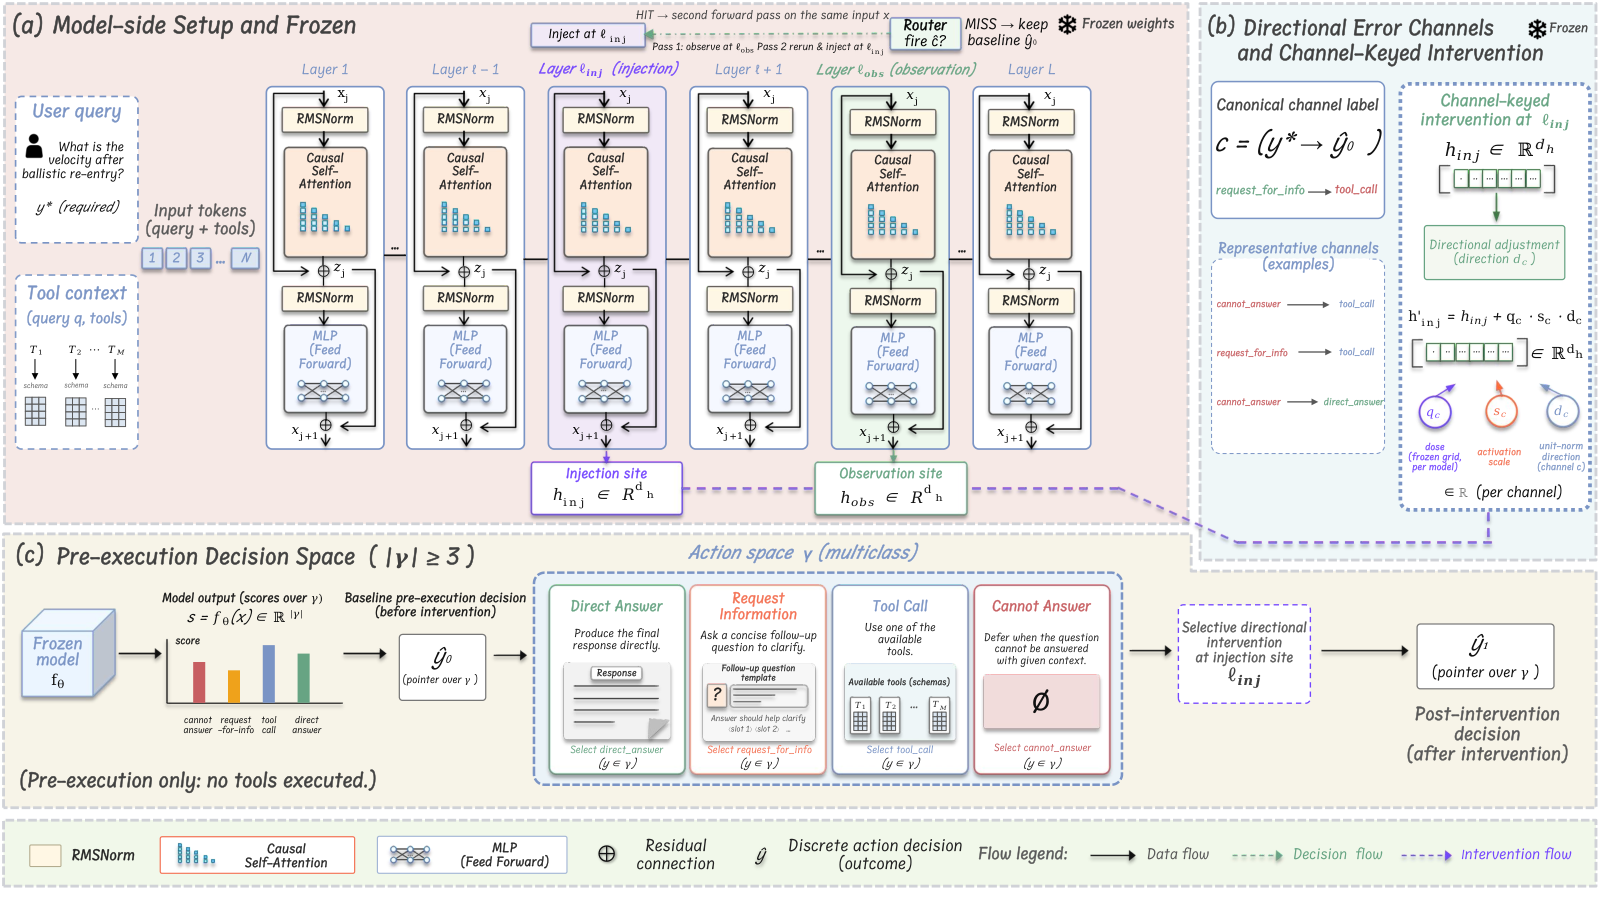
在调用外部工具之前,agentic LLM 必须在 K 路动作空间中做出选择:执行调用、请求澄清、直接作答或拒绝。虽然内部激活操控可以改变这些执行前决策,但传统的聚合指标掩盖了被改变的状态最终落在何处,以及它们造成了哪些附带损伤。 我们提出 SAKIKO,一个审计框架,将表征修复形式化为四个环节:方向性错误发现、router 条件干预、目的地解析验证,以及前瞻性冻结的统计许可。在 When2Call 与 MetaTool 上的七个 LLM 中,通道键控干预在五个模型上带来方向特定的净收益;在三项密封评估中,59 个预算匹配的随机方向无一能匹配校准后的目标增益。 关键在于,目的地审计表明行为移动并不等于修复:一个取得 +55 净增益的干预,会破坏其触及的、原本基线正确的决策中的一半以上;而 Qwen3-4B 与 Gemma-2-9B 上看似有前景的点估计,则因有限样本不确定性被正式否决。SAKIKO 确立了在声称内部修复之前,必须进行结果解析裁决。代码:https://github.com/ruizheliUOA/mechanistic-tool-use-llm。
论文精读
TL;DR SAKIKO 审计框架揭示工具调用 LLM 的内部干预行为变化不等于修复,+55 net gain 会破坏过半原本正确决策,强调目的地解析与统计许可的必要性。
问题
问题背景
Agentic LLM 在调用外部工具前需从 K 路动作空间中做出选择(执行调用 / 寻求澄清 / 直接回答 / 拒绝),该前置决策的可靠性直接决定下游工具使用效果。内部激活操控(activation steering)被视为纠正这类决策的潜在手段。
现有方法局限
- 聚合指标失真:以往研究仅报告干预前后的净增益(net gain)或准确率变化,将多类结果压缩为二值,无法揭示干预后状态实际落在哪个动作类别,也无法区分“有益修正”与“附带损伤”。
- 随机对照不足:常用随机方向作为对照,但随机方向与目标方向近正交,无法校准真实的特异性增益;且点估计(point estimate)常因有限样本偏差被过度解读。
- 行为移动≠修复:干预可能将部分基线正确决策推向错误类别,但聚合指标掩盖了这种破坏性偏移,导致仓促宣称“representation repair”成功。
为什么这个问题难且重要
- 技术挑战:内部干预是黑箱操作,需分离方向性错误发现、路由条件干预、目的地解析验证三层逻辑,并引入前瞻性冻结统计许可(prospectively frozen statistical licensing)控制有限样本误差。
- 业界关注:若部署后干预破坏原本正确的行为,会引发工具调用链中的系统性风险;因此必须建立结果解析式审计,将“修正”严格限定为“目标命中且不损害已正确决策”。
行业类比
类似药物研发中的靶点验证:仅凭总体症状改善不足以证明药物有效,还需确认作用于病灶且无严重副作用——AI agent 内部干预的审计就是在验证“修复”是否精准且安全。
核心洞察
- 目的地审计揭示“行为移动”不等同于“修复”。传统聚合指标(如净增益)只能看到干预后决策分布的整体变化,无法区分模型被正确引导还是被错误腐蚀。SAKIKO 引入 destination-resolved verification,将每个干预样本映射到五种结果类别,发现 +55 净增益的干预实际破坏了超过一半原本正确的决策。这直接挑战仅凭净收益宣称内部修复的同类工作,奠定 outcome-resolved 判定标准。
- 前瞻性冻结的统计许可作为内部干预的“发布门禁”。与事后选择最佳方向不同,SAKIKO 在评估前预先注册许可标准,结合有限样本不确定性进行假设检验,导致 Qwen3-4B 和 Gemma-2-9B 上表面可观的点估计被正式拒绝。这种统计严谨性防止小样本下的过度乐观,证明仅靠点估计不足以声称修复成立,为工程落地提供更稳健的验证协议。
方法
输入与问题定义
SAKIKO 接受一个 agentic LLM 在工具调用前的 K 路动作空间(执行调用 / 寻求澄清 / 直接回答 / 拒绝),以及验证集上的动作标注。目标是对内部激活干预进行审计,判断其是否构成真实修复。
关键模块
- Discover(通道构建):从模型内部激活中定位与动作选择相关的通道(channel),用于后续干预。
- Support(资格鉴定):在干预前用 Router 判断样本是否属于可修正的错误群体,确保干预有针对性。
- Detect(观测点与 Router):在不同层选择观测位置,训练一个 Router 识别模型当前是否倾向错误动作。
- Estimate(方向估计):利用梯度 / 目标轴估计、DiffMean 或 PCA-1 等方法,从错误与正确动作群体的激活差异中提取干预方向。
- Intervene(激活操控):在选定通道上施加沿方向的加性扰动,观测行为变化。
- Destination-resolved Verification(目的地解析验证):将干预后的行为按结果分类(目标命中、正确保持、纠错失败、附带损伤等),避免仅看净收益。
- Licensing(前瞻冻结许可):使用预先冻结的统计门槛,判断干预在有限样本下是否能通过校验,防止乐观估计。
输出
输出是一份审计判定:干预是否构成 repair,还是仅为 correction;若证据不足则拒绝许可。
与以往只报告平均行为变化的激活操控工作不同,SAKIKO 将“干预后动作落在哪个目的地”与“统计许可”作为核心,从而区分表面纠正与真实修复。
实验
实验设计
研究在 When2Call 和 MetaTool 两个工具调用数据集上,对 7 个 LLM 进行内部激活干预。通过 SAKIKO 框架实施四步流程:方向发现(梯度/目标轴、DiffMean、PCA-1)、路由器条件干预、目的地解析验证、前瞻性统计许可。对照组为 59 个预算匹配的随机方向。评估指标采用目的地解析(destination-resolved)而非传统聚合指标,以区分行为移动与真实修复。
关键发现
- 在 7 个模型中,5 个模型出现方向特异性净增益;
- 在三个密封评估中,59 个随机方向无一匹配校准目标增益,证明干预效果非随机;
- 目的地审计揭示行为移动不等于修复:一个净增益 +55 的干预损坏了超过一半的基准正确决策;
- Qwen3-4B 和 Gemma-2-9B 的点估计因有限样本不确定性被正式拒绝许可。
与基线对比
与仅依赖聚合准确率变化的传统激活操控研究相比,SAKIKO 的随机方向对照表明定向信号真实存在,但 净增益本身不足以证明修复。通过目的地解析和损伤比例量化,SAKIKO 揭示了干预的附带损害,避免了将行为移动误认为全面改善。该方法为 agentic LLM 的内部干预审查建立了更严格的裁决标准。
行业影响
落地场景
SAKIKO 提供了一种审计 agentic LLM 内部干预有效性的方法论,适用于所有依赖工具调用的高风险场景。例如:
- 电商智能客服:模型需要选择调用商品搜索、订单查询或转人工。内部激活干预可能被用于降低误调用率,但 SAKIKO 能验证干预是否在修复错误的同时破坏原本正确的决策。
- 金融合规 Agent:调用交易查询、风控工具前,内部 steering 可以限制敏感操作,但需要 destination-resolved verification 确保干预不会造成 collateral damage。
商业价值
论文揭示核心问题:净增益 (net gain) 指标会掩盖 collateral damage,例如 +55 net gain 的干预可能破坏超过一半原本正确的决策。直接商业价值在于:
- 降本:减少因错误工具调用导致的 API 费用、人工介入成本和业务损失。
- 风险控制:在部署前通过 SAKIKO 的统计许可 (statistical licensing) 避免不可靠干预进入生产,降低合规风险。
- 体验提升:减少模型在应该澄清或回答时错误调用工具带来的用户困扰。
与现有产品 / 工作流的接口
SAKIKO 可作为 LLM 部署流水线中的审计层,集成方式:
- 在模型验证阶段,对候选干预方向运行 SAKIKO 的四个步骤:directional error discovery、router-conditioned intervention、destination-resolved verification、prospectively frozen statistical licensing。
- 与现有 monitoring 工具(如 LangSmith、Arize)结合,将 destination-resolved 指标加入持续监控面板。
- 在 A/B 测试前用 SAKIKO 预筛选内部干预候选,避免直接上线后才发现副作用。
局限
- 论文承认其**前瞻性统计许可**过于保守:在 Qwen3-4B 与 Gemma-2-9B 上出现正向点估计,却因有限样本不确定性被正式拒绝,说明该框架可能漏报真实修复。评估仅覆盖 When2Call 与 MetaTool 两个工具调用决策数据集,动作空间为 4 选 1 或二元,缺少多步工具调用、并行 API 调用、长程规划等更复杂的 agent 场景,外部效度有限。
- 干预机制依赖**线性激活操控**与**路由器**,假设通道键控方向在隐藏状态上近似线性可分且可迁移;近期研究指出 LLM 内部工具选择可能涉及非线性回路和跨层交互,单一通道方向的稳态假设可能不成立。此外,论文只验证了 channel-keyed 方式,未比较其他表示编辑方法(如非线性探测或 SAE 稀疏特征干预),方法普适性受限。
- 相比直接行为微调或外部 guardrail,SAKIKO 的**离线构建成本**较高:需要训练路由器、计算多种方向估计器(`d_grad`、`DiffMean`、`PCA-1`)并在剂量网格上扫描,还需冻结统计许可与密封评估,工程落地门槛明显。实验仅覆盖 7 个 decoder-only 模型,未测试 encoder-decoder 或 MoE 架构,也未讨论在线部署时的延迟与反馈回路。