FactorEngram:面向语言模型的基级门控分解式 N-gram 记忆
基于查表的记忆机制为扩展 LLM 参数规模提供了一条有前景的路径:它直接检索局部 token 模式(如 n-gram)已学到的表示,而非通过逐层计算重新构建。然而,现有设计(如 Engram) 把每个检索到的 embedding 当作单一整体——每个 embedding 存放于各自的哈希槽,并由单个标量门控调制。这导致多义模式无法选择性地读取与上下文相关的记忆成分;同时参数共享仅通过哈希冲突实现,与语义基本无关。 我们提出 FactorEngram,一种带基级上下文门控的分解式 n-gram 记忆。它在跨模式共享的基向量字典上检索稀疏正则化系数,使相关模式能够复用公共成分,且同一字典也用于门控。骨干网络的隐状态会与每个基向量打分,在重建前对相应系数进行门控,从而让上下文可以单独调制每个记忆成分。FactorEngram 同时覆盖单个 token 与多 token 的 n-gram,并系统研究了记忆分支应插入的位置。 在 340M 与 1B 参数量的 Transformer 骨干上,FactorEngram 提升了语言建模与下游任务表现。消融实验验证了各组件的贡献,并确认将记忆插入中间层的注意力子层之前是一种有效配置。
论文精读
TL;DR **FactorEngram** 将 n-gram 记忆分解为共享 basis 字典的稀疏系数,并通过 basis-level 门控让上下文选择性读取相关成分,解决 Engram 将 embedding 视为整体、无法处理多义模式的问题,在 340M/1B 模型上提升语言建模与下游任务。
问题
问题背景
当前 LLM 参数扩展中,lookup-based memory 作为辅助分支直接检索局部 token 模式(n-gram)的表征,避免逐层重建,已在 Gemma 3n、Engram 等架构中得到探索。
现有方法局限
以 Engram 为代表的实现把每个检索到的 n-gram embedding 视作整体单元:每个 embedding 独立占哈希槽,由单一标量门控调制。主要局限:
- 多义模式不能按上下文选择读出相关分量;
- 参数共享仅通过哈希碰撞实现,碰撞关系与语义无关,相似模式无法稳定复用公共子空间。 标量门控表达力不足以区分上下文对同一嵌入内部多个语义成分的调节需求,导致存储冗余、检索不精确。
为什么难/重要
挑战在于:n-gram 记忆既要紧凑(避免每个模式独立大向量、参数爆炸),又要上下文敏感(同一模式在不同语境下应激活不同语义成分)。逐槽标量门控和离散哈希共享难以同时满足。DeepSeek-V4.1-Flash 等已采用 Engram,说明该方向具备实际部署价值;但现有设计在参数效率与语义路由上存在瓶颈。
行业类比
类似推荐系统中 item embedding 表需要按用户上下文动态选择兴趣维度,语言模型中的 n-gram 记忆也需要按上下文动态路由到公共语义基底,而不是整条读出。
核心洞察
- - FactorEngram 的核心贡献是将 n-gram memory 因子化为共享 basis 向量的稀疏组合,使模式间能按语义共享组件,而非通过无关的哈希碰撞。这一设计打破了 Engram 等方案中每个 embedding 独立存储、共享仅靠随机冲突的局限;稀疏字典允许不同 n-gram 复用相同 basis,不仅显著提升参数效率,也增强了多义词表示的语义对齐能力。
- - FactorEngram 提出 basis-level gating,用 backbone 隐藏状态对每个 basis 系数进行上下文相关的选择性调制,取代 Engram 对整个 embedding 的标量门控。这使记忆输出不再是静态 n-gram 表示,而是根据上下文动态组合的组件,有效解决多义词消歧(如 'bank' 在金融与河岸场景下激活不同 basis),突破了标量门控无法区分记忆内部语义维度的瓶颈。
方法
输入
FactorEngram 接收 backbone 的 hidden state,并对局部 token patterns(单个 token 与多 token n-grams)通过哈希索引定位记忆条目。
关键模块
1. 稀疏字典系数检索
不再为每个 n-gram 存储独立 embedding,而是维护一个跨 patterns 共享的 basis 字典。检索过程输出该 pattern 在字典上的稀疏系数,使语义相近的 patterns 能复用共同的基底组件。
2. Basis-Level 门控
用同一个 basis 字典对 backbone hidden state 进行打分:将 hidden state 与每个 basis vector 计算相关性得分,作为门控权重,逐组件调制检索到的系数。这允许上下文有选择地放大或抑制记忆的不同维度,解决一词多义问题。
3. 字典重构与集成
将门控后的系数对 basis 字典加权求和,重构出记忆输出向量,再注入 backbone 的指定位置(实验表明插入 middle layers 的 attention sublayer 之前效果最佳)。
训练目标
除语言建模损失外,加入稀疏正则化,强制检索出的系数稀疏,降低计算与存储开销,同时提升可解释性。
差异点
与 Engram 等 monolithic 记忆设计相比,FactorEngram 通过因子化字典与基底级门控,实现了跨 pattern 的语义级参数共享与上下文驱动的组件选择性读出,而非仅依赖哈希碰撞的偶然共享。
实验
实验设计
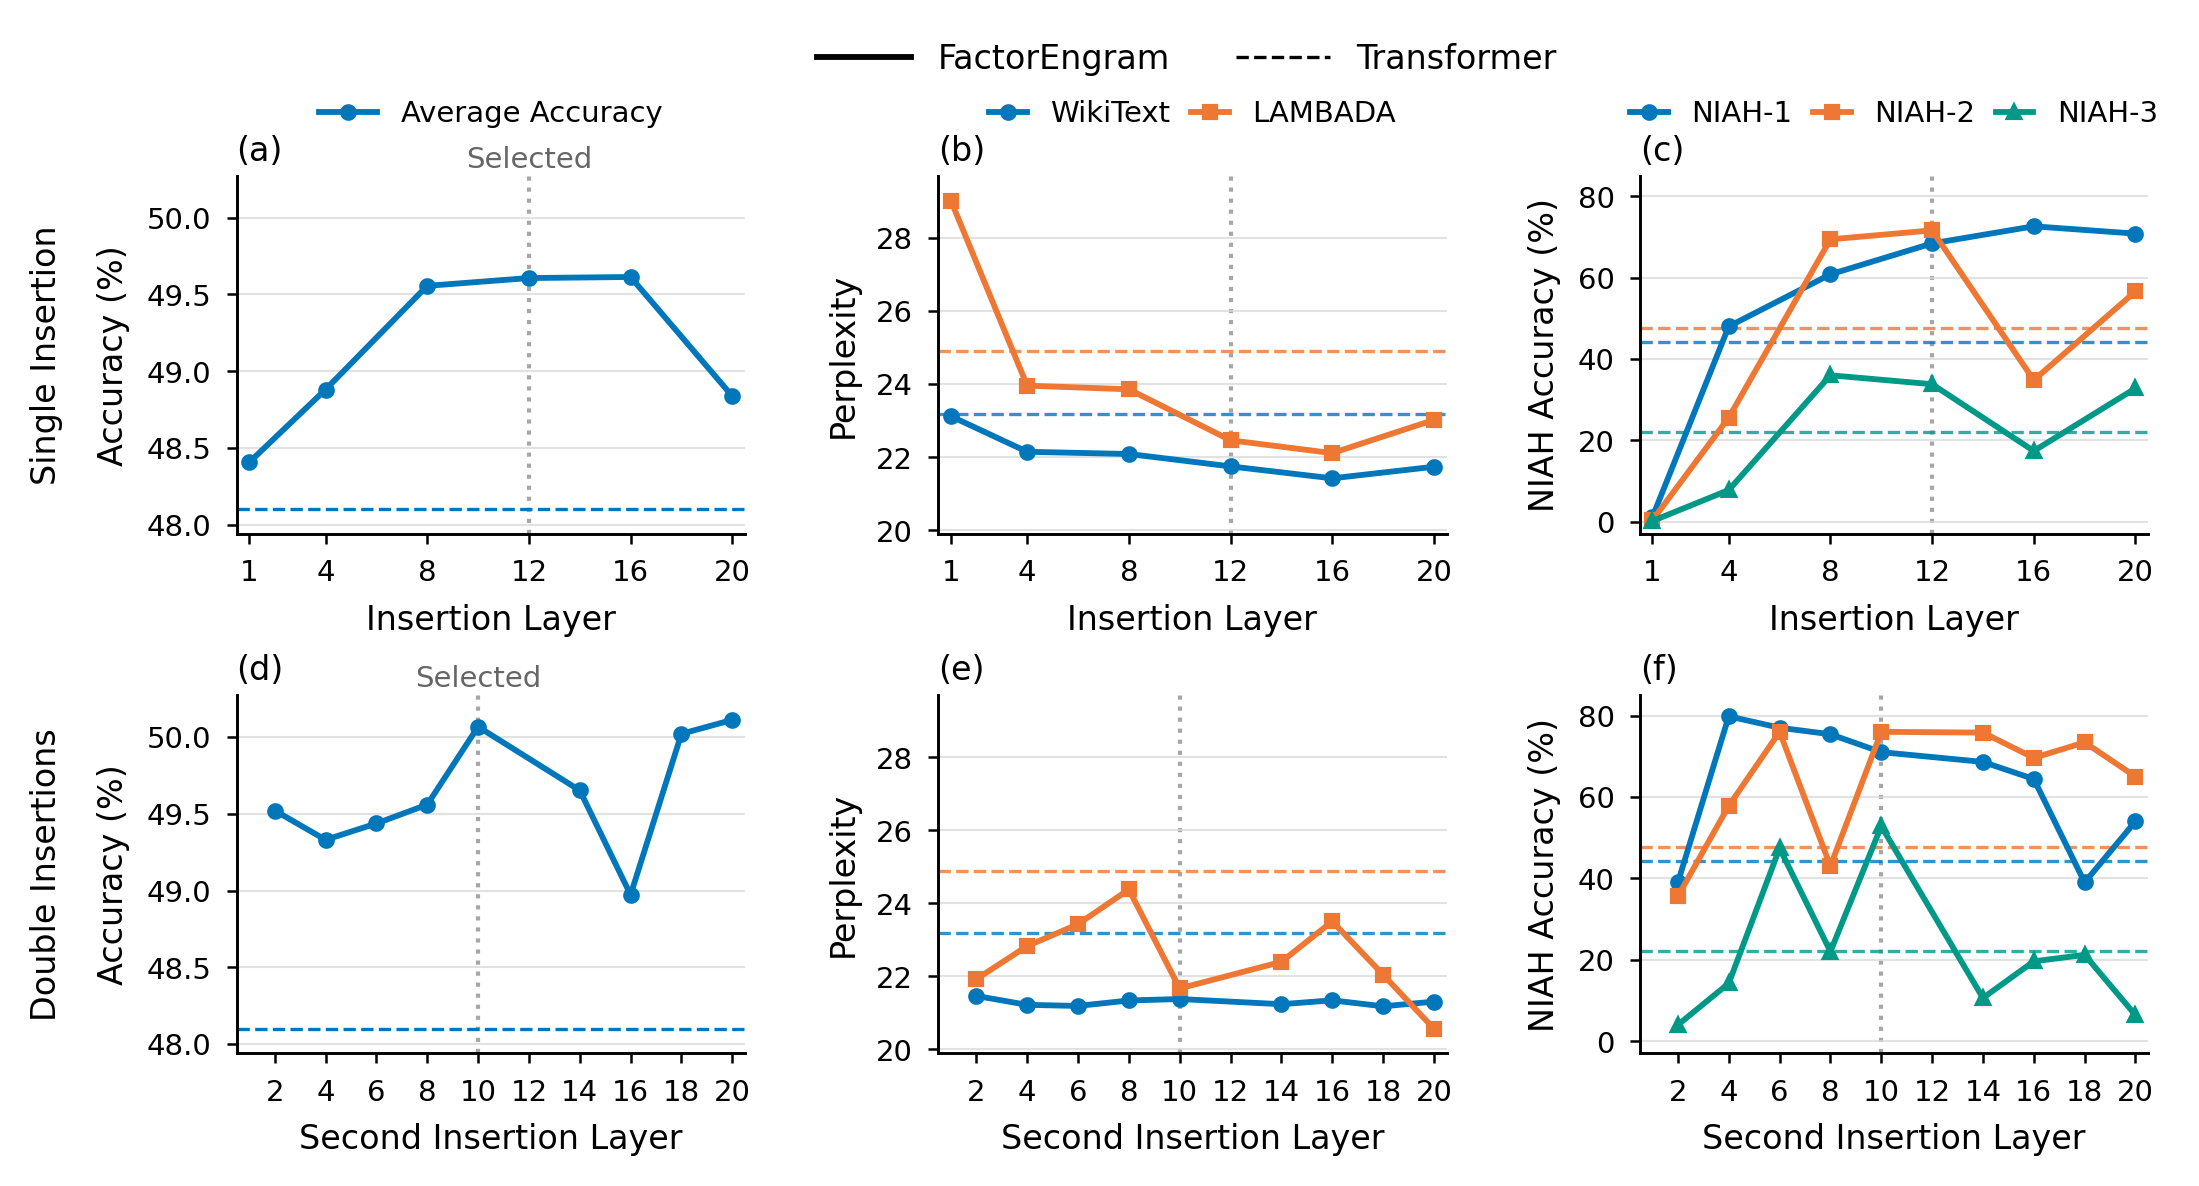
论文在 340M 和 1B 参数的 Transformer backbone 上对比 FactorEngram 与 Engram 等 lookup-based memory 方法。评估语言建模困惑度及多个下游任务指标。系统扫描 memory 分支插入深度(前/中/后层)与层内位置(attention 前、FFN 前等)。消融实验分解稀疏字典系数、basis-level gating、单 token 与 n-gram 覆盖等组件。
关键发现
FactorEngram 通过因子化共享字典,允许相关 pattern 复用基向量,缓解了 Engram 中 embedding 单体化、参数仅靠哈希碰撞共享的问题。上下文通过 backbone hidden state 对每个基向量打分,实现 basis-level gating,使多义 pattern 能选择性读出相关分量。实验表明在中间层 attention 子层之前插入 memory 分支效果最佳;消融验证各组件贡献。
与基线的深度解读
相比 Engram,核心差异在于解耦存储与门控:Engram 每个 n-gram 一个独立 embedding 和一个标量门,参数共享缺乏语义关联;FactorEngram 将 embedding 分解为基向量字典上的系数,门控也在基向量级操作,参数共享更结构化、上下文调制更细粒度。这带来语言建模与下游任务的稳定提升。
行业影响
落地场景
FactorEngram 适合需要快速注入静态/半静态知识的 LLM 推理场景,例如:
- 电商搜索与推荐:query 改写中处理“苹果”等多义词,依据上下文选择水果或科技品牌记忆成分,提升商品匹配准确率。
- 代码补全:高频代码模式(如
import numpy as np)存为共享 basis,推理时按需检索,减少重复计算。 - 医疗问答:医学术语消歧,如“ALS”根据上下文关联不同疾病记忆组件。
商业价值
- 降本:相比 Engram 的单体 embedding,因子分解降低存储;稀疏系数读取减少计算开销,可在边缘设备部署大参数量记忆分支。
- 体验提升:basis-level gating 消除多义模式混淆,减少生成错误,直接改善客服响应、内容生成等场景的用户满意度,从而提升转化与留存。
与现有产品/工作流的接口
- FactorEngram 作为 auxiliary memory branch 可插入现有 Transformer 骨架,推荐放置在 中间层、attention 子层之前。
- 对已有模型可采用微调插入记忆分支;对新产品可从零训练。记忆输出与 backbone hidden state 相加,无需改动主干架构,兼容主流训练/推理框架。
具体 use case:电商平台商品描述生成中,对“苹果”商品自动生成描述时,FactorEngram 可依据标题或类目上下文激活相应 memory basis,避免生成“甜脆多汁”用于手机壳;代码补全工具中,对 def __init__(self): 等重复样板模式快速检索,减少用户等待时间,提升 IDE 体验。
局限
- **计算与存储开销**:FactorEngram 引入共享基础向量字典,并对每个基础向量单独评分,相比 Engram 的单标量门控,增加了隐藏状态与所有基础向量相似度计算的推理延迟;同时稀疏系数和字典参数也带来额外存储。论文未报告在 340M/1B 模型上的具体内存占用、FLOPs 增量及推理延迟对比,使得实际部署成本不透明,难以评估在资源受限场景的可行性。
- **大规模可扩展性缺乏验证**:实验仅覆盖 340M 和 1B 参数 Transformer 主干,而 Engram 已在 DeepSeek-V4.1-Flash 等更大规模模型中得到应用。FactorEngram 的因子化表示、稀疏正则化和基础级门控在大模型(如数十亿至数百亿参数)上的稳定性、稀疏性保持程度、字典规模选择及对下游任务的影响缺乏实证,其优势可能随模型规模变化而减弱或需重新调参。
- **插入位置与超参依赖经验搜索**:论文系统研究了记忆分支插入深度和层内位置,结论是中间层注意力前最佳,但该结论可能只适用于特定主干架构和任务分布。对于不同深度、宽度或使用 MoE 等结构的 LLM,最优插入位置可能不同,需重新进行成本较高的搜索。此外,稀疏正则化系数、字典大小等超参数对训练稳定性和最终性能敏感,论文未给出调参策略或自动化方法,实际应用时的调参负担不容忽视。