AnswerMap:从答案后验实现 VLM 的忠实空间可解释性
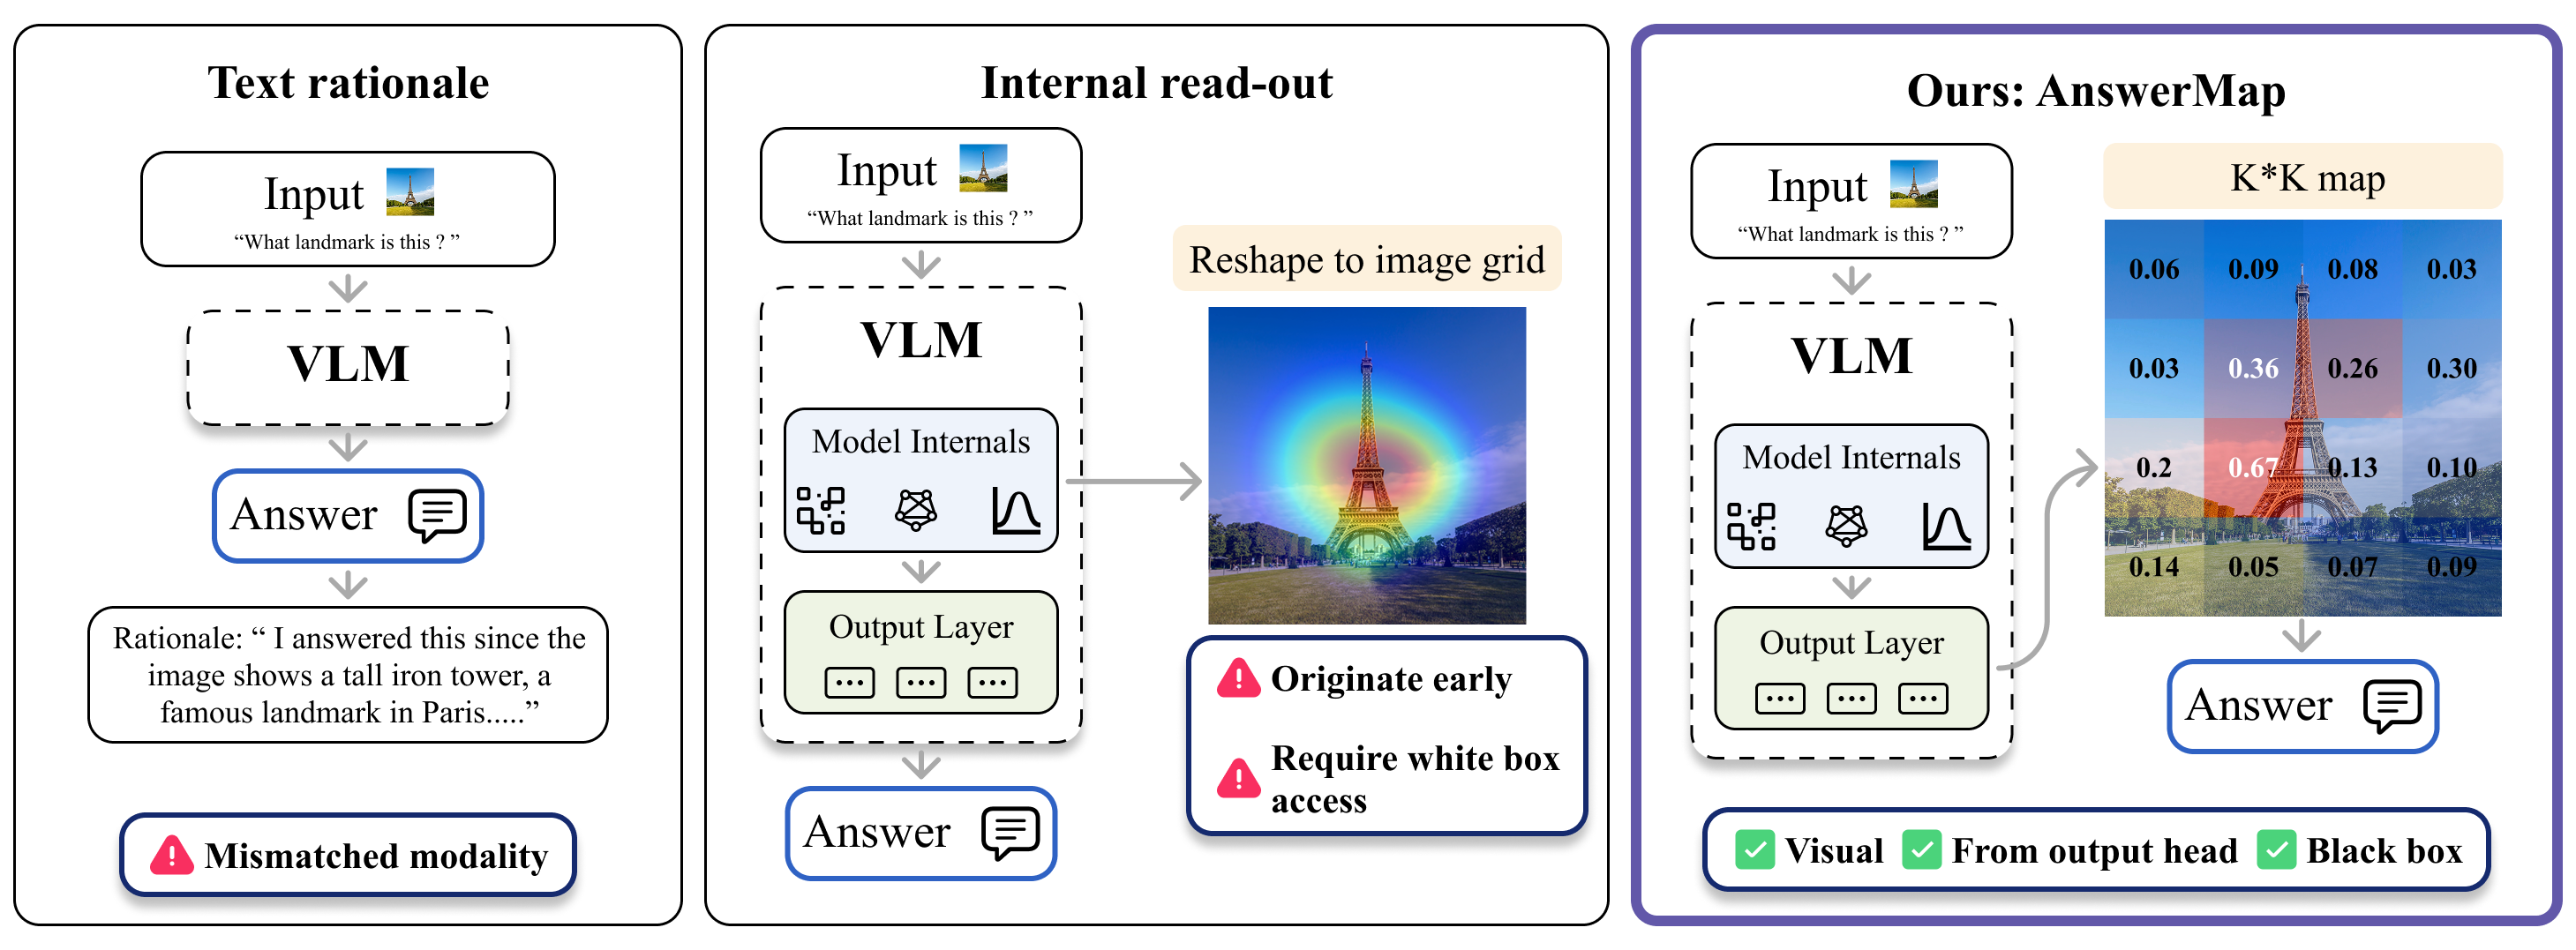
问题:VLM 回答视觉查询时,现有可解释性工具或依赖文本 rationale(模态不匹配),或依赖内部读出(发生太早、无法反映最终输出,且需白盒访问)。 方法:AnswerMap 是一种免训练、任务无关、黑盒的视觉 rationale,直接由输出头构建。将图像切成 K 条行带与 K 条列带,每条单独与查询一起、以 yes/no 相关性问题的形式喂给冻结模型;行、列 yes 后验的外积即得该查询条件下的空间图。在 AnswerMap 上定义固定 read-out R(如 expectation、maximum),便可原生推导位置等连续输出,既绕开对离散文本 token 的依赖,又由构造保证答案依赖图像。 验证:在四个模型、三种查询分布上做两项测试:(a) 是否与模型自身生成的点一致;(b) 删除地图覆盖区域。结果地图落在模型所指之处(AUC 0.85,attention 仅 0.38),删除其区域会翻转 53% 的正确答案(attention 为 19%)。 应用:三种 read-out 展示其任务无关效用——maximum 无需生成即可标记幻觉物体,expectation 在模型自身定位失败时仍能正确定位,top-mass 区域作为 crop 回馈可修正半数错误答案。AnswerMap 为 VLM 可解释性提供了新视角,也借助 read-out 为视觉任务提供了超越文本 token 的新输出接口。
论文精读
TL;DR AnswerMap 通过行/列条带的 yes/no 后验外积,从 VLM 输出头构建黑盒、免训练的空间可解释图;其忠实性 AUC 0.85,删除高亮区域翻转 53% 正确答案,可直接输出位置、检测幻觉并修复错误。
问题
问题背景
VLM 在视觉问答与目标定位任务中表现提升,但其空间可解释性仍然不足。业界关注模型是否真正“看见”了相关区域,而非依赖文本幻觉。
现有方法局限
- 文本理由(text rationale)与视觉模态不匹配,无法给出精确空间位置。
- 内部读取(internal read-outs)依赖白盒访问,且信号取自模型早期层,无法反映最终输出决策。
- 注意力图常被误用,但本工作实验显示其 AUC 仅 0.38,接近随机,不能作为忠实理据。
为什么难/重要
VLM 输出是离散文本 token,对连续空间输出(如坐标定位)不友好;同时模型可能产生与图像无关的 confabulated answers。需要一种训练无关、任务无关、黑盒可用的空间解释方法,既能忠实反映模型决策,又能作为输出接口替代文本 token。
行业类比
如同自动驾驶感知系统需要审计模型关注区域以保障安全,AnswerMap 提供一种黑盒的“注意力替代品”,可用于部署后监控 VLM 是否定位到关键物体,从而发现幻觉并修复错误。
核心洞察
- AnswerMap 通过直接读取输出头的 yes/no 相关性后验构建空间解释,而不是看注意力或内部特征。与 attention 相比,它在 pointing agreement 上 AUC 0.85 vs 0.38,且删除其高亮区域能翻转 53% 正确回答 vs 19%,说明输出头更接近最终决策,且方法无需白盒访问。这对实际工程意味着:对于闭源或 API-only VLM,首次有了可靠的 spatial rationale 获取方式。
- AnswerMap 使用 K 行 K 列 band 的外积构建空间图,将查询复杂度从 O(K^2) 降到 O(K),使黑盒探测在成本上可行。该设计不同于逐 patch 打分的 baseline,既保持了全图覆盖,又显著减少了 API 调用次数。实际工程中可直接用于 API 调用的 VLM,无需内部梯度或特征,且能扩展到高分辨率输入。
方法
输入与探测流程
AnswerMap 以图像和查询为输入,将图像切成 K 行条带和 K 列条带。每个条带单独送入冻结 VLM,并附加一个 yes/no 相关性问题(如“该区域与查询相关吗?”),得到每条带对应“yes”的后验概率。行条带概率构成向量 r,列条带概率构成向量 c,二者外积生成 K×K 的空间响应图 AnswerMap。该图表示每个图像块与查询的相关性。
关键特性
- 训练无关:无需梯度或微调,纯推理过程。
- 黑盒可用:只需要模型输出概率,不访问内部激活或注意力。
- 任务无关:同一探测格式适用于定位、存在性判断等任务。
输出读取器
在 AnswerMap 上定义固定读取器 R(例如期望、最大值),将空间图转换为连续输出。例如 R=argmax 直接给出位置坐标,绕过文本 token 解码,避免生成答案与图像解耦的问题。R=期望 可在模型自身指向失败时仍提供定位;R=最大值 可用于检测幻觉对象。
与同类方法差异
相比文本 rationale(跨模态、可能无法反映空间依据)和内部注意力(需要白盒、信号早于最终输出),AnswerMap 从输出头构建,保证图像依赖、忠实于最终决策,且支持连续输出任务。
实验
实验设计
- 在四个 VLM 和三个查询分布上验证 AnswerMap。由于方法 training-free,只需将图像切分为 K×K 条带,逐条带输入模型得到 yes/no 后验,外积得到空间图。
- 两个核心测试:(1) 与模型自身生成点的一致性(计算 AUC);(2) 删除地图高亮区域后观察答案翻转比例。
关键发现
- AnswerMap 与模型指向点高度一致(AUC 0.85),而 attention 基线仅 0.38。
- 删除 AnswerMap 区域导致 53% 正确答案翻转,attention 仅 19%。
- 三种读出方式展示任务无关性:最大值可审计幻觉 无需生成;期望值在模型指向失败时仍可定位;top-mass 区域反馈为裁剪可修复一半错误答案。
对比解读
- 相比依赖文本 rationale 或内部表征的方法,AnswerMap 直接使用输出头部后验,确保解释与最终答案同源,且黑盒可用。
- 与 attention 的差距表明,浅层注意力不足以反映最终决策;而删除实验验证了地图区域与答案的因果关联,避免 confabulation。
行业影响
落地场景
AnswerMap 适用于需要 VLM 输出空间解释的产品:电商平台的商品图像问答(定位商品特征、验证描述真实性)、内容平台的视觉审核(标记违规区域、辅助人工复核)、医疗影像辅助诊断(异常区域定位)。其黑盒特性意味着可直接用于闭源 VLM API,无需权重或梯度访问。
商业价值
- 降本:通过删除测试和幻觉检测,减少人工复核量,降低运营成本。
- 增收:提升视觉问答准确率(论文显示修正 50% 错误答案),改善用户体验,降低客服投诉。
- 体验提升:提供像素级理由,增强用户对 AI 输出的信任,尤其在电商推荐、教育讲解等交互场景。
与现有工作流集成
AnswerMap 作为免训练后处理模块,可通过标准 VLM API 批量调用,输出 JSON 格式的空间 map 和 read-out 结果。集成方式:
- 在现有 VLM 推理管线后增加一个 AnswerMap 解释器,接收原始图像、查询和模型输出。
- 使用 read-out(如 expectation 定位、maximum 检测幻觉)替换或增强离散 token 输出。
- 支持按需触发:当模型置信度低或用户请求解释时运行,控制额外推理成本(论文提供查询预算曲线,成本可控)。
典型用例:电商平台部署 VLM 回答“这件衣服的图案在哪个位置?”时,AnswerMap 的 expectation read-out 直接输出坐标,无需文本生成,降低延迟并提高定位精度;内容平台使用 maximum read-out 自动标记模型声称存在的对象但 map 无响应,过滤幻觉描述。
局限
- **网格粒度与上下文丢失**:AnswerMap 将图像切成等宽的行/列带并单独展示,每个带仅保留图像的部分信息,模型无法感知物体间的空间关系与全局上下文。对于需要整体理解才能回答的复杂查询(如“骑车的人是否戴头盔”),割裂成独立条带可能导致后验估计偏差。此外,K 值的选择对结果影响显著:K 过小则空间分辨率不足,K 过大则单条带信息过少、且计算成本线性增加。论文虽有多尺度乘积,但未系统探索 K 的最优范围或自适应策略,实际部署时需针对具体任务调参。
- **对 yes/no 提示格式的敏感性**:该方法将任意查询改写为 yes/no 相关性问句,其回答后验直接构成空间图。若问题措辞不当,或 VLM 对二元问句的校准较差,会产生系统性噪声。虽然附录中检验了 prompt 变体,但未在更大规模的开放域查询中验证鲁棒性。另外,部分闭源模型仅提供文本生成接口,获取后验概率需额外采样或 logprob 访问,可能削弱其 black-box 特性。
- **计算开销与实时性不足**:对于每张图像,AnswerMap 需要执行 2K 次前向(K 行 + K 列),且每次输入为单条带图像。当 K=64 时(论文默认高分辨率设置),推理次数达 128 次,即使使用高效推理框架也难以满足实时交互需求。相比之下,基于梯度或注意力的方法只需单次前向。对于延迟敏感的应用(如自动驾驶、视频流分析),该方法的适用性受限。论文提及 query budget 曲线但未给出明确的加速方案。