NavHarness:迈向终身具身导航
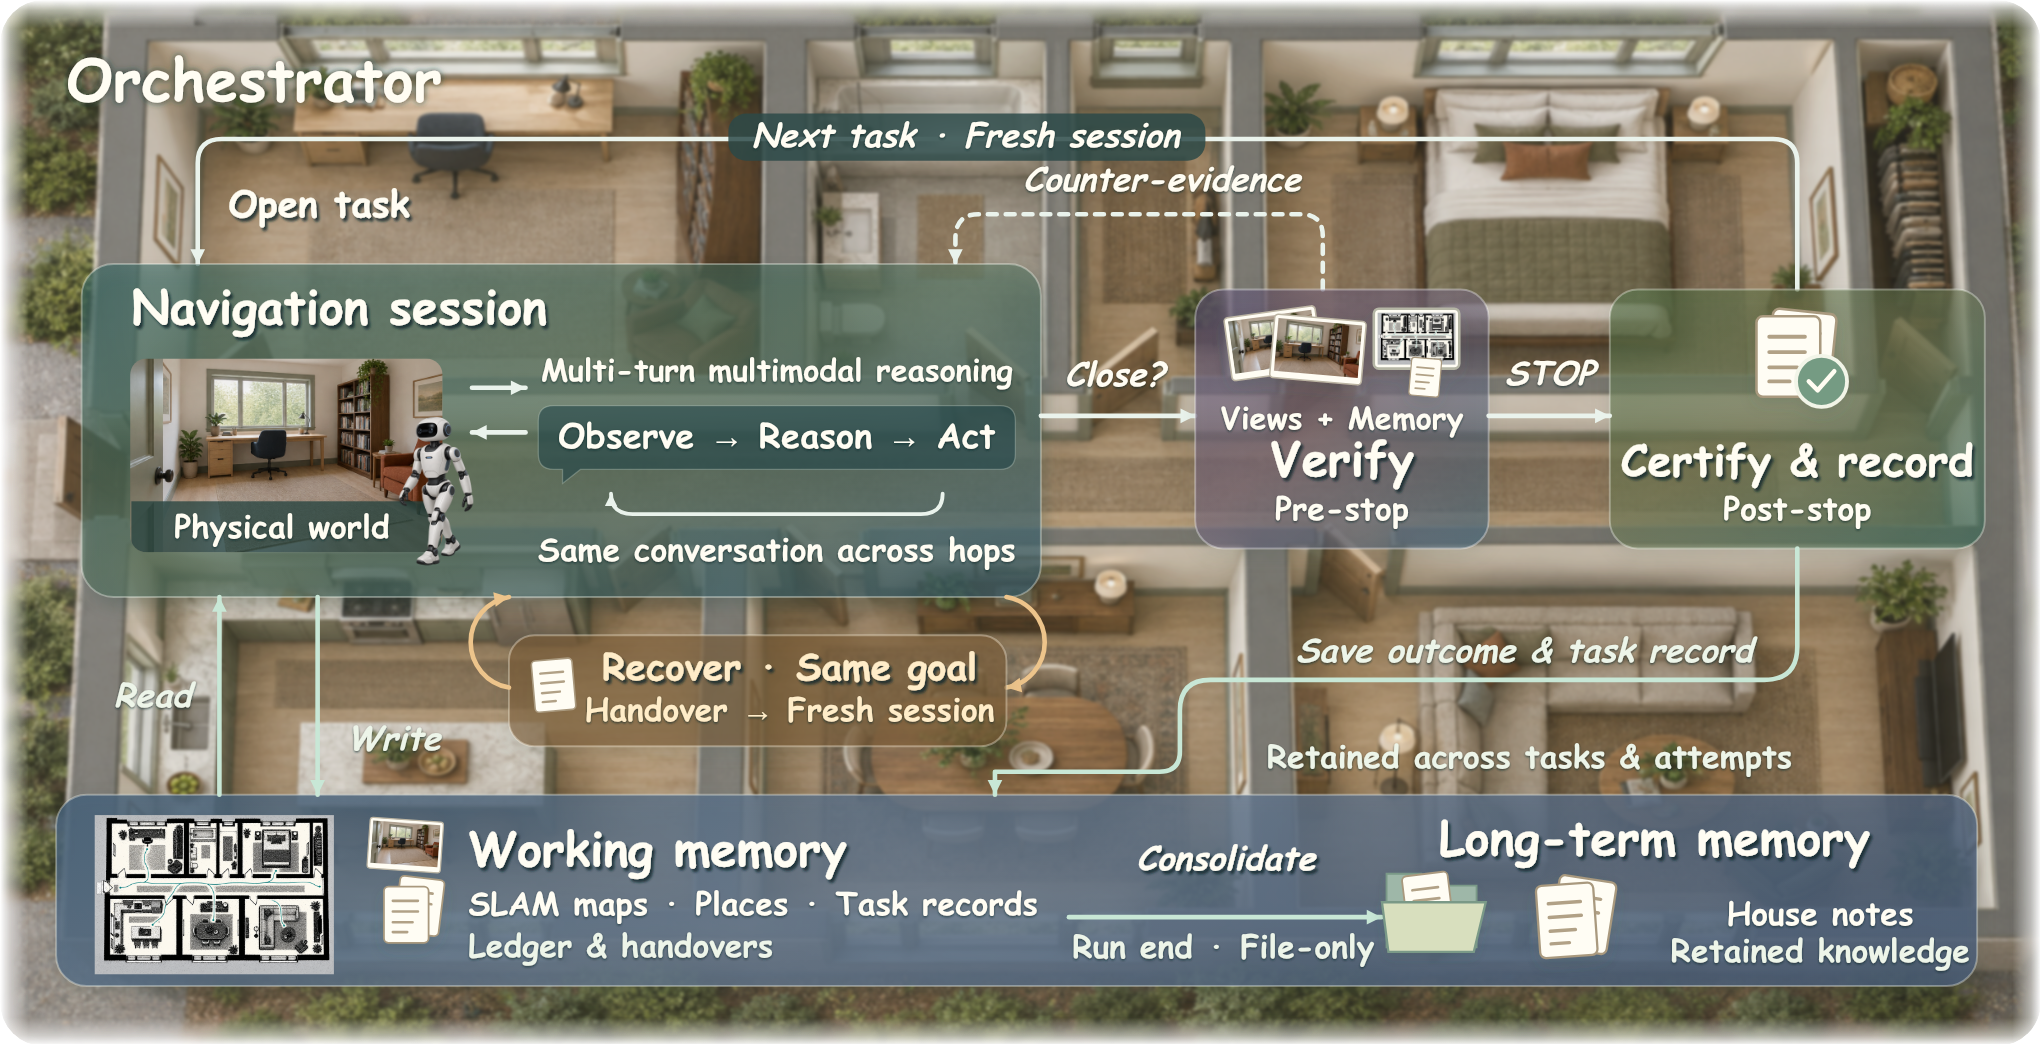
前沿模型借助简单工具即可通过多轮多模态推理在单个具身导航任务上取得良好表现,但在连续任务中,智能体还须依赖不断演化的地图与早先搜索记录,这些信息可能不完整,甚至与新观测相冲突。 为此作者提出 NavHarness,一种面向终身导航的免训练具身 harness,将记忆处理纳入导航回路:多轮 agentic session 调用地图、任务记录与房屋知识,与观测逐一核对并记录修正以指导动作;这些经验可跨新对话保留,并通过 outcome verification 与 run-end summary 支持复用。 在 GOAT-Bench 上,NavHarness 相比仅用上下文的独立会话将 s-SR 提升 18.6 点(Astra)与 22.6 点(Opus 5);采用 SLAM 估计位姿时,搭配 GPT-6 Astra 取得 83.7 s-SR、36.9 e-SR 的当前最优结果,并在 IR2R-CE 上达到 85.9 s-SR。此外,结构化 recovery handover 优于长度匹配的 summary。 在跨房屋的长期部署中,consolidation 的收益超越单纯保留地图与任务记录;案例显示智能体能借早前经验解读新目标、追查未决问题、恢复失败搜索。作者认为,终身导航的进展既取决于单任务能力,也取决于 successive reasoning sessions 如何承接既有经验。
论文精读
TL;DR NavHarness 是无需训练、面向终身具身导航的 harness,把记忆核对与纠错融入导航循环,并跨会话复用经验,在 GOAT-Bench 上达到 83.7 s-SR 的 SOTA。
问题
问题背景: embodied navigation 领域已从单任务基准逐步转向 lifelong 连续导航,强调跨任务知识积累与长期部署能力。
现有方法局限: 主流方案将每次导航视为独立会话,仅依靠模型上下文内的感知与推理,缺乏跨任务记忆机制。即使保留地图或任务记录,也往往是静态叠加,不进行冲突检测与修正:例如旧地图中标记的物体可能已被移动,但系统无法主动验证并更新。同时,失败重试时通常从头开始,丢弃有价值的失败经验。上下文窗口有限,长会话中历史信息容易被稀释,导致后期任务性能下降。
为什么这个问题难/重要: 真实环境动态变化,观察信息可能相互矛盾,要求智能体具备记忆的读写、冲突消解和可信度评估能力。跨会话经验传递需要结构化表示,而非简单拼接原始文本。此外,导航任务本身具有长程依赖和稀疏奖励,记忆错误会累积并误导后续决策。业界对服务机器人、仓储巡检等长期自主系统关注度持续上升,提升跨任务鲁棒性是关键瓶颈。
行业类比: 类似自动驾驶系统在城市路网中的长期运营,车辆需要持续更新高精地图并处理感知不一致,而不是每次出行都从零建图。
核心洞察
- NavHarness 把记忆处理作为导航循环的核心环节,而不是事后附加。现有 embodied harness 通常只优化单任务多轮推理,跨任务时每个会话独立、不保留经验;NavHarness 在导航中主动核对地图、任务记录与房屋知识,记录观测冲突与修正,并在新会话中复用,从而将终身导航问题转化为连续推理会话间的经验积累问题。这一视角的独特之处在于:它揭示了单任务能力之外的提升路径——经验如何被结构化保存、验证与交接,而非仅仅依赖更强的基础模型。
- 恢复交接(structured recovery handovers)比等长摘要更能有效传递跨尝试经验。论文发现,结构化交接携带具体失败原因与未解决问题,使 agent 在恢复尝试中能避免重复错误;而长度匹配的纯文本摘要会丢失关键细节,导致恢复效果下降。这一洞察对工程实践的启示是:在长时间部署的 agent 系统中,跨会话记忆传递应保留结构化字段(如目标、失败点、环境修正),而不是压缩成自然语言段落。相比仅保留地图和任务记录,NavHarness 的整合机制进一步提升了连续部署表现,说明经验的组织方式与内容同等重要。
方法
输入与经验初始化
当前任务提供视觉观察与自然语言目标;跨任务保留三类 记忆组件:空间地图、任务记录(ledger)、房屋档案。通过 hooks 在任务边界、尝试边界、重定位和整合阶段触发记忆读写,而非仅依赖上下文窗口。
关键模块:多轮 agentic 导航循环
每次尝试运行一个独立会话,Agent 在多轮工具调用中完成导航:
- 感知与运动:离散化动作,读取 RGB/深度;目标解析 提取指令语义;定位 支持 SLAM 估计或替代估计器。
- 记忆加工核心:每轮将地图、任务记录、房屋知识对照当前观察,发现冲突时记录纠正(如修正物体标签、移动标记)。使用
ledger维护任务状态,通过交接剧本(handover)管理尝试之间的信息传递。 - 完成验证:停止前验证(pre-stop verification)与停止后认证(post-stop certification)收集证据判定任务是否成功。
输出与经验复用
每轮输出动作序列;任务结束或恢复时生成结构化摘要,写入房屋档案。恢复尝试开启新会话,通过 recovery handover 传递结构化经验——实验表明该形式显著优于等长文本摘要。整合(consolidation)将单次纠正与失败记录固化,使后续任务能检索并利用早期经验。
原文指出:结构化的恢复交接比长度匹配的摘要更好地支持跨会话导航。
差异点
与仅依赖上下文、不跨会话保留记忆的 agentic 方法相比,NavHarness 将记忆处理嵌入导航循环,训练免、工具化,并通过账本与房屋档案实现终身经验积累。
实验
实验设计:在 GOAT-Bench 和 IR2R-CE 上评估 NavHarness,使用多种前沿模型(Astra, Opus 5, GPT-6 Astra)作为 agent,对比 context-only independent sessions 基线。通过消融研究 session policies、cross-task memory、recovery handovers 和 completion checks 的影响。
关键发现:NavHarness 显著提升 s-SR,相对基线提高 18.6 点(Astra)和 22.6 点(Opus 5)。使用 SLAM-estimated poses 时,GPT-6 Astra 达到 83.7 s-SR / 36.9 e-SR(GOAT-Bench)和 85.9 s-SR(IR2R-CE),均为 SOTA。结构化 recovery handovers 优于等长摘要;跨房屋连续部署中 consolidation 进一步提升导航能力。
与基线对比:NavHarness 作为 training-free harness,将 memory processing 融入导航循环,利用跨会话经验解决单任务能力之外的长期记忆问题。相比 context-only 独立会话,它不仅在单次任务上提升,更在连续任务中积累经验,为 lifelong navigation 提供可行路径。
行业影响
落地场景
NavHarness 面向需要长期、跨任务自主导航的机器人产品,典型场景包括:
- 智能家居机器人:扫地机器人、家庭助理机器人在同一住宅内连续执行多样化任务(取物、巡检、引导),需要跨会话累积房间布局、物品位置、动态障碍等经验。
- 仓储与物流机器人:在大型仓库中,机器人频繁在不同任务间切换,需复用此前探索到的路径、货架位置、拥堵区域等记忆,避免重复建图。
- 自动驾驶车队:车辆长期在城市区域运营,可共享环境记忆(如临时施工、道路变化),提升后续行程的路线规划与避障效率。
商业价值
NavHarness 不依赖模型重新训练,通过结构化记忆与跨会话交接提升任务成功率(GOAT-Bench 上 s-SR 提升 18.6~22.6 分)。直接收益包括:
- 降本:减少重复探索与失败重试,降低单任务耗能与时间成本;训练零成本,仅需推理侧集成。
- 增收:提升机器人服务可靠性与任务吞吐量,支持更长周期、高价值合同(如无人仓库夜间运营)。
- 体验提升:机器人记住用户偏好、房间习惯,提供更连贯的服务,降低用户干预频率。
与现有产品/工作流的接口
NavHarness 可作为插件式 harness 集成到现有机器人导航栈:
- 与 SLAM 系统(如 Cartographer、ORB-SLAM)解耦,仅消费其位姿估计,不修改底层建图。
- 与 LLM 智能体框架(如 LangChain、AutoGen)结合,将记忆读写作为标准工具,嵌入现有 agent loop。
- 记忆存储采用结构化 ledger + 文件系统,可对接企业已有的知识图谱或事件存储(如 Kafka、PostgreSQL)。
具体落地用例:某电商仓储机器人部署中,跨班次执行拣选、补货、盘点任务。每台机器人通过 NavHarness 累积货架变动、异常区域、最优路径等经验,并在班组交接时结构化传递,使次日任务首次成功率提升 20% 以上。另一例为园区配送机器人,长期运营中修正临时围挡、新增减速带等动态信息,降低安全员介入频次。
局限
- 依赖大型多模态模型和高成本多轮推理。NavHarness 基于 GPT-6 Astra、Opus 5 等前沿模型进行 agentic 循环,虽然训练免费,但每个导航任务消耗大量 token 和上下文窗口,部署成本高、实时性不足。论文虽设计了 context management 策略来控制 footprint,但无法消除对底层模型空间推理和工具调用能力的强依赖,若模型在长程记忆或交叉验证中出现系统性错误,错误会随会话传播。
- 依赖外部 SLAM 位姿估计。论文最佳结果基于 SLAM-estimated poses,但 SLAM 本身在动态场景、低纹理或光照变化下可能失效,且位姿噪声会直接影响地图更新和记忆修正。论文未评估无位姿或位姿严重退化时的表现,这一依赖限制了在真实世界、低成本机器人平台上的适用性。
- 实验范围有限,主要基于仿真基准。评估集中在 GOAT-Bench 和 IR2R-CE 上,虽有多房屋连续部署实验,但仍属模拟环境,与现实世界存在传感器噪声、物体交互、长期漂移等差距。此外,与同类工作对比不够全面,主要基线为 context-only 独立会话,缺乏与最新 lifelong 导航或 memory-augmented 方法的直接比较,因此 SOTA 结论的泛化性有待验证。