SlideDP: 跨多 GPU 扩展宿主驻留 LLM 微调
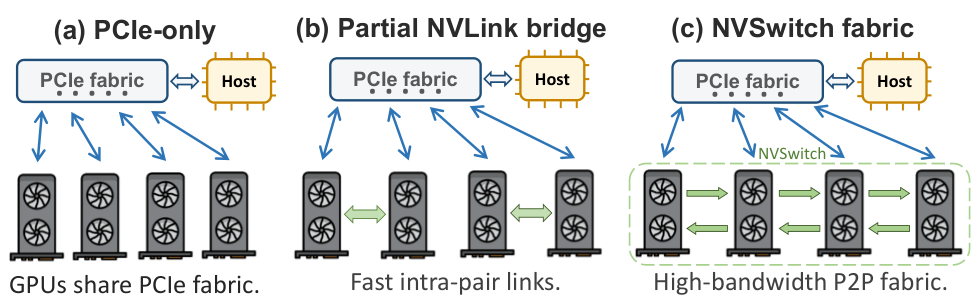
宿主驻留(host-resident)层流式加载让全参数 LLM 微调 突破 GPU 显存限制,但数据并行各 rank 会争抢共享的宿主资源:复制式传输放大流量,而强扩展(strong scaling)在计算窗口收缩时会让宿主侧工作暴露为瓶颈。为此我们提出 SlideDP,一个面向共享宿主多 GPU 系统的同步数据并行运行时。 方法上,SlideDP 维护单一权威宿主状态,将通信路径与状态布局解耦,并对参数下发、梯度聚合与 CPU 更新按 rank 与 chunk 进行流水化。其解析式步时模型 刻画了资源瓶颈与流水线暴露,运行时测量则指导在 GPU 显存预算下的通信、分块与激活策略。 实验方面,在匹配批量扫描中,SlideDP 相对 SlideFormer、MegaTrain 与 ZeRO-Offload 取得 1.46-2.64 倍的几何平均吞吐比。在四张 H100 上,SlideDP 在更小批量下对 Qwen3-14B 接近 GPU 驻留的 FSDP2 吞吐;批量增大后,单步处理超过 1M tokens,并超出 FSDP2 实测峰值吞吐 11.2%。此外,它支持同模型的 256K token 序列,并在四张 RTX 4090 上微调 Qwen2.5-72B。项目主页:https://github.com/RegiaYoung/SlideDP。
论文精读
TL;DR SlideDP 是共享主机多 GPU 的同步数据并行运行时,通过单一权威主机状态与跨 rank 流水线,解决 host-resident 微调的资源竞争,吞吐较现有 offload 方法提升 1.46–2.64 倍,并在四 H100 上超越 FSDP2 峰值 11.2%。
问题
问题背景:当前 LLM 微调领域关注如何突破 GPU 显存限制,host-resident 层流式(layer streaming)技术允许全参数微调超出显存容量,但多 GPU 数据并行时 rank 之间对共享主机资源的争用成为新瓶颈。
现有方法局限:SlideFormer、MegaTrain、ZeRO-Offload 等 host-offload 方案在数据并行下每个 rank 独立从 host 复制参数和梯度,造成:
- 复制传输放大流量,host 带宽成为瓶颈;
- 强扩展时 GPU 计算窗口缩短,host 上的参数更新与通信无法完整隐藏;
- 缺乏对共享 host 资源竞争的系统建模,chunk 大小、通信路径等策略选择依赖经验。
难点与重要性:多 GPU 共享同一 host 时,需要维护单一权威状态、解耦通信路线与状态布局,并对参数传递、梯度聚合、CPU 更新进行跨 rank 和 chunk 的流水线编排。同时要在 GPU 内存预算下动态调整激活策略。这类问题是多卡微调(如 4×H100 微调 14B 模型)的共性瓶颈,工业界广泛关注。
行业类比:类似分布式训练中参数服务器与 worker 之间的带宽争用,必须通过流水线调度和聚合合并来抵消共享存储的延迟与吞吐限制。
核心洞察
- SlideDP 的核心洞察是:在共享主存的多 GPU 环境中,数据并行会使多个 rank 重复传输同一份参数,把主机带宽变成隐藏瓶颈。与 SlideFormer、MegaTrain、ZeRO-Offload 各自为政的 per-rank offload 不同,SlideDP 只保留一份 authoritative host state 并解耦通信路由与状态布局,从源头消除重复搬运,配合跨 rank 与 chunk 的流水线,让 host-resident fine-tuning 在多卡上真正获得扩展收益。
- 另一个关键视角是把共享主机的扩展性问题形式化为 step-time 解析模型,并用运行时测量来指导 communication、chunking、activation 策略。这不同于传统 offloading 系统依赖启发式配置或静态分块;SlideDP 显式刻画资源瓶颈与 pipeline exposure,在给定 GPU memory budget 下动态选择策略,因此能在 4×H100 上接近 FSDP2 吞吐,且在大 batch 时反超 11.2%,并在 4×RTX 4090 上微调 Qwen2.5-72B,说明模型与测量闭环对 heterogeneous 环境的可迁移性。
方法
SlideDP 的输入是 宿主内存中的完整模型参数 与多 GPU 的数据并行请求,输出为同步更新后的权威参数状态。其核心模块包括:
- 单一权威主机状态:在共享宿主内存中只保留一份参数副本,避免数据并行 rank 各自复制导致的冗余传输和带宽竞争。
- 通信路由与状态布局解耦:参数在宿主内存中的物理布局与 GPU 间通信路径分离,允许根据实际硬件拓扑和带宽动态选择最优传输路径,而无需改变状态存储格式。
- 跨 rank 与 chunk 的流水线重叠:将参数传递、梯度聚合、CPU 更新按 rank 和 chunk 切分并流水化,使宿主侧计算与 GPU 计算窗口重叠,减少流水线暴露时间。
- 解析步时间模型:通过静态分析刻画资源瓶颈和流水线暴露,预测不同配置下的单步耗时,为策略选择提供依据。
- 测量引导的策略选择:在给定 GPU 内存预算下,根据运行时实测的通信带宽、CPU 计算速度等指标,自动选择通信方式、分块大小和激活重计算策略。
- 弹性检查点:支持在不同 GPU 数量和宿主资源变化时快速恢复训练。
与 SlideFormer、MegaTrain、ZeRO-Offload 等同类方法相比,SlideDP 通过单一权威主机状态与流水线重叠,在共享主机多 GPU 场景下消除了冗余参数传输,且分析模型和测量引导使策略选择更贴合实际硬件行为,从而获得 1.46–2.64 倍的吞吐提升。
行业影响
落地场景
SlideDP 面向共享主机多 GPU 环境下的全参数微调,适合需要定制大模型但 GPU 显存受限的企业。典型应用包括:
- 电商平台:对商品文案生成模型(如 Qwen3-14B)进行品牌语气微调,使用多张消费级 GPU(如 RTX 4090)配合大内存主机,即可微调 Qwen2.5-72B 级别模型。
- 内容平台:训练处理长文档或长视频脚本的摘要模型,SlideDP 支持 256K token 序列,能覆盖整本书或长节目内容。
商业价值
核心价值在于降低训练硬件门槛与单位 token 成本。
- 通过 host-resident 状态和单权威副本,消除了多 rank 间的冗余参数传输,在四 H100 上较 FSDP2 峰值吞吐提升 11.2%,直接减少训练时间和云成本。
- 支持超大 batch(超 1M tokens/step)和长序列,提升模型在长上下文任务上的质量,间接改善下游产品体验。
- 允许用消费级 GPU 集群替代高端加速卡,显著节省采购或租赁费用。
与现有工作流集成
SlideDP 以同步数据并行 runtime 形式提供,兼容 PyTorch 数据并行生态:
- 替换现有 offload 策略(如 ZeRO-Offload、FSDP2 的 CPU offload),无需修改模型前向代码。
- 提供
测量引导策略选择,根据 GPU 内存预算自动调整通信、分块和激活策略,减少手工调参。 - 支持弹性检查点,方便集成到 Kubernetes 或 SLURM 等任务调度系统,增强容错与可恢复性。
开发者可在现有 Hugging Face Trainer 或自定义训练脚本中,通过 import slidedp 并替换分布式初始化,即可获得多 GPU 共享主机的吞吐提升。项目主页:SlideDP。
局限
- **单机 shared-host 范围限制**:SlideDP 的设计与评估均围绕单台多 GPU 主机展开,未讨论跨节点分布式场景。对于需要多机协同的超大规模模型微调(如数百亿参数以上),其共享主机内存与 CPU 带宽的假设将不再成立,跨节点通信与状态一致性机制需要重新设计。此外,系统对主机内存容量和 PCIe/NVLink 带宽高度敏感,在硬件配置较弱的平台上性能提升幅度可能显著缩小。
- **CPU 更新与 host 带宽的根本瓶颈**:尽管 SlideDP 通过流水线和分块重叠隐藏了部分 host 工作,但当 GPU 计算窗口足够短时,CPU 上的优化器更新和参数传输仍会暴露为关键路径。论文的分析模型证实了这一点,但并未提供根本解决方案。在 GPU 算力大幅提升或 batch size 较小的场景下,SlideDP 的吞吐可能重新受限于主机侧带宽,难以进一步接近 GPU-resident 训练。
- **实验覆盖与策略自适应性有限**:评估主要基于 H100 和 RTX 4090 两类硬件,未展示更多样的 GPU 型号、PCIe 拓扑或内存配置下的表现。测量引导的策略选择需要预先 profiling,其在不同模型架构和超参数下的泛化能力尚不明确。此外,与 FSDP2 的对比主要针对 Qwen3-14B 和 Qwen2.5-72B,未涉及其他模型家族(如 Llama、Mistral)或 MoE 之外的更多模型类型,结论的普适性有待验证。