KernelZero:协同进化 Proposer 与 Coder,持续提升 GPU Kernel 生成
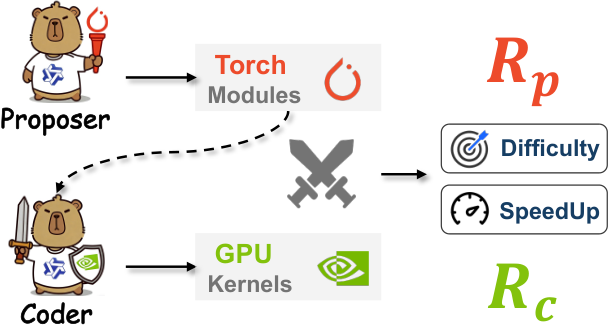
高性能 GPU kernel 是现代机器学习系统的基石,但自动生成既正确又高效的 kernel 仍颇具挑战。现有基于 LLM 的方法存在两大瓶颈:一是缺少与模型当前能力相匹配的高质量训练数据,二是 kernel 的正确性与性能之间难以兼得。 为此,作者提出 KernelZero 协同进化框架,通过两个专用模型持续改进 GPU kernel 生成:Proposer 负责从 API 集合生成 Torch 模块,Coder 将其翻译为 CUDA 或 Triton kernel。该框架采用 frontier-driven 模块生成机制,依据 Coder 当前的薄弱环节持续产出能力对齐的训练模块;并引入 Correctness-Aware Group Relative Policy Optimization(CA-GRPO),在正确性足够可靠之后才优化性能。通过交替优化 Proposer 与 Coder,KernelZero 形成自动课程,实现有针对性的、训练高效的能力提升。 实验方面,KernelZero-7B 在 CUDA 上超越 Claude-4.5-Sonnet,在 Triton 上超越 DeepSeek-V4-Pro。在 KernelBench Level 1 和 Level 2 上,CUDA 的 pass@1 分别达 75.8% 与 69.6%,pass@10 达 100% 与 97%;Triton 上的 pass@1 分别为 77.2% 与 72.5%。
论文精读
TL;DR KernelZero 通过 Proposer 与 Coder 协同进化,按 Coder 弱点动态生成 Torch 模块,并在正确性稳定后优化性能,使 7B 模型在 CUDA/Triton 内核生成上超越 Claude-4.5-Sonnet。
问题
问题背景
GPU kernel 质量直接决定 ML 系统的硬件利用率,但手写 CUDA/Triton 负担沉重,自动生成成为刚需。
现有方法局限
- 训练数据错位:主流 LLM-based 方法依赖静态数据集,同模型当前能力不对齐,缺少“略高于当前水平”的负样本,导致训练梯度稀疏或过难。
- 正确性-性能权衡:常将编译通过率、
pass@k或执行时间单独作为奖励,造成模型要么牺牲数值正确性换取速度,要么过度保守无法接近峰值性能;且缺乏分阶段优化机制。
为什么难/重要
GPU kernel 优化涉及访存合并、线程 divergence、tensor core 调度等大量硬件相关决策,搜索空间庞杂,正确性验证又需昂贵 GPU 资源。错误 kernel 一旦用于生产,可能引发静默数值异常或大规模训练崩溃。因此,在有限训练预算内同时提升正确率和执行效率,是 AI 基础设施与编译器社区的共同难点。
行业类比
这类似于自动代码生成中的“生成-编译-测试-修复”闭环,但 kernel 领域对硬件特异性和数值稳定性的要求更严苛,细微指令差异即可让整个训练管线失效。
核心洞察
- KernelZero 通过 Proposer 与 Coder 的协同进化,解决了 GPU kernel 生成中训练数据与模型能力不对齐的核心瓶颈。 与现有方法依赖静态数据集或独立训练生成模型不同,该框架让 Proposer 根据 Coder 当前弱点动态生成前沿 Torch 模块,形成自动课程。这使得训练样本始终处于模型能力边界,避免了数据过于简单导致训练低效或过于困难导致收敛失败,实现了针对性的能力提升。
- Correctness-Aware Group Relative Policy Optimization (CA-GRPO) 将正确性验证作为性能优化的前置条件,有效解耦了 kernel 正确性与效率的固有矛盾。 传统 RL 方法直接优化性能指标,容易在早期牺牲正确性换取虚假的性能提升。CA-GRPO 仅在正确性达到预设阈值后才引入性能奖励,并用组相对策略优化平衡探索与利用。这种两阶段优化策略使 KernelZero-7B 在 KernelBench 上同时获得高 pass@1 和 pass@10,超越了更大的专有模型。
方法
输入与整体流程
KernelZero 的输入是一组基础算子 API 集合,以及当前 Coder 的性能与正确性反馈。框架由 Proposer 和 Coder 两个模型组成,二者交替训练:Proposer 生成新的 Torch 模块作为任务,Coder 将其翻译为 CUDA/Triton kernel,并通过执行反馈更新双方。
Proposer:生成前沿训练模块
Proposer 从 API 列表中采样组合出 Torch 模块,执行 Validation Check 保证模块可运行且非平凡,再利用 Frontier Reward 筛选那些正处于 Coder 当前能力边界上的模块——既不过于简单(Coder 已能完美解决)也不过于困难(Coder 完全无法处理)。这些模块作为下一轮 Coder 的训练数据。
Coder:从正确到高效
Coder 先通过 Cold Start Distillation 从已有模型中蒸馏基础代码生成能力。随后采用 Correctness-Aware Group Relative Policy Optimization (CA-GRPO) 进行强化学习:在标准 GRPO 基础上引入正确性阈值,只有当正确率达到一定水平后才对性能指标(如执行时间)进行相对优势优化。这避免了早期为追求性能而牺牲正确性。
交替训练形成自动课程
Proposer 根据 Coder 的最新错误和低效案例产生新的前沿模块,Coder 训练后能力提升,Proposer 再生成更难的任务,形成自动 curriculum。输出为针对输入 Torch 模块的高性能 CUDA/Triton kernel。
与同类 LLM-based kernel 生成方法相比,KernelZero 的关键差异在于用 Proposer-Coder 协同演化 动态构建训练课程,并通过 CA-GRPO 显式解耦正确性与性能优化阶段,避免了静态数据集与单一奖励信号带来的 trade-off 失衡。
实验
实验设计
KernelZero 在 KernelBench Level 1/2 上分别评估 CUDA 与 Triton 内核生成,采用 pass@k 指标。对比基线包括 Claude-4.5-Sonnet(CUDA)与 DeepSeek-V4-Pro(Triton)等大模型及专用内核生成模型。训练流程包含 冷启动蒸馏 与 CA-GRPO 强化学习,并在 Proposer 与 Coder 间交替优化。
关键发现
- KernelZero-7B 在 CUDA 上 pass@1 达 75.8%(L1)、69.6%(L2),Triton 上达 77.2%(L1)、72.5%(L2),均超越更强基线模型。
- CUDA pass@10 高达 100%(L1)与 97%(L2),表明通过多次采样可显著提升问题覆盖率。
- 前沿驱动的模块生成持续产出与 Coder 当前能力匹配的训练数据,自动课程使训练更高效。
与基线对比解读
KernelZero-7B 以 7B 参数规模超越闭源大模型,说明数据质量与训练策略 比模型容量更为关键。CA-GRPO 在正确性可靠后才优化性能,缓解了正确性与效率的权衡。但 pass@10 的高值提示,实际部署中需权衡采样成本与通过率提升。
行业影响
落地场景
KernelZero 可直接嵌入 深度学习编译器 与 自定义算子生成 工作流,适用于以下业务:
- 电商推荐系统:针对稀疏 Embedding 融合、Attention 变体等高频算子,自动生成 CUDA/Triton kernel,减少手写优化成本。
- 内容平台视频处理:为视频转码、超分辨率、图像增强模型生成高性能 kernel,提升 GPU 利用率。
- 自动驾驶 / 边缘推理:针对端侧模型(如 BEV、点云处理)的算子自动调优,加速部署。
商业价值
主要降本与增效双线并行:
- 降本:减少资深 GPU 工程师的人力投入,缩短从模型定义到高效 kernel 的周期(从数天降至小时级)。
- 增效:pass@1 达到 75.8%(CUDA Level 1)、77.2%(Triton Level 1),且 pass@10 接近饱和,意味着生成结果可靠性高,可加速模型上线和硬件资源利用率提升,间接降低单位推理成本。
与现有产品/工作流的接口
KernelZero 可作为 codegen 微服务 或 CI 插件 集成:
- 接入 PyTorch Inductor / Triton 的后端,用 Proposer 生成
Torch模块描述,Coder 输出 kernel,替换手写模板。 - 与现有 LLM 代码助手(如 GitHub Copilot、Codex)配合,提供领域专用的 kernel 生成能力。
- 通过 CA-GRPO 持续从线上性能反馈中学习,形成自动 curriculum,适合嵌入 MLOps 闭环。
与一次性 SFT 方法相比,KernelZero 的 co-evolution 机制能持续跟踪当前模型弱点,避免训练数据与模型能力错配,更适合长期维护的算子库产品。
具体 use case 举例:电商场景中,某推荐模型需将 batch_matmul + softmax + mask 融合为一个 kernel,传统方法需工程师手写数百行 CUDA;KernelZero 可从 API 列表自动生成模块并编译为 kernel,pass@1 成功,节省 3 天开发时间。自动驾驶场景中, voxel_pooling 等非标准算子可自动生成 Triton kernel,提升推理吞吐。
局限
- 评估基准单一且偏重正确性:实验仅在 KernelBench Level 1/2 上报告 pass@k,未提供生成内核实际执行时间或与 cuBLAS/PyTorch 原生实现的加速比。这意味着论文宣称的性能优化(CA-GRPO)效果缺乏直接量化佐证,读者难以判断生成 kernel 在真实工作负载中的效率是否真的优于现有框架。
- 训练与推理系统复杂、资源开销高:框架需要同时训练并维护 Proposer 和 Coder 两个模型,交替优化形成自动课程,且 CA-GRPO 依赖奖励服务器进行编译验证、正确性检测和性能测量。这种基础设施要求可能限制许多研究团队的复现与二次开发,也增加了推理时的模型管理成本。
- 中间表示 Torch 模块限制内核表达空间:Proposer 从预设 API 集构造 Torch 模块,Coder 再翻译为 CUDA/Triton。这种设计可能无法覆盖依赖底层原语(如 warp shuffle、异步拷贝、张量内存加速器)或极端手工优化的 kernel,对于 KernelBench 之外的复杂算子泛化能力存疑,与直接生成异构代码的方法相比灵活性不足。