X-Tree: 将可复用经验 Token 化以实现高效的 Agent 泛化
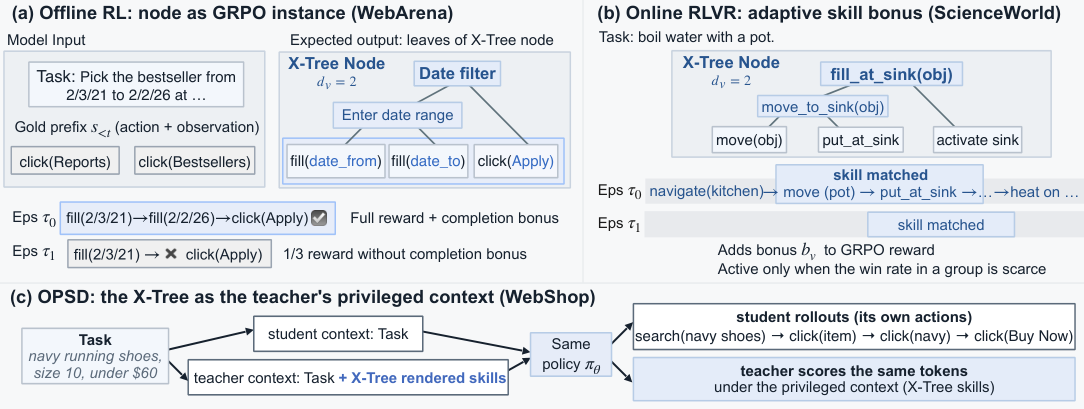
多步 Agent 通常在扁平的动作流上训练:SFT 与 RLVR 对每个 token 一视同仁,忽略了跨任务重复出现的子过程,也就是那种让人能自顶向下从可复用例程出发做规划的层级结构。这一结构始终未被利用,而扁平训练对每条稀缺轨迹的挖掘也不及其内容所允许的程度。近期 Agent 确实用到了该结构,但仅作为 LLM 写在 context 中的技能,从未进入模型权重,因此其收益无法泛化到检索之外。 我们改为从数据本身恢复这种层级并据此训练,全程无需任何 LLM 调用。仿照文本 tokenizer 仅靠计数构建词表的方式,我们按可复用性为动作片段打分,并将规范化后的动作合并成一棵可复用的经验树(X-Tree)。每个 X-Tree 节点刻画一个高频且与成功相关的技能如何由子技能组合而成,从而引导高效泛化。 我们将 X-Tree 集成进三种训练设置:离线 RL,每个节点作为一个训练实例;在线 RLVR,引入自适应技能奖励;on-policy 自蒸馏,将 X-Tree 作为自教师的特权上下文。在 WebArena、ScienceWorld 与 WebShop 三种模型规模上,X-Tree 在同等数据与预算下较标准配方最多提升 4.5% SR(WebArena)、5.8% SR(ScienceWorld)与 4.1% success(WebShop)。受控对比分析将增益归因于 X-Tree 结构及其三种集成方式。
论文精读
TL;DR X-Tree 从动作轨迹中挖掘可复用技能构建经验树,并整合进离线RL、在线RLVR和自蒸馏,在WebArena等基准上提升最高5.8%成功率,无需额外LLM调用。
问题
问题背景
当前多步智能体(如 WebArena、ScienceWorld 环境中的 agent)的训练范式主要基于 SFT 与 RLVR,将整条动作轨迹视作平坦的 token 序列,但忽略了动作之间反复出现的子过程与层级组合。
现有方法局限
- 平坦训练对每个 token 等权优化,无法识别或强化高频成功子例程,稀缺轨迹数据的利用率低。
- LLM 编写的技能库虽引入结构,但仅作为上下文注入,不更新模型权重,收益受限于检索质量,无法泛化到未检索到的场景。
- 从轨迹中自动挖掘可复用结构需要处理动作变体、噪声与任务相关性,此前缺乏低成本且无需 LLM 的方法。
为什么难/重要
长轨迹的多步决策错误会累积,对全局成功影响大。提升样本效率和泛化能力是 agent 落地的核心瓶颈。X-Tree 通过类似文本 tokenizer 的计数合并策略,从数据中恢复层级结构并直接用于训练,无需 LLM 调用,为高效 agent 训练提供了新途径。其与离线 RL、在线 RLVR、自蒸馏三种范式的集成验证了通用性,对工程实践有直接参考价值。
行业类比
类似推荐系统中从用户行为序列挖掘高频模式构建兴趣树,或代码编辑器抽取常用片段为可复用函数,X-Tree 把 agent 轨迹中的成功子动作自动“函数化”,减少重复探索成本。
核心洞察
- X-Tree 将多步 Agent 的轨迹视为可统计挖掘的经验语料,通过动作 span 的复用性与成功率构建层级技能树,不依赖 LLM 调用或检索,直接作为训练信号进入模型权重。与现有 LLM-written skills 仅作为上下文提示不同,X-Tree 从数据本身恢复可复用子过程,使技能泛化内化为权重更新,避免只在推理时检索而无法稳定泛化的问题。
- X-Tree 提供了一套统一的技能结构接入三种训练范式:offline RL 把每个节点作为独立训练实例,online RLVR 用自适应技能奖励增强探索,on-policy self-distillation 把 X-Tree 作为教师特权上下文。这种同一结构多目标适配的做法,与为 skill 单独设计 RL 或蒸馏流程相比,显著降低工程复杂度;消融分析表明增益来自树结构本身,而非额外数据或单一 RL 算法,为后续技能驱动的 Agent 训练提供了可复用的模块化路径。
方法
输入与预处理
X-Tree 的输入是多步 agent 的轨迹池(可为离线固定数据集或在线交互产生)。首先对动作序列做 canonicalization:将语义相同但表述不同的动作文本标准化,消除表面符号差异。随后从所有轨迹中提取连续动作跨度(span),统计每个跨度在成功轨迹中的出现频率与成功率,作为可重用性评分基础。
关键模块:X-Tree Mining
借鉴文本分词器(如 BPE)仅靠计数构建词表的思想,X-Tree 通过数据驱动的合并形成层级技能树。具体步骤:
- 评分:用频率与成功率联合度量每个动作跨度的“可重用性”,筛选出高频且与成功强相关的跨度。
- 建树:将入选跨度按组合关系组织成树——父节点由子节点按时间顺序组合而成,根节点对应一条完整成功轨迹中的顶层技能。树的构建不依赖任何 LLM 调用,完全由统计得出。
- 节点语义:每个 X-Tree 节点代表一个可复用的动作子程序,并携带其频率、成功率等统计信息。
输出与三种训练集成
输出为一棵紧凑的 X-Tree 技能树,可接入三种训练范型:
- Offline RL:将每个树节点对应的轨迹片段作为独立 RL 训练实例,让模型学习局部子技能的决策策略。
- Online RLVR:在标准 RLVR 奖励基础上,当 agent 执行完一个 X-Tree 技能时给予 自适应技能奖励,奖励大小与节点成功率动态相关,引导策略复用树中技能。
- On-policy Self-Distillation (OPSD):使用 X-Tree 作为 self-teacher 的特权上下文——教师模型在生成时可查看与当前状态相关的子树片段,学生模型无此上下文,通过蒸馏将技能结构内化到权重中。
与同类工作的差异:此前技能库方法依赖 LLM 编写技能并仅作为上下文检索,技能不进入模型权重;X-Tree 完全从数据统计挖掘,无 LLM 成本,且以树结构编码组合关系,直接通过 RL 或蒸馏写入权重。
实验
实验设计
在 WebArena、ScienceWorld 和 WebShop 三个多步智能体基准上,用三种模型规模评估 X-Tree。将其集成到三种训练设置:离线 RL(每个 X-Tree 节点作为一个 RL 实例)、在线 RLVR(自适应技能奖励)和 on-policy 自我蒸馏(X-Tree 作为特权上下文)。对比标准 recipe,数据量与算力预算匹配。
关键发现
- 离线 RL 在 WebArena 上提升 +4.5% SR,无需额外信息。
- 在线 RLVR 在 ScienceWorld 提升 +5.8% SR,在 WebShop 提升 +4.1% success。
- OPSD 表现与 LLM 编写的技能库相当,但 零 LLM 调用成本。
- 更大模型在 OPSD 下优势更明显。
对比解读
与仅将技能作为上下文(LLM-written skills in context)不同,X-Tree 将可复用层次结构编码进权重,因此泛化不限于检索。类比文本 tokenizer,X-Tree 通过统计频繁且成功导向的动作片段来构建经验树,无需 LLM 生成。这让同等数据与预算下训练更高效,充分利用稀缺轨迹。
行业影响
落地场景
X-Tree 适用于多步执行 Agent 的训练优化,典型场景包括电商导购、企业 RPA、教育虚拟实验和金融流程自动化。例如:
- 电商购物 Agent:从历史交互中挖掘“搜索-比价-加购-结算”等可复用子程序,提升跨商品、跨类目的任务成功率;
- 企业软件自动化:在 WebArena 类网页操作中,复用表单填写、登录认证、审批提交等高频动作序列,显著减少长流程失败率。
商业价值
- 降本:无需额外 LLM 调用生成技能库,直接利用现有轨迹数据;同等数据规模下成功率提升 4.5%–5.8%,提高数据利用率,减少对稀缺高质量轨迹的依赖;
- 增收与体验:在电商导购或客服自动化中,任务成功率每提升 1% 可减少大量人工转接与订单流失;在企业级 RPA 中,更稳定的流程执行直接缩短业务周期。
接口与集成
X-Tree 是训练侧组件,可无缝嵌入现有 RL 流水线:
- Offline RL:将每个 X-Tree 节点作为一个训练实例,不需要额外环境交互;
- Online RLVR:在奖励计算中加入
adaptive skill bonus,引导策略复用高频成功子技能; - On-policy Self-Distillation:用 X-Tree 替换 LLM 编写的技能库作为特权上下文,零推理成本。
对于已部署使用 RLVR 或 self-distillation 的团队,只需在生产日志上离线挖掘一次,再替换训练数据或奖励函数即可。
局限
- **挖掘过程依赖轨迹质量与规范性**:X-Tree 从已有轨迹中按频率和成功率挖掘动作跨度,若离线轨迹池规模有限、多样性不足或含大量失败样本,可能导致技能树稀疏或偏向噪声。论文默认基于成功轨迹构建,但实际部署中如何筛选高质量数据未详细说明,影响技能树可复用性。此外,动作规范化依赖环境特定解析规则,跨环境迁移时需重新设计,限制了即插即用性。
- **计算开销与超参敏感性**:虽然避免 LLM 调用,但 X-Tree 挖掘需处理大量轨迹并构建层次树,其计算复杂度随轨迹长度与数量增长,论文未报告挖掘阶段的耗时与内存成本。同时,技能评分阈值、树深度、合并策略等关键超参在论文中可能依赖经验设定,不同任务或模型规模下需重新调优,增加工程落地难度。与 LLM 编写的技能库相比,X-Tree 需要额外数据预处理流程。
- **适用场景受限**:当前方法主要针对文本动作空间(如 Web 操作、文本命令),对于连续控制、视觉动作等非离散动作序列无法直接应用。此外,X-Tree 结构信息只通过三种训练设置注入,但每种设置都需要单独适配(如离线 RL 的节点实例构造、RLVR 的自适应奖励、自蒸馏的特权上下文),尚未形成统一接口,限制了在更广泛智能体架构中的泛化。