WanPE: 面向现代文本到视频生成的电影级提示增强
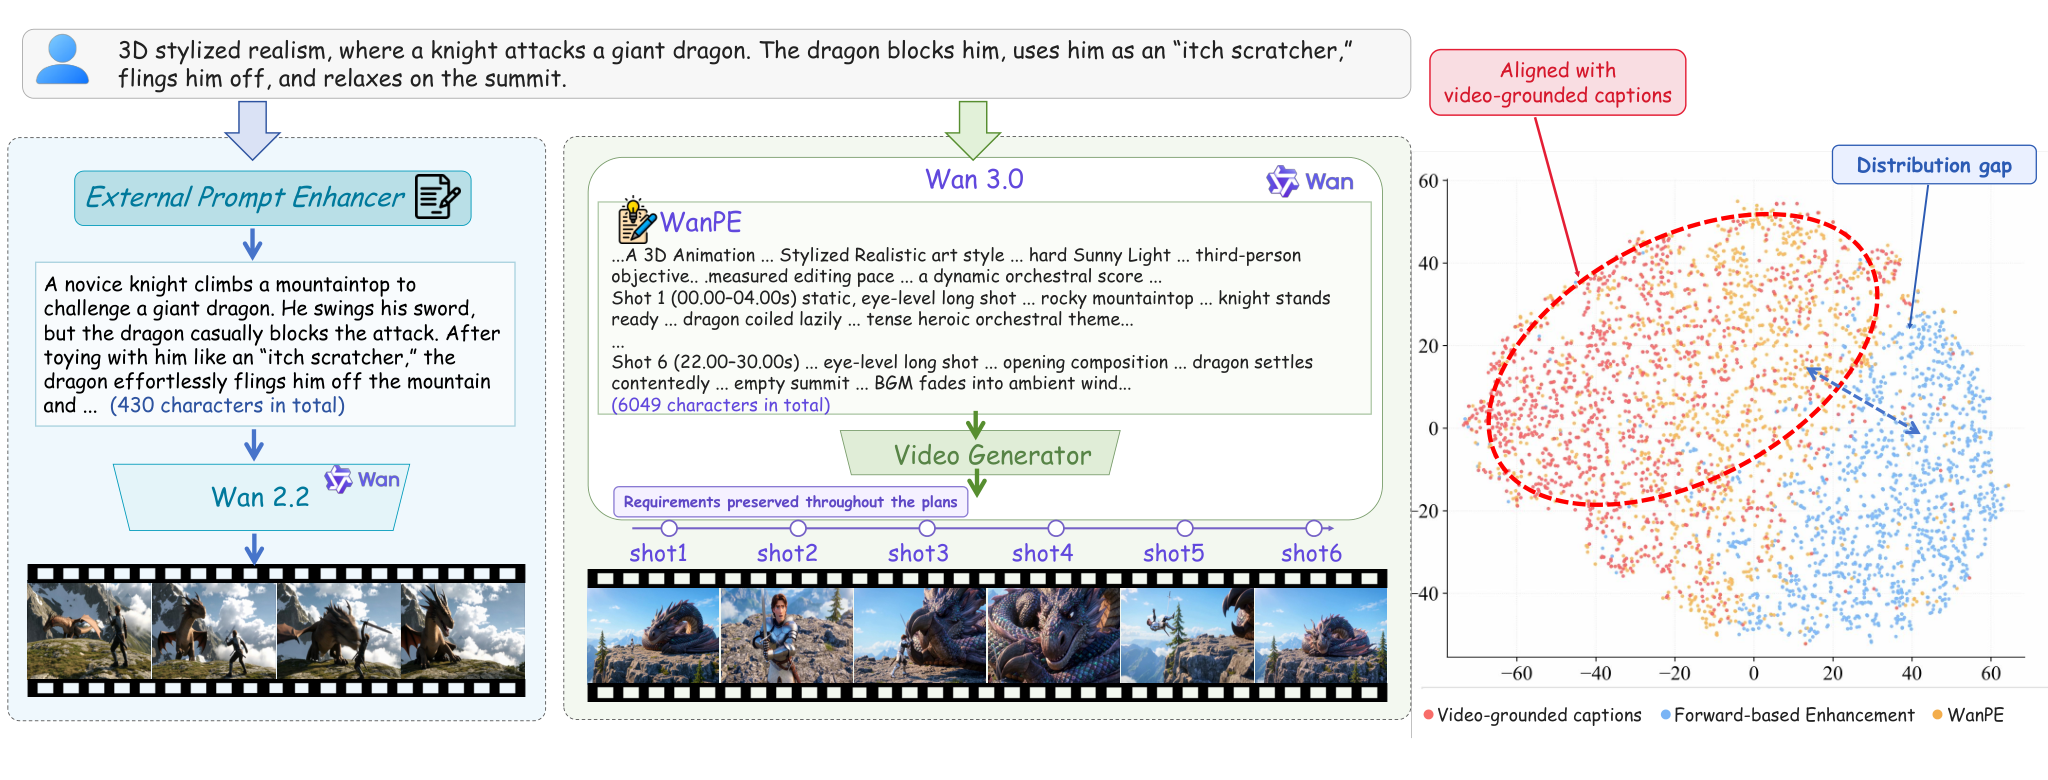
视频生成始于文本空间——先撰写电影脚本,再落地为像素。当当代视频生成器扩展到 30 秒并能忠实遵循复杂条件时,文本提示在很大程度上主导了整部「制作」,规划动作、镜头轨迹、光照与声音如何在多镜头序列中展开。 本文提出 WanPE ,一个 397B 参数的提示增强模型,在 105 万(1.05M)真实视频上训练,以掌握导演级电影规划能力。WanPE 通过 基于视频的反向构建 生成镜头级电影规划,并采用 Semantic-Consistency GRPO(SC-GRPO) 在跨镜头与长时间跨度上忠实保留用户需求。为评测该能力,作者构建 WanPEval ,一个人工标注测试平台,覆盖 5 至 30 秒时长与不同意图粒度,并配备约 11K 次盲测配对评估。 实验显示,在驱动 Wan3.0 视频生成器时,WanPE-397B 相对原始用户提示在人类偏好上于 5–15 秒提升 10.66–18.84 分,在 30 秒赛道大幅提升 50.86 分。消融研究表明: - 反向构建 明显优于前向改写; - SC-GRPO 在不同模型规模下均能稳健保持语义保真度。 最终,WanPE 在 5–15 秒领先所有受评商业方案,在 30 秒与 Seedance 2.5 保持竞争力。
论文精读
TL;DR WanPE-397B 通过视频反向构建影视级分镜规划,并结合 SC-GRPO 保持语义一致,使 Wan3.0 生成视频在 30 秒人类偏好评测中提升 50.86 点。
问题
问题背景
当前文本到视频生成进入长视频、多镜头阶段,模型已能遵循复杂条件,但提示词质量成为瓶颈,用户难以用自然语言表达导演级意图。
现有方法局限
现有提示增强多采用前向改写(forward rewriting),从文本到文本,缺乏对真实视频内容结构的反向约束,容易生成表面华丽但镜头间不连贯的计划;同时,语义一致性 在长序列中难以保持,用户原始需求在扩展过程中被稀释或扭曲。此外,缺乏覆盖不同时长和意图粒度的统一评测基准,难以量化提升。
为什么这个问题难/重要
让模型掌握电影级规划涉及高层次时序推理与镜头语言理解,需要从海量真实视频中反向构建“文本→视频”的对应关系,而不仅是从文本到文本的改写。长视频(如30秒)生成对提示的结构性要求更高,一旦语义偏移,多镜头叙事会严重崩坏。业界对可控、连贯的长视频生成需求强烈,提示增强是提升生成质量最直接、成本最低的路径之一。
行业类比
这类似于在 LLM 应用中,从简单的单轮 prompt 优化升级为多步 agent 规划,要求模型在保留用户目标的同时自主分解子任务并保持执行一致性。
核心洞察
- 视频锚定的逆向构造(video-grounded reverse construction)将提示增强从文本改写转变为从真实视频中抽取镜头级电影计划。相比直接前向扩写用户提示,该方法让训练目标与真实视频的镜头、运镜、光照等结构对齐,避免生成与视频生成器能力不匹配的夸张描述。这解决了现有提示增强模型在缺乏视觉监督时易产生语义漂移或不可实现指令的问题。
- SC-GRPO 在 GRPO 框架中加入语义一致性约束,防止模型在追求更高人类偏好分数时过度改写而丢失原始意图。传统 RLHF 通常只优化整体质量,可能牺牲跨镜头和时序上的条件保真度;SC-GRPO 将用户需求的一致性作为显式奖励项,使增强提示在增加电影化细节的同时保持可验证的语义对应。这为长视频多镜头生成提供了稳定的提示保障。
方法
WanPE 以用户原始 prompt 为输入,输出具备导演级电影规划能力的增强 prompt,指导后续视频生成。
关键模块
Video-Grounded Reverse Construction
从 1.05M 真实视频反推 shot 级电影计划(而不是从文本正向扩展)。具体做法:对视频进行分层 caption,生成包含镜头划分、动作时序、相机轨迹、光照与声音等信息的结构化描述;结合类别自适应 captioning 保证覆盖不同场景粒度。反向构造得到的监督信号使模型学习到“从视频到剧本”的映射,从而在推理时能将用户简短的意图扩展为连贯的多镜头拍摄方案。Semantic-Consistency GRPO (SC-GRPO)
在 GRPO 强化学习框架中加入语义一致性约束。奖励信号不仅关注生成 prompt 的丰富度和可执行性,还显式惩罚偏离用户原始需求的内容,确保跨镜头和长时间序列中语义不漂移。该机制在不同模型规模下均能稳健保持语义保真度。
输出
增强后的 prompt 直接驱动 Wan3.0 等视频生成器,在 5–15 秒和 30 秒任务上分别提升人类偏好 10.66–18.84 和 50.86 个百分点。
与同类 prompt 增强方法相比,WanPE 的核心差异在于用视频反向构造替代常见的正向重写,并以 SC-GRPO 强化语义一致性,避免增强过程引入用户未要求的元素。
实验
实验设计
构建 WanPEval 基准,覆盖 5-30 秒视频、不同意图粒度,采用约 11K 次盲评成对比较。以 raw user prompts 为基线,对比 WanPE-397B 及商业系统(含 Seedance 2.5)。消融实验分别验证逆向构建与 SC-GRPO 的作用。
关键发现
- WanPE 在 5-15 秒段相比原始提示提升人类偏好 10.66-18.84 点;在 30 秒段提升高达 50.86 点。
- 逆向构建(video-grounded reverse construction)显著优于前向重写(forward rewriting)。
- SC-GRPO 在不同模型规模下均能稳定保持语义一致性。
基线对比解读
WanPE 在 5-15 秒评测中超过所有商业产品,在 30 秒评测中与 Seedance 2.5 相当。这表明该模型在长视频提示增强上具备竞争力,但 30 秒场景仍有空间;其优势源于大规模真实视频训练与语义约束强化学习,为提示增强提供方向:从数据构造与优化目标两方面对齐用户意图。
行业影响
落地场景
- WanPE 可嵌入视频生成平台或创意工具,作为导演级 prompt 增强层,服务短视频创作、广告素材生成、电商商品展示、影视预演等场景。具体如:电商卖家输入「一双跑鞋在街头晨跑」,WanPE 输出含特写、侧跟、逆光、慢动作的分镜脚本,直接提升素材可用率;内容平台创作者提供一句话创意,即可获得多镜头节奏规划,降低专业门槛。
商业价值
- 降本:减少专业分镜 / 脚本人员介入,30 秒长视频人类偏好提升 50.86 点,显著减少重试与筛选时间。
- 增收 / 体验:高质量输出提升订阅或 API 增值转化;WanPEval 提供标准化评估,减少人工评测开销。该能力可包装为独立增强 API,与不同视频生成器兼容,扩大市场覆盖。
工作流集成
- 作为前置 Prompt Enhancer 模块接入现有 text-to-video pipeline:
user_prompt → WanPE → 分镜脚本 → video_generator。 - 既可部署为独立微服务 / 库,也可与现有 prompt 缓存、编排系统结合;输出为结构化分镜数据,便于下游解析与二次编辑。
- WanPEval 可作为 CI 回归基准,自动检测生成视频的语义一致性,降低模型更新风险。
局限
- **模型规模与推理成本**:WanPE 拥有 **397B 参数**,部署时需要多卡并行与高显存,实际推理延迟与吞吐未被报告。对于需要快速迭代或低资源环境的生产场景,其成本可能阻碍落地;论文未提供量化效率对比,难以评估在真实业务中的可行性。
- **评测与泛化局限**:WanPEval 由作者团队自行构建,虽然包含人工盲评,但可能引入选择与标注偏差;人类偏好测试主要基于 Wan3.0 生成器,跨生成器的迁移能力仅以消融形式提及,未与外部商业系统做严格的公平对比。缺乏对语义一致性细粒度指标的自动度量,难以定位失败模式。
- **数据与复杂场景覆盖不足**:训练集为 1.05M 真实视频,但未明确领域分布;反向构造依赖于已有视频描述质量,可能对长镜头、多角色交互、细微动作或专业领域缺乏覆盖。SC-GRPO 虽保持语义,但在 30 秒极端场景下仍可能与 Seedance 2.5 持平,说明长时序规划的鲁棒性仍有提升空间。