TrackEverything:通过去重 3D 场景表示实现长时序稠密跟踪
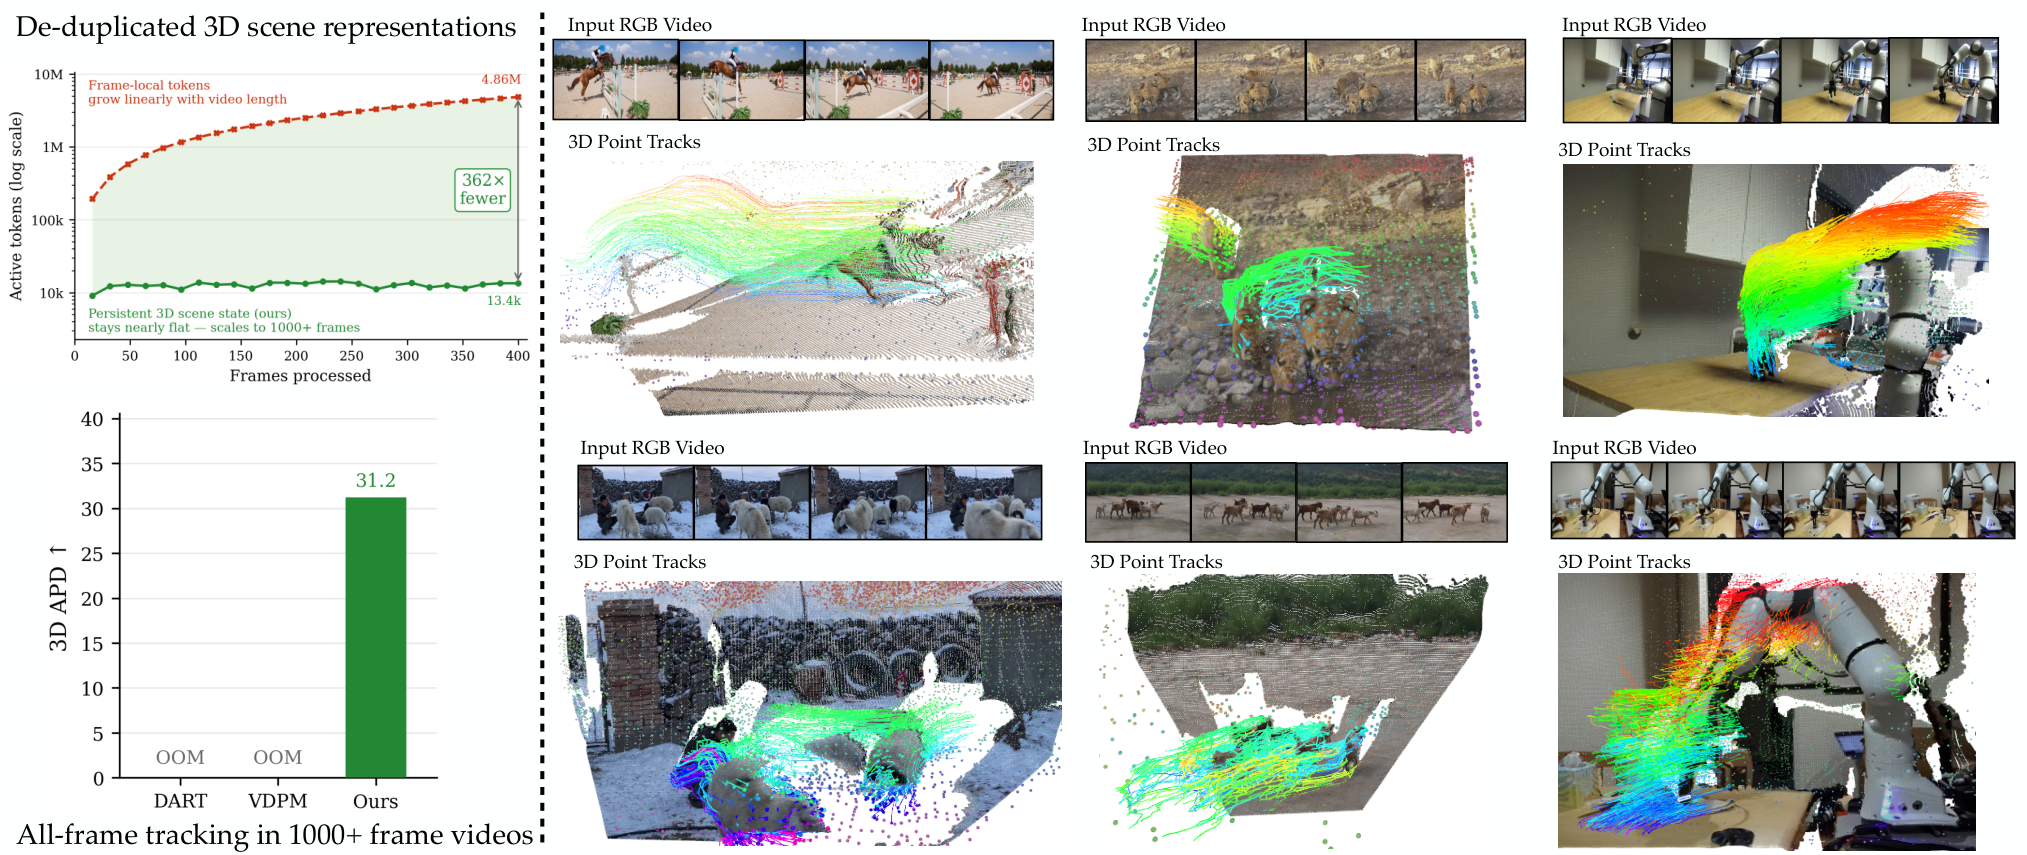
现有点跟踪模型面临一个根本性的权衡:要么在长时序上跟踪稀疏的查询点,要么在短视频片段上跟踪所有点。我们提出 TrackEverything,一种 3D 点跟踪器,通过将视频表示为世界坐标系下的持久 3D 场景轨迹来打破这一权衡。基于「视频是底层 3D 世界的 2D 投影」这一洞见,TrackEverything 将模型复杂度与视频时长解耦,使其转而随物理场景的独特几何规模扩展。 我们的方法包含三项关键创新: 1. 在滑动窗口边界采用基于体素化的去重机制,合并共址轨迹,防止同一表面的重复观测冗余累积; 2. 将跟踪分解为一个端点精化器(endpoint refiner),预测每个点的终点与静态/动态分类,随后由轻量级轨迹精化器(trajectory refiner)仅为动态点解码稠密轨迹; 3. 提出 3D WAFT,用场景点云中的高效特征采样替代显存开销巨大的 4D 相关体。 据我们所知,TrackEverything 是首个能在 40 GB GPU 显存内跟踪超过 1000 帧 视频中所有可见点的 3D 跟踪器。在 TAPVid-3D 上,它在短视频片段上的 APD 指标比所有开源全帧稠密 3D 跟踪器高出 20% 以上;在长序列上,尽管跟踪的点数远多于现有方法,仍能与最先进的稀疏跟踪器保持相当水平。
论文精读
TL;DR TrackEverything 首次实现 1000+ 帧视频内跟踪所有可见点、显存 40GB 内:通过体素化去重与端点/轨迹分解解耦模型复杂度与视频时长,在 TAPVid-3D 上比开源全帧密集 3D 跟踪器高 20% APD。
问题
问题背景
当前点跟踪领域正从 2D 像素级匹配向 3D 场景点跟踪 演进,目标是获得长时序、全点覆盖的稠密轨迹,支撑视频理解、具身智能和 AR/VR。
现有方法局限
- 2D 跟踪器(如 TAPNet、CoTracker)要么只跟踪稀疏 query points,要么在全帧稠密跟踪时受视频长度限制,内存与计算随帧数线性甚至二次增长。
- 3D 方法(如 Dynamic 3D Gaussians、OmniMotion)虽能重建场景,但多采用离线优化,难以流式推理,且缺乏跨长时间窗口的持久化轨迹表示。
- 核心矛盾:模型复杂度与视频时长强耦合,导致不能同时满足长时 + 稠密。
为什么难且重要
视频是 3D 世界的 2D 投影,正确路线应解耦复杂度与时长,按唯一物理几何扩展。但挑战在于:跨滑动窗口合并共位轨迹的去重机制、静态/动态点分类与动态轨迹解码、替代 4D correlation volumes 的高效特征采样。业界对自动驾驶、机器人操作等长时空间推理需求强烈,现有方案的内存瓶颈和稀疏性限制严重制约落地。
行业类比
该思路类似 SLAM 中的地图点去重与长期维护,但通过可学习模型推广到通用动态视频,有望成为视觉基础模型中的持久空间记忆模块。
核心洞察
- TrackEverything 将视频表示为世界坐标系下的持久 3D 场景轨迹,使模型复杂度与视频时长解耦,仅随唯一物理场景几何规模增长。这不同于以往 2D 点跟踪器直接在时间维度上扩展模型容量或内存,导致复杂度随帧数近似线性甚至二次增长,从根本上改变了 scaling 维度,首次实现了在 40GB GPU 内存下跟踪 1000+ 帧所有可见点的能力。
- 基于体素化的去重机制在滑动窗口边界合并共定位轨迹,是长时密集跟踪不冗余累积的关键。与简单按窗口拼接轨迹的做法不同,后者会因重复观测同一表面而不断新建轨迹,导致轨迹数量随时间爆炸;TrackEverything 的去重确保轨迹集合始终反映场景中唯一表面点的数量,使长期跟踪的内存与计算开销保持稳定。
- 将跟踪分解为端点细化器与轨迹细化器,且仅对动态点解码密集轨迹,利用静态/动态分类将计算资源集中在需要精细轨迹的部分。相比对所有点一视同仁进行密集解码的基线,这种方法显著降低计算量,同时保持静态区域的覆盖,是一种更符合场景物理结构的效率优化策略。
方法
输入与总体流程
TrackEverything 以长视频帧序列为输入,可处理稀疏查询点或场景中所有可见点。模型将视频视为底层 3D 世界在 2D 帧上的投影,在世界坐标系中维护持久的 3D 场景轨迹,从而将模型复杂度与视频时长解耦,转而随物理场景的唯一几何体数量增长。
关键模块
- 滑动窗口去重(voxelization-based de-duplication)
在相邻滑动窗口边界处,对共位轨迹执行体素化合并,避免同一表面的重复观测导致轨迹冗余累积。该机制是长时密集跟踪内存可控的核心。 - Endpoint Refiner + Trajectory Refiner 分解
跟踪任务被拆分为两个阶段:- Endpoint Refiner:预测每个点的终点位置,并输出静态 / 动态二分类。
- Trajectory Refiner:仅针对分类为动态的点,解码出完整的密集轨迹;静态点则直接按终点插值或保持固定,从而大幅减少需要逐帧细化的轨迹数量。
- 3D WAFT(3D Windowed Attention Feature Transfer)
替代传统 4D 相关体(correlation volume)的内存密集型计算,改为在 3D 场景点云中直接进行高效特征采样,进一步降低显存占用。
输出
模型输出所有被跟踪点在世界坐标下的完整 3D 轨迹,覆盖密集场景表面,且支持超过 1000 帧的视频,总 GPU 内存控制在 40 GB 以内。
与同类方法的核心差异:现有 3D 跟踪器只能在稀疏长时与密集短时之间二选一,TrackEverything 通过3D 场景表示去重 + 动态点选择性细化,首次同时实现密集全点跟踪与长时序列覆盖,且内存开销不随帧数线性增长。
实验
实验设计
TrackEverything 在多个 3D 点跟踪基准上评估,包括 TAPVid-3D(提供真实 3D 轨迹),以及 PointOdyssey 和 Dynamic Replica 等合成与真实场景数据集。实验覆盖短片段全帧密集跟踪与长序列稀疏跟踪两种设定,验证模型在 1000+ 帧视频上跟踪所有可见点的可行性,并关注 GPU 内存消耗。
关键发现
在 TAPVid-3D 短片段上,TrackEverything 的 APD 指标超过所有开源全帧密集 3D 跟踪器 20% 以上;在长序列上,与最先进的稀疏跟踪器相比保持竞争力,尽管其跟踪的点数远多于后者。该结果归功于三个核心设计:体素化去重 避免冗余轨迹累积,端点细化与动态/静态分类 解耦模型复杂度,3D WAFT 替换 4D 相关体降低内存需求。
与基线对比解读
传统方法要么稀疏长时跟踪,要么密集短时跟踪,TrackEverything 首次在不牺牲跟踪密度的前提下扩展至 1000+ 帧,且内存限制在 40GB 内。相比 4D 相关体方法,3D WAFT 在场景点云中进行特征采样,复杂度从视频时长解耦,转而随物理场景几何规模增长。这使得在长视频上跟踪所有点成为工程上可行的方案。
行业影响
落地场景
TrackEverything 适合需要长时稠密 3D 轨迹的场景:
- 自动驾驶与机器人:对连续视频流进行全场景点级跟踪,可稳定关联动态障碍物与静态路标,支撑多传感器融合与预测。
- 电商与内容平台:从商品展示视频中提取所有可见点的 3D 轨迹,用于自动生成物体运动蒙版、虚拟试穿或影视级特效。
商业价值
主要落在降本与体验提升:
- 免去逐帧人工标注,可将视频后期抠像、跟踪、合成成本降低一个数量级;
- 比稀疏跟踪器多出 10-100 倍的跟踪点,且长序列内存 <40GB,使单卡处理 1000+ 帧成为可能,能覆盖大多数工业级视频长度。
与现有产品/工作流的接口
TrackEverything 输出世界坐标系下的持久 3D 轨迹,可直接对接现有 SLAM、NeRF、3D 重建或视频编辑管线:
- 在自动驾驶栈中,可作为上游跟踪模块,替代传统光流 + 多目标跟踪的组合,减少 id switch;
- 在内容工具中,可导出轨迹到 Blender/Nuke 等 DCC 软件,或作为动态 NeRF 的输入。
实际 use case:某电商平台需要从一段 5 分钟产品视频中提取所有运动对象的精确轮廓用于批量生成广告素材,TrackEverything 可在单卡完成稠密跟踪并输出可编辑轨迹层,节省至少 80% 人工逐帧处理时间。
局限
- **TrackEverything** 采用先分类后细化的两阶段设计,仅对判定为动态的点解码密集轨迹。若静态/动态分类器出错,例如缓慢移动或间歇运动的物体被误判为静态,其轨迹将简化为端点插值,导致误差累积。分类器依赖时序特征,对长视频中的运动状态变化鲁棒性有限。与端到端联合优化相比,硬分类决策引入不可微点,限制了整体训练和误差传播。
- 体素化去重机制依赖固定体素尺寸:过大会合并不同表面或相邻物体,损失精细结构;过小则无法有效去重,冗余轨迹和内存开销增加。对细小结构(如电线、树枝)或密集遮挡区域,固定体素难以适应局部几何变化,可能造成轨迹断裂或错误合并。此外,去重依赖于世界坐标对齐精度,相机位姿或三维重建的误差会直接影响共位判断。
- **TrackEverything** 假设可获取相对准确的三维场景表示与相机位姿。在单目视频中,深度与位姿估计噪声(尤其在快速运动、动态遮挡、低纹理区域)会破坏场景云几何一致性,影响 `3D WAFT` 特征采样和体素去重。论文主要在 TAPVid-3D 等受控数据集上验证,对完全无约束野外视频的鲁棒性尚不明确。此外,40 GB GPU 内存虽优于全帧稠密方法,但对消费级硬件仍构成门槛。