Jev in the Wild:对 Jev 模型功能、应用与生态的数据驱动分析
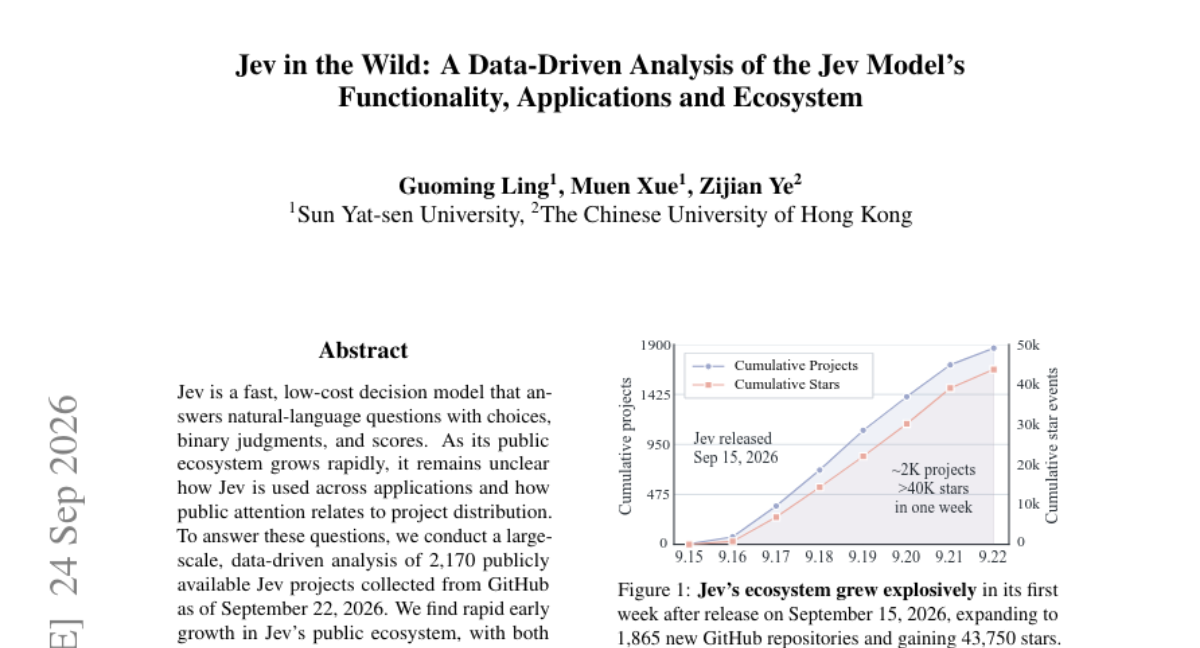
Jev 是一种快速、低成本的决策模型,能以选项、二值判断和打分的形式回答自然语言问题。随着其公开生态快速扩张,Jev 在各类应用中的实际使用方式、以及公众关注度与项目分布之间的关系仍不清晰。为此,我们对截至 2026 年 9 月 22 日从 GitHub 收集的 2,170 个公开 Jev 项目 进行了大规模数据驱动分析。 我们发现 Jev 的公开生态在早期增长迅速,既体现为新建项目,也体现为对已有仓库的集成。在多样化领域中,项目将 Jev 用于多种决策目的,并组合使用其不同接口: - 属性判断 与 打分 被广泛使用; - 动作选择、内容过滤 以及 模型与工具选择 的使用则因领域而异。 这些模式表明,Jev 充当了一个可复用的决策组件,其功能随周边工作流而变化。与此同时,公众关注度集中在 routing 与 interface agents 上,且并不跟随项目数量变化。 我们的发现为 Jev 正在形成的生态提供了量化视角,并为跨多样应用场景的通用决策模型的设计与评估提供了参考。
论文精读
TL;DR 基于 2170 个 GitHub 项目的大规模分析,揭示 Jev 作为低延迟决策模型在真实生态中的使用模式:属性评分与二元判断广泛采用,而公众关注集中在路由与接口代理,与项目分布脱节。
问题
问题背景
AI 应用正从生成式模型向决策型组件延伸。Jev 这类快速、低成本的决策模型能以自然语言输出选择、二元判断和分数,并被集成到各类软件工作流中。但业界对其真实使用模式、领域分布和公众关注度缺乏系统认知。
现有方法局限
现有研究主要依赖小规模案例或定性观察,难以刻画生态全貌。传统分类方法(如基于规则或监督学习)无法适应决策接口组合多样、跨域差异显著的情况。此外,Jev 的公开项目分布在 GitHub 上快速演变,但缺乏统一的数据采集与标注流程,导致结论可重复性弱。与已有大规模代码分析工作相比,本研究强调决策模型的接口组合与领域差异,而非单纯统计项目数量。
为什么这个问题难/重要
决策模型的功能受上下文工作流影响,同一模型在不同领域可扮演动作选择、内容过滤、模型与工具选择等不同角色,单一基准难以评估其通用性。同时,公众注意力(如路由代理和接口代理)与项目数量并不匹配,这提示评价模型价值不能只看代码仓库数量。理解这些差异对设计下一代通用决策模型、优化资源投入具有直接工程意义。
行业类比
类似语义路由层(如 LLM 应用中的 intent router)虽被广泛讨论,但对其实际部署模式的大规模实证分析同样稀缺;本研究为决策组件生态提供了可参考的量化范本。
核心洞察
- Jev 的实际形态更接近一个可复用决策组件,而非独立的任务求解器。论文对 2,170 个 GitHub 项目的分析显示,属性判断和评分接口被广泛采用,而动作选择、内容过滤、模型与工具选择等接口在不同领域的使用差异明显,说明 Jev 的功能边界由宿主工作流定义。这与传统将决策模型作为固定任务集上评测对象的做法不同,揭示了通用决策模型的真实价值可能在于低耦合嵌入能力,而非单一任务精度。
- 公众注意力与项目供给之间存在明显脱节:注意力集中在 routing 和 interface agents 领域,但项目数量并不与关注度成正比。这一发现挑战了仅凭仓库数量或 star 数评估生态健康的方式,说明对通用决策模型生态的评估需要区分高价值集成点与长尾项目,并将工作流关键度纳入度量体系。
方法
数据获取与预处理
研究以 GitHub 公开仓库为输入,截止 2026-09-22 收集 2,170 个包含 Jev 的项目。候选检索通过代码搜索与依赖引用(如 jev 包)识别;项目验证排除仅提及 Jev 但未实际调用的仓库;标注阶段对每个项目打上应用领域、决策目的、接口使用等标签。
关键分析模块
- 增长趋势:统计项目创建时间与集成到既有仓库的时间分布,刻画生态扩张曲线。
- 用途分类:按领域(如浏览器操作、代码评审、工具调用风险、模型路由、游戏控制等)归纳,并标注决策目的(选择、二元判断、评分)和接口组合(如
classify、score、select)。 - 目的组合分析:交叉领域与决策目的,识别通用决策组件特征。
- 供给与关注对比:用 GitHub star 和项目引用热度量化公众注意力,与项目数量分布对比。
输出
输出定量结论:Jev 生态早期快速增长,属性判断与评分是高频用途,路由/界面代理获得不成比例的关注度。
与同类方法的差异点:不同于以基准测试为中心的单模型评估,本研究从真实公开仓库中逆向提取使用模式,提供生态系统层面的实证证据。
实验
实验设计
该研究以 数据挖掘 + 标注分析 为核心,没有传统模型训练或推理基线。语料为截至 2026-09-22 从 GitHub 收集并通过验证的 2,170 个公开 Jev 项目。流程包括候选检索、项目验证、人工标注,随后统计项目增长趋势、应用领域、决策目的与接口组合。分析维度包括:领域分布、决策目的(属性判断、评分、行动选择、内容过滤、模型与工具选择)及跨领域组合,并对比项目数量与公共关注度。
关键发现
- 生态快速增长:新项目与既有仓库集成并行,说明 Jev 被当作可复用决策组件嵌入多种工作流。
- 接口组合多元:属性判断与评分使用最广;行动选择、内容过滤、模型与工具选择在不同领域差异明显。
- 关注度错配:公共关注集中在路由与接口 agent,但项目数量并不与关注度正相关,存在供给与注意力偏离。
与基线对比及工程启示
没有传统 SOTA 对比,但跨领域差异本身构成“隐性基线”:Jev 的通用决策能力随上下文工作流被特化。这提示工程团队:评估此类通用决策模型时,不应只看仓库数量或 star,而要按领域内任务成功率和接口组合合理性来度量;路由类 agent 虽然受关注多,但实际项目分布更广泛,投入需结合真实使用密度。
行业影响
落地场景
Jev 作为一个快速、低成本的决策模型,天然适合嵌入需要高频、低延迟判断的业务环节:
- 内容平台:用 Jev 做评论过滤、内容分级、敏感度评分,在不调用大型 LLM 的情况下完成初筛。
- 电商推荐:对用户查询做意图分类(搜索 vs. 比价 vs. 售后)或对商品描述做合规性判断,降低后端复杂模型的压力。
- 企业服务:在客服工单系统中用 Jev 做自动路由(退款 / 技术 / 销售),或对合同条款做风险等级打分。
商业价值
核心价值在于成本降低和响应提速:
- Jev 以远低于通用 LLM 的推理成本完成二元判断、评分与选项选择,适合大规模批量调用。
- 在精度要求中等的场景下,Jev 可替代或预筛选 GPT-4 级别模型的调用,直接减少 API 费用。
- 延迟敏感型应用(如实时风控、在线游戏决策)可从 Jev 的秒级或亚秒级响应中获益,改善用户体验。
与现有产品/工作流的接口
Jev 可作为可复用决策组件集成到现有 AI 栈中:
- 在 LLM Agent 工作流 中,Jev 可用于工具选择、参数校验、风险门控,减少不必要的模型调用。
- 在 CI/CD 或代码审查 中,Jev 可做快速 triage,标记高优先级问题再交给人或重型模型。
- 与函数调用(function calling)配合,Jev 先判断是否执行某个工具,再决定是否调用完整 LLM,形成两级决策架构。
论文数据表明,Jev 已在路由和接口代理类项目中获得最多关注,说明其作为决策中间件的定位符合当前 Agent 生态对轻量判断的需求。
局限
- **数据来源偏差**:分析仅覆盖 GitHub 上的公开项目(截至 2026-09-22),无法观测私有部署、企业内网或其他代码托管平台上的 `Jev` 使用情况。这可能导致对生态规模的**低估**,且早期阶段的部分热门项目可能尚未公开或已删除。同时,时间窗口有限,无法反映后续趋势变化,结论的**外部效度**受限于平台和时间点。
- **标注与分类主观性**:项目验证与标注依赖人工判断,文中未报告标注者间一致性(如 Cohen's κ),可能导致对决策目的、应用领域和接口使用的分类存在偏差。分类体系(如 action selection、content filtering 等)可能过于粗粒度,无法捕捉更细化的使用模式,影响结论的**可复现性**与**信度**。
- **缺乏因果解释与对比**:论文发现公共注意力与项目分布不匹配,但未深入分析原因(如营销效应、开发者群体差异);也未将 `Jev` 与其他决策模型(如专用分类器、直接使用 LLM 进行决策)进行对比,无法说明 `Jev` 的独特价值或性能优势。未来可增加定性访谈或对照实验,以提供更深入的洞察。