SAGE: 通过拓扑引导缓解长视界推理偏差
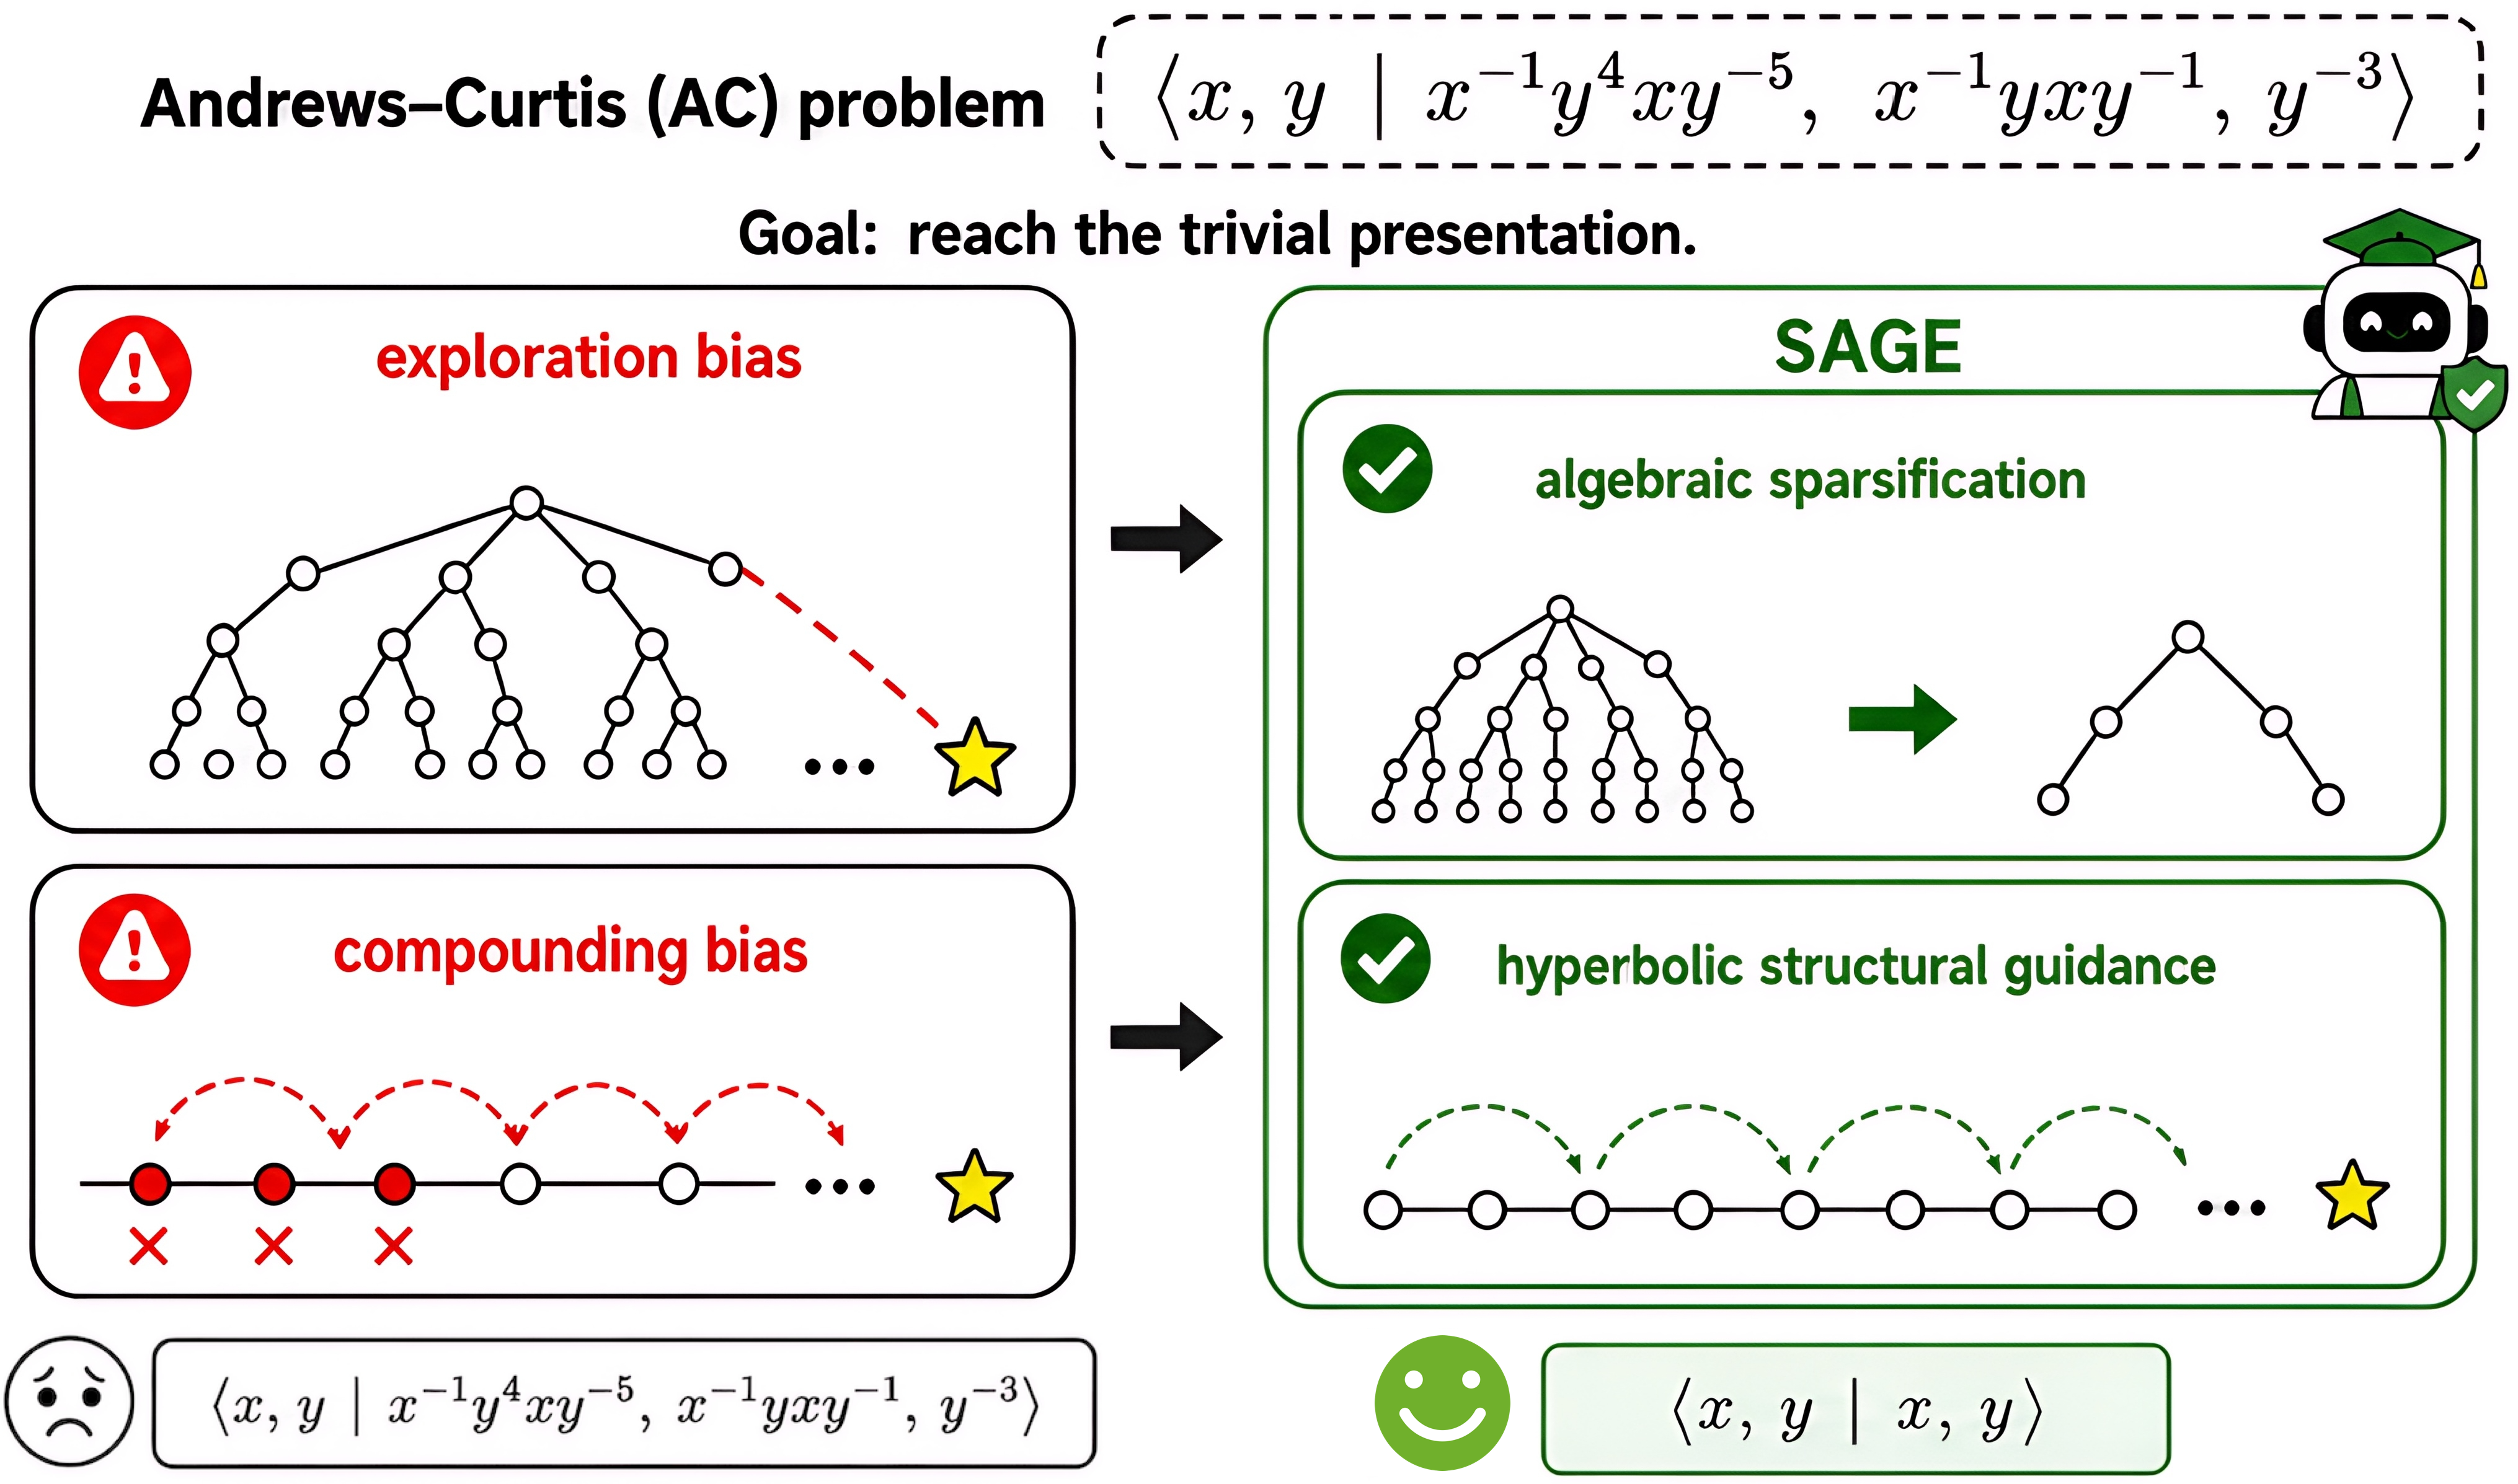
长视界推理(long-horizon reasoning)在稀疏奖励设定下仍是大型语言模型(LLM)的核心难题。作者认为,这种脆弱性源于复杂推理空间带来的两种偏差:探索偏差(exploration bias),模型被引向局部看似合理但结构不稳定的分支;累积偏差(compounding bias),微小的局部偏离沿深度不断累积,进而压制稀有奖励。 为刻画这一现象,作者提出 Symbolic Closure Analysis(SCA),既作为理论视角揭示分支结构与稀疏奖励如何在局部可接受的长视界推理中诱发上述偏差,也作为形式化程度较低任务中结构先验的设计原则。基于该分析,作者提出 SAGE(Structural Admissibility-Guided Exploration) 统一框架,注入结构引导以缓解两类偏差,包含两种互补机制: 1. 代数稀疏化(algebraic sparsification):将局部可接受的候选投影到以算子为索引的代数子空间,抑制虚假分支,缓解探索偏差; 2. 双曲结构引导(hyperbolic structural guidance):将推理状态嵌入负曲率空间,提供稠密的逐深度信号,缓解累积偏差。 在 12 个 benchmark 与 7 个模型族上的实验表明,SAGE 优于各竞争基线,并在开放的真实长视界任务 Andrews-Curtis 问题上最高取得 8 倍提升。代码见:https://github.com/Susan571/SAGE-NeurIPS2026。
论文精读
TL;DR SAGE 通过代数稀疏化与双曲结构引导,缓解长时程推理中的探索和复合偏差,在 Andrews-Curtis 等任务上最高提升 8 倍。
问题
问题背景:当前长程推理(long-horizon reasoning)在数学证明、代码生成、规划等任务中成为 LLM 的核心瓶颈,稀疏奖励下模型难以稳定收敛。
现有方法局限:
- 基于 outcome reward 的 RL 训练只在轨迹末尾给稀疏信号,无法区分“局部可行但全局失败”的分支,直接导致 exploration bias 泛滥;
- 基于 process reward model (PRM) 的方法需要逐步标注,成本高且步骤正确性并不等价于整体可闭包,对 compounding bias 的抑制有限;
- 常见 beam search 或 MCTS 仅依赖局部打分剪枝,没有利用推理空间中的代数结构(如
operator closure、group action),仍会保留大量伪分支。
为什么难/重要:长程任务每一步可能满足局部 admissible 条件,但组合后可能违反全局闭包性;状态空间指数增长与奖励稀疏叠加,造成信用分配极难和梯度消失。业界在 theorem proving、autoformalization、复杂代码生成等场景对结构引导的探索策略需求强烈。
行业类比:类似符号执行中需要路径可行性判定而非仅检查单条语句合法,SAGE 的拓扑引导相当于给推理过程加了一层“结构编译器”,提前剔除不可闭包的分支。
核心洞察
- SAGE 提出了符号闭包分析 (SCA) 这一理论透镜,将长时程推理中的脆弱性归因于两类与分支结构交互的偏差:探索偏差(局部可采纳但结构不稳定)和复合偏差(局部误差随深度累积)。与仅从稀疏奖励或模型容量解释不同,SCA 从拓扑角度揭示了偏差的结构根源,使设计者能够根据局部可采纳性条件确定何时何地注入何种结构先验,从而实现可操作的干预。这一视角为将形式化推理中的结构规律迁移到非形式化任务提供了原则,区别于依赖更多采样或过程奖励的现有方案。
- SAGE 通过代数稀疏化与双曲结构引导两种互补先验直接干预候选生成:代数稀疏化将可采纳候选投影到算子索引代数子空间,大幅削减虚假分支;双曲结构引导将状态嵌入负曲率空间,为深度维度提供稠密信号,缓解复合偏差。与过程监督 (PRM) 仅提供局部反馈、树搜索依赖启发式不同,SAGE 修改的是搜索空间本身,从源头降低分支因子并注入全局深度信息,因此对形式化和非形式化长时程任务均适用,且不需要昂贵的逐步骤标注。
- 在开放数学难题 Andrews-Curtis 上取得最高 8 倍提升,验证了 SAGE 对真实世界稀疏奖励长时程任务的有效性。该任务具有大量未知可行变换和极稀疏成功信号,现有方法常陷入探索困境;SAGE 的结构引导使其能够稳定发现稀有解,表明拓扑先验在处理开放长时程推理时具有实质性优势,为其他类似任务提供了可借鉴的设计路径。
方法
方法流程
输入:给定自然语言问题或初始状态,经状态编码器得到每个推理步骤的表示。
关键模块:
- 代数稀疏化:将局部可采纳的候选步骤投影到 operator-indexed algebraic subspaces,通过残差表示和 Greedy Sparse Locator 选择支持算子,过滤伪分支,缓解探索偏差。
- 双曲结构引导:将推理状态嵌入到负曲率双曲空间,提供深度方向的稠密信号;训练时采用轨迹级重加权与软可行支持集中调整奖励,缓解累积偏差。
输出:在生成每一步时,综合结构引导对候选排序,逐步输出长程推理的最终解。
与同类方法的差异:SAGE 不依赖密集过程奖励模型或人工过程标注,而是基于 SCA(Symbolic Closure Analysis)导出的闭合性先验进行结构化探索约束,从拓扑层面同时缓解两类偏差。
实验
实验设计
论文在 12 个基准 与 7 个模型家族 上评估 SAGE,任务覆盖长时程推理,包括 Andrews-Curtis 问题、闭式数学推理和自由形式自然推理。同时包含组件消融分析,验证代数稀疏化与双曲结构引导的各自贡献。
关键发现
- SAGE 在所有基准上均优于竞争基线;
- 在 Andrews-Curtis 问题 上实现 最高 8 倍提升,该任务为开放式长时程推理,表明方法有效抑制探索偏差与复合偏差;
- 消融实验(原文提及但未展示具体数字)显示两个组件的互补性。
与基线对比解读
SAGE 的核心差异在于同时提供拓扑层面的结构先验:代数稀疏化削减虚假分支,双曲嵌入提供深度密集信号。相较仅依赖过程监督或奖励塑形的基线,SAGE 更系统地解决稀疏奖励下的分支爆炸与误差累积问题,尤其在长时程、局部可行但全局不稳定的场景中表现出显著优势。
行业影响
落地场景
- 长时程推理增强:适用于需要多步逻辑与规划的产品,如数学定理证明助手、代码生成、复杂客服对话策略、药物分子设计。
- 具体场景:电商平台智能客服处理退换货协商的多轮谈判;在线教育中逐步引导解题,需维持正确推理路径。
商业价值
- 降本:减少失败重试带来的推理 token 消耗,最高 8 倍成功率提升可显著降低服务成本。
- 增收:提升复杂任务自动化完成率,扩大可处理业务范围,替代部分人工审核与专家介入。
- 体验提升:减少模型在长推理中迷失导致的错误回答,提高用户信任与留存。
与现有工作流的接口
- 作为推理时模块:在 LLM 解码过程中对候选 token 或状态进行代数稀疏化剪枝,注入深度评分信号,可与 beam search、MCTS 结合。
- 作为训练时后处理:将 SAGE 的结构奖励与已有 RLHF/GRPO 流程融合,无需重训基座模型。
- 与 vLLM / TensorRT-LLM 等服务框架集成,低延迟开销。
具体 use case
- 电商智能客服谈判:用户就退款金额进行多轮协商,模型需在稀疏奖励(最终达成协议)下探索正确路径。SAGE 通过 代数稀疏化 抑制不稳定的局部分支,避免中途给出不合理承诺;双曲结构指导 提供深度信号,防止偏离目标。
- 企业 IT 工单自动化:处理“权限申请-审批-执行”多步骤流程,涉及多分支和长依赖。SAGE 可嵌入 RPA 或 Agent 框架,提高流程执行成功率,减少人工接管。
局限
- - **理论假设与任务约束**:SAGE 的理论基础 SCA 依赖局部可采纳性(local admissibility)和代数闭包,这使其直接适用场景偏向具有明确运算符和符号结构的任务(如数学证明、定理求解)。对于自由形式自然语言推理,作者承认 SCA 只能作为 design principle,但如何将自然语言状态映射到 operator-indexed algebraic subspaces 仍不清晰,可能需要大量人工特征工程或近似,削弱通用性。
- - **计算与实现复杂度**:SAGE 同时引入代数稀疏化和双曲结构指导,涉及状态编码、双曲空间投影、greedy sparse locator 等模块,训练和推理开销可能明显高于标准 SFT/RLHF 流程。论文虽提供了 recovery guarantee 和基于相对 margin 的样本重加权策略,但对大规模 LLM 部署时的额外延迟、显存占用及优化稳定性未充分讨论,工程落地门槛较高。
- - **实验评估与基线对比**:虽然覆盖 12 个 benchmarks 和 7 个 model families,但主要性能增益来自 Andrews-Curtis problem 这类代数结构极强的任务,8 倍提升可能具有任务特异性。对自然语言规划等弱结构场景,增益幅度未在主结果中单独量化。与 Process Reward Model(PRM)等强基线的详细对比置于附录,且未提供统一奖励预算下的公平性分析,可能高估方法优势。