词性作为 SAE 潜在空间中的涌现类别
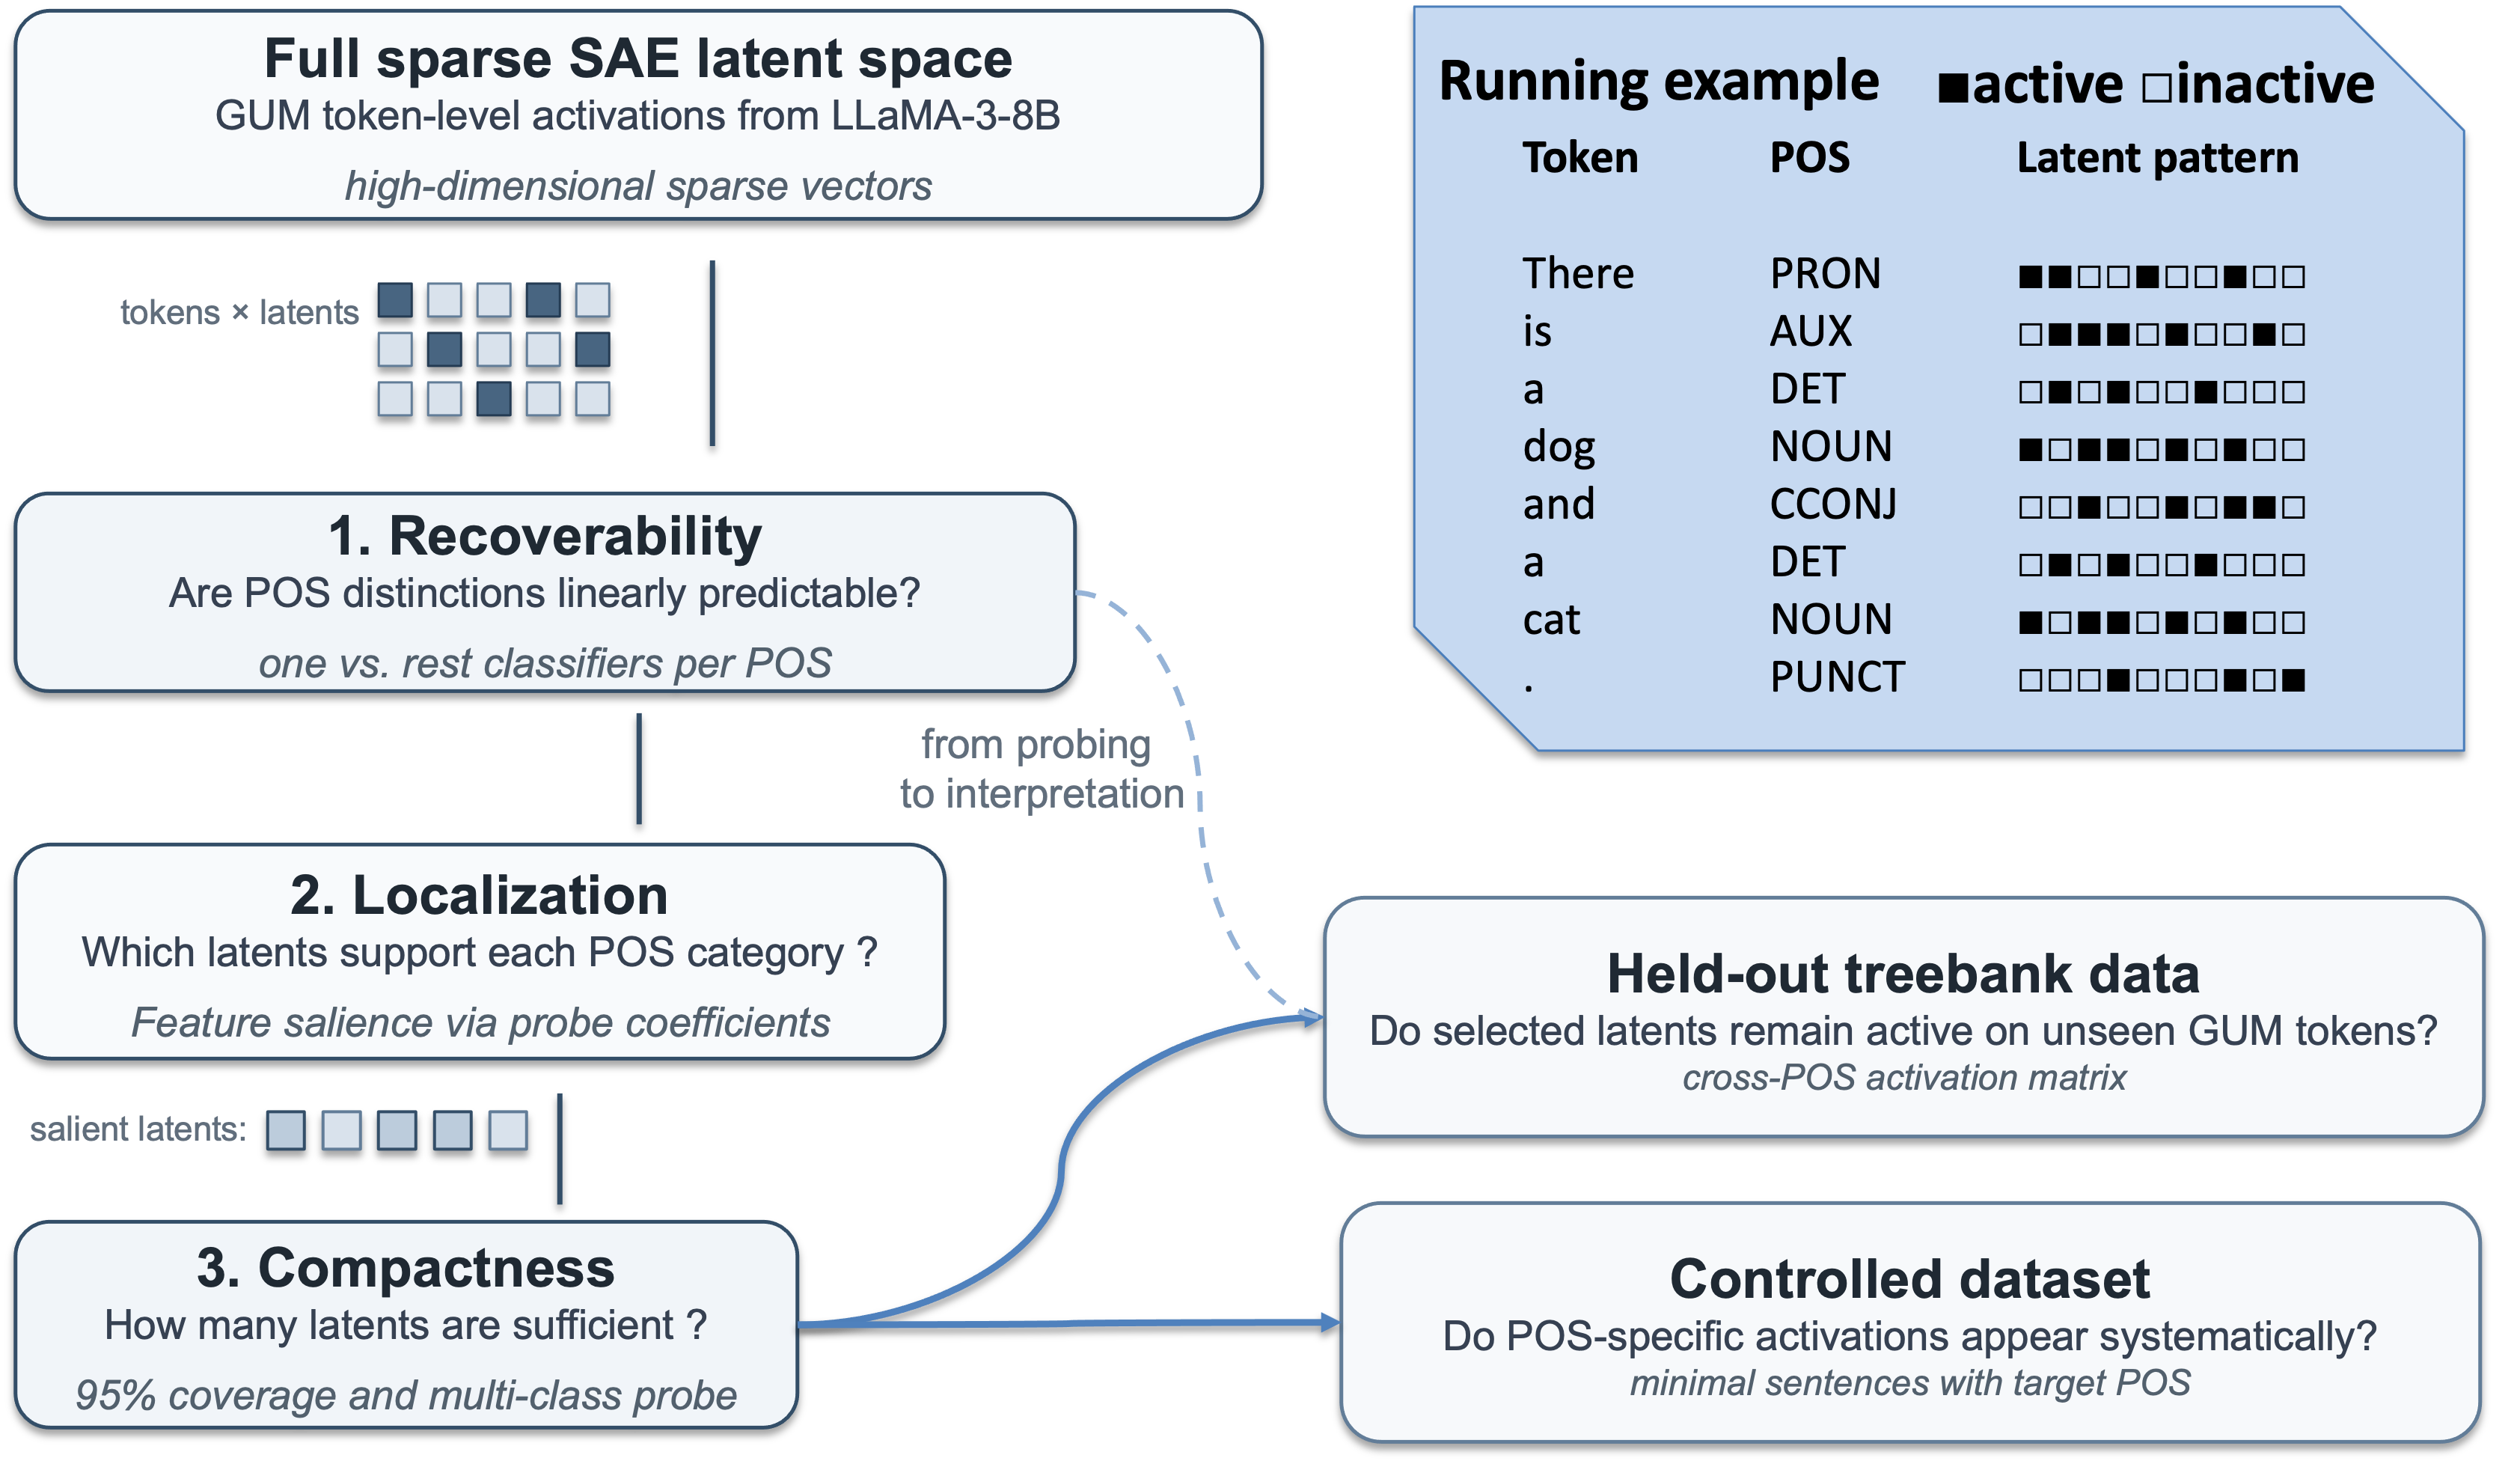
Sparse AutoEncoders(SAE)为探查语言模型表示提供了新途径,但其 latent 究竟暴露何种语言结构仍不明确。本文以词性(PoS) 类别作为受控测试用例,考察形态-句法信息究竟由单个 latent 编码,还是由结构化的特征组编码。 实验表明,PoS 区分可从 SAE 激活 中高度恢复,但并不对应一对一的 latent–类别映射,且这种可恢复性无法归约为词汇记忆;开放类与封闭类 PoS 差异显著。各类别由紧凑的稀疏 latent 组 支持,且不同标签间存在明显差异;这些组在 held-out 数据 上保持稳定,同时相关类别之间也存在重叠。 结论:SAE 以分布式、依赖类别 的形式定位形态-句法信息,而非通过原子化的语法特征。
论文精读
TL;DR 研究以词性为受控探针,发现 SAE 潜在空间以紧凑分布式特征组编码形态句法信息,而非原子语法特征;可恢复性高且不依赖词汇记忆,开放/封闭类差异显著。
问题
问题背景:近年来,稀疏自编码器(SAE)成为解析大型语言模型内部表征的主流工具,但其 latent 空间究竟编码了何种语言结构仍不明朗,成为可解释性研究的核心问题之一。
现有方法局限:多数工作假设单个 SAE latent 对应原子概念或特征,尝试为特定语法现象寻找 one-to-one 映射。但该假设缺乏系统验证:线性探测虽能确认信息存在,却无法揭示编码的分布式性质;单个 latent 分析忽略了特征之间的组合与重叠关系;且现有工作很少区分开放词类与封闭词类在表征上的差异,导致结论泛化性不足。此外,对 PoS 等基础语法范畴的检测多依赖有监督分类器,未充分考察 SAE 激活本身的结构化组织。
为什么这个问题难/重要:语言模型中的形态句法信息具有分布式、上下文依赖的特点,而 SAE 的稀疏约束可能改变原始表征的几何结构,使得真实编码方式介于原子特征与完全分布式之间。理解这一点对可解释性工具的实际应用至关重要:如果特征组是紧凑且稳定的,就能支持更精准的特征级操控与模型编辑;若仅靠单 latent 则难以定位。业界关注如何在庞大的 latent 空间中高效发现语法相关的特征组,以降低调试与审计成本。
行业类比:类似推荐系统中用户嵌入的维度并不直接对应单一兴趣,而是多个兴趣的组合模式;同样,SAE latents 中的语法信息可能由特征组而非孤立单元承载,这提示我们需要发展新的分析范式。
核心洞察
- SAE 的 latents 以紧凑且重叠的特征组编码形态句法信息,而非原子语法特征。该发现挑战了先前将单个 latents 映射到单一语言概念的假设:论文通过 PoS 分类实验表明,每个词性由多个稀疏特征协同支持,且相关类别共享部分特征,体现了分布式和类别依赖的编码。这提示在解释 SAE 特征时,孤立地寻找“名词神经元”会忽略真实结构,必须分析特征组及其重叠关系。
- 开放类与封闭类词性在 SAE 表征中差异显著,且词性可恢复性不依赖词汇记忆。区别于将 SAE 激活归因于高频词或表面共现的基线,论文在 held-out 数据上验证了泛化性,并通过控制实验排除记忆因素。封闭类(如介词、限定词)的激活更集中,开放类(如名词、动词)更分散,提示模型对功能词和实义词采用不同内部组织策略。该结果对基于 SAE 的语法探测和可控生成有工程参考价值。
方法
输入与数据
研究使用 GUM treebank 作为词性标注语料,提供 token 级别的 PoS 标签。语言模型采用 LLaMA-3-8B,稀疏特征由 EleutherAI SAE 提取。
关键模块
- Token-level Activations Extraction:对每个 token 获取 SAE 激活向量,得到该 token 的稀疏潜在特征表示。
- Sparse Feature Matrix Construction:将所有 token 的激活整理为特征矩阵,作为下游分析的基础。
- Recoverability 实验:在 SAE 激活上训练线性分类器预测 PoS 标签,评估词性信息是否可从激活中恢复。
- 特征组织分析:通过特征显著性、覆盖度和紧凑性指标,识别支持特定 PoS 的稀疏特征组,并衡量其内部一致性与类别间重叠。
- Held-out 验证:在留出数据上验证特征组的稳定性,排除对训练集的过拟合。
- Controls and Baselines:设置对照实验,区分词性信息是来自词形记忆还是真正的语法抽象。
输出
结果表明 PoS 信息高度可恢复,但不对应一对一 latent/类别映射;Open 与 Closed 词类表现显著不同;类别由紧凑的稀疏特征组支持,且存在类别相关的变化与重叠。
与同类方法的差异点:不同于假设单个潜在单元对应原子语法特征的工作,本研究强调 SAE 潜在空间中以分布式、特征组形式存在的词性结构,并系统验证其跨数据稳定性与可解释性。
实验
实验设计
本文基于 LLaMA-3-8B 的 token 级激活,通过 EleutherAI SAE 构建稀疏特征矩阵,在 GUM treebank 上系统分析词性信息。研究分三组实验:
- RQ1 考察 PoS 信息从 SAE 激活中的可恢复性
- RQ2 分析 PoS 在潜空间的组织形态,包括特征显著性、覆盖率与紧凑性
- RQ3 在留出数据上验证特征组的稳定性
同时设置控制实验检验词汇记忆影响,并对比开放/封闭词类差异。
关键发现
PoS 信息高度可恢复,但不存在一对一的 latent-category 映射。
- 可恢复性不来自词汇记忆,表明 SAE 编码了语法泛化信息
- 开放词类与封闭词类差异显著,反映形态句法信息分布的非均匀性
- 类别由紧凑的稀疏 latent 组支撑,不同 tag 之间的组大小和结构变化较大
- 这些特征组在 held-out 数据上保持稳定,且相关类别间存在重叠
结果表明 SAE 以分布式、类别依赖的形式局部化形态句法信息,而非原子语法特征。
基线对比解读
传统可解释性工作常寻找单个 latent 对应单个语言特征,本研究作为对照验证了这种假设的局限。与原子特征基线相比,特征组模式 更好地解释了 SAE 激活中的语法结构。词汇记忆控制实验进一步排除了表面共现的干扰,提示 SAE 确实捕捉了抽象词类信息。开放/封闭词类的差异也与语言学预期一致:封闭词类功能性强,可能由更紧凑、更专用的特征组表示,而开放词类依赖更分散的语义-语法混合特征。
行业影响
落地场景
论文揭示 SAE 的稀疏特征以分布式、类别依赖的方式编码词性信息,且特征组紧凑、跨数据稳定。这为以下场景提供直接支撑:
- LLM 可解释性与调试:将 PoS 相关特征组嵌入可观测性平台,对模型生成中的语法异常进行 token 级归因,加速错误定位。
- 可控文本生成:在电商文案、教育语法纠错等产品中,通过操纵或约束 PoS 特征组的激活,实现词性层面的风格控制或后编辑。
- 数据质量筛选:利用 PoS 特征恢复度作为语料语法合规性的快速代理指标,过滤低质量训练数据。
商业价值
- 降本:减少人工语法审核与语料清洗工作量,尤其适用于大规模 UGC 平台。
- 增收:提升内容平台发布质量,降低因语法错误导致的用户流失;在营销文案生成中保证词性搭配正确,提高转化率。
- 体验提升:为语法检查、写作助手提供可解释的修改依据,不只给出纠错结果,增强用户信任与学习效果。
与现有产品/工作流的接口
- 将 SAE 编码器作为旁路分析模块接入推理 pipeline,无需修改主模型权重。
- 预先提取 PoS 相关特征组索引并保存为轻量配置,供规则引擎或小型分类器调用,降低在线计算开销。
- 与 TransformerLens、SAELens 等可解释性库集成,输出 token 级 PoS 归因热图,嵌入现有监控看板。
具体落地 use case:
- 内容平台 UGC 质量管控:对用户评论/帖子实时计算 PoS 特征激活密度,检测异常语法结构并触发自动修改建议,减少人工审核队列。
- 教育写作辅助:在在线写作工具中,利用 SAE PoS 特征组解释“为什么这里词性错误”,而非仅给出修正,帮助学生理解语法规则。
局限
- **模型与 SAE 拓扑单一**:实验仅使用 `LLaMA-3-8B` 与 `EleutherAI SAE` 一种 Sparse Autoencoder,且文本来源为英文 `GUM treebank`。SAE 的字典大小、稀疏度约束和训练目标会显著影响 latent 分解形态,不同 SAE 变体(如 `TopK`、`Gated`、`JumpReLU`)可能产生不同粒度的特征分组;单一模型规模也限制了对 emergent PoS 结构是否随模型容量变化的判断。因此,结论“PoS 信息呈分布式紧凑组而非原子特征”能否推广到其他 LLM 或 SAE 尚未可知。
- **缺乏因果与下游任务验证**:研究主要通过线性探针和稀疏特征重构来评估 PoS 可恢复性,属于相关性分析。文中未对识别出的紧凑特征组做消融或激活操控(activation steering),无法证明这些 SAE latents 对模型生成或句法行为具有因果作用;同时未验证这些特征在真实下游任务(如依赖解析、语法纠错)中是否能提升可解释性或模型行为,因此实践指导意义有限。
- **分析粒度与层级时效受限**:实验选择单一最优层进行 token-level 激活提取(见 A.1 Layer Selection),只考察了特定深度的静态表示,未覆盖跨层动态演化或 subword/token 边界上的 PoS 激活差异。此外,仅使用 Universal Dependencies 的 PoS 标签,未区分更细粒度形态句法特征(如时态、数、格);Open/Closed class 差异虽被报告,但其背后的功能分化机制未深入解释,留下进一步工作空间。