学习发现有趣的数学
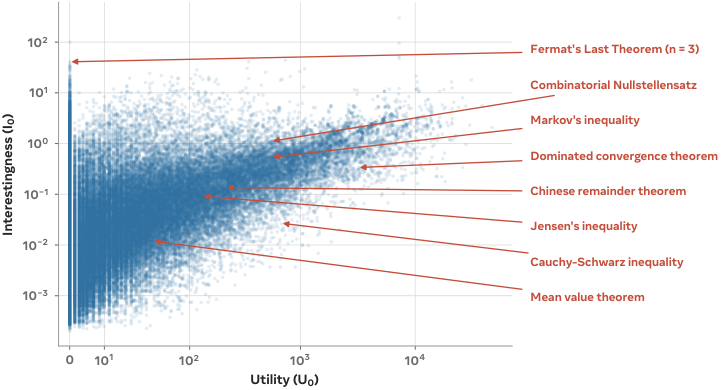
近年来,LLM 在求解高阶数学问题上进步显著,其中不少问题已悬置数十年,这为数学知识以空前规模扩展打开了大门。然而,LLM 虽能猜想并证明越来越多的定理,这些新知识是否有趣或有价值 仍属未知。 我们定义定理的内在趣味性 为其证明长度与陈述长度之比,并表明它与定理下游效用的外在度量 高度相关。我们将给定前提集下证明的难度 作为计算这些指标的有用原语,训练了一个 27B 模型,其预测证明难度的准确度高于前沿通用模型。 以该指标为优化目标,模型能生成更有趣的定理,同时与 Mathlib 的重叠率从 91.9% 降至 30.6%,展现出更多分布外 数学的产生。系统可生成候选定理、从中选出最有趣者,并在自扩展数学库 上迭代构建。 这些指标为在形式化数学库中排序猜想、引导证明搜索提供了可量化的实用信号,也为实现无需人工指定目标、即可自主挑选有价值命题的自扩展、机器验证 数学库提供了路径。
论文精读
TL;DR 用证明长度与陈述长度之比定义定理的内在有趣性,训练 27B 模型预测证明难度,优化该指标可生成更有趣且与 Mathlib 重叠更少的定理,推动自扩展数学知识库。
问题
问题背景
近年来,大语言模型 (LLM) 在形式化定理证明与数学问题求解上取得了显著进展,为大规模扩展数学知识库(如 Mathlib)打开了新的可能。
现有方法局限
当前 LLM 虽然能持续生成定理与证明,但缺少判断新知识是否有趣或有用的量化机制:
- 生成结果与现有库高度重叠,产生大量冗余或平凡定理,文中报告此类大幅重叠比例高达 91.9%;
- 无法评估某条定理的下游价值,导致证明搜索在低价值目标上浪费算力;
- 缺乏可计算的有趣性代理指标,人工筛选成本过高。
为什么这个问题难/重要
形式化数学中“有趣”本身主观且难以直接定义,必须设计可计算的代理指标(例如证明长度与陈述长度之比);同时,证明难度依赖于上下文前提,条件证明难度的预测需要大规模数据支撑。业界高度关注 AI 能否自主发现并筛选有价值数学命题,从而构建自我扩展的机器验证数学库,摆脱对人类预设目标的依赖。
行业类比
类似代码生成场景中需要过滤低质量补全以提升推理效率,本工作为数学定理生成引入了一个可优化的奖励信号,让模型学会“挑选值得证明的命题”。
核心洞察
- 定义“内禀趣味性”为定理证明长度与陈述长度之比,并将条件证明难度建模为一个可学习的 27B 预测模型,从而把“数学定理是否有趣”从主观判断转变为可计算、可优化的信号。与依赖人类专家评分或下游任务奖励的既有方法不同,该指标与外部效用强相关,且无需人工标注即可大规模筛选候选定理,为自动化数学发现提供了关键原语。
- 通过强化学习优化趣味性度量,生成定理与现有 Mathlib 库的重叠率从 91.9% 降至 30.6%,显著提升了分布外数学的产出,并支持迭代构建自扩展的机器验证数学库。这区别于多数 LLM 倾向于模仿训练分布中已有定理的模式,证明引入明确的趣味性奖励可以驱动模型探索新颖且经形式化验证的数学方向,不依赖人类提供的目标。
方法
输入
从形式化数学库(如 Mathlib)中提取定理陈述、证明以及可用的前提集合,作为系统的原始数据。
关键模块
- 条件证明难度模型:训练一个 27B 参数的模型
V_theta,输入为定理陈述与前提集,输出为预测的证明难度(以证明长度作为代理指标)。训练数据通过对前提组合进行采样并记录对应证明长度生成;该模型在评估新定理难度时比通用前沿模型更准确。 - 内在有趣性度量:定义有趣性为证明长度与陈述长度之比。该比率反映了定理的信息压缩程度——较短的陈述却需要较长的证明,通常意味着定理包含更多非平凡的推导结构。作者进一步验证该度量与下游效用(如被后续证明引用的频率)显著相关。
- 猜测与推理时优化:训练一个猜测模型(conjecturing model),基于现有库生成候选定理;在推理阶段,根据有趣性分数对候选定理排序、剪枝,选择高分且与 Mathlib 重叠低的定理。
输出
系统输出一个自扩展的、机器验证的数学库。与同类自动定理证明方法相比,本工作不依赖人类指定的目标定理或外部效用标签,而是用可量化的内在有趣性作为驱动信号,使模型能够自主决定哪些定理值得证明并纳入库中。
实验
实验设计
论文构建条件证明难度 预测任务:给定形式化前提集,预测证明长度与难度,并据此定义内在有趣度 = 证明长度 / 陈述长度。训练一个 27B 参数模型作为难度评估器,用于后续定理生成的评分与筛选。在推理阶段,对候选定理按有趣度排序、剪枝,并迭代扩充形式化数学库。
关键结果
- 27B 难度模型在预测准确率上超过前沿通用 LLM;
- 有趣度指标与下游效用(extrinsic utility)呈强相关;
- 优化有趣度后,生成定理与 Mathlib 的实质/完全重叠率从 91.9% 降至 30.6%,表明模型开始产生更多分布外数学内容。
与基线的对比解读
基线是前沿通用模型直接生成定理,其输出大量复现 Mathlib 已有结果(91.9% 重叠)。引入有趣度驱动的剪枝与选择后,重叠率降至 30.6%,说明指标不仅在统计上有效,也能实际引导搜索远离人类已有定理,转向更“有趣”且尚未被覆盖的方向。该对比验证了用证明长度/陈述长度比 作为内在奖励信号,在自扩展数学库场景中具备可操作的工程价值。
行业影响
潜在落地场景
- 自动化数学研究助手:用于理论物理、密码学、机器学习理论等领域的新定理发现,辅助筛选有潜力的猜想。
- 形式化验证工具链:在芯片设计、智能合约审计、航空航天软件等需要高可信形式化证明的场景中,自动生成并验证引理,减少人工证明负担。
- 教育科技:动态生成难度递进且有趣的数学题目或证明练习,提升个性化学习体验。
商业价值
- 降本 :减少数学研发中的人工试错时间,降低形式化验证外包成本。
- 增效 :加速依赖数学突破的产品研发周期(如新材料模拟、量化金融模型)。
- 新服务 :提供“定理发现即服务”,面向科研机构或高科技企业。
与现有工作流集成
- 可作为插件集成到 Lean/Mathlib 等交互式定理证明器的 IDE 中,提供智能 conjecture 建议和难度预测。
- 与 LLM 推理框架(如
vLLM、SGLang)结合,以 API 形式提供 proof difficulty 评分,用于强化学习奖励信号。
具体 use case
- 金融风控 :自动发现新的随机过程性质或不等式,用于衍生品定价模型校准,减少人工推导错误。
- 制药/材料研发 :辅助推导量子化学或反应动力学中的数学约束,加速模拟验证。
局限
- - **度量简化风险**:论文定义内在有趣性为证明长度与陈述长度之比,该度量虽简单可操作,但可能遗漏数学趣味性的其他关键维度,如结构美感、跨领域连接、证明技巧新颖性或后续引理的重要性。作者在讨论中也承认该度量是启发式,无法完全刻画人类数学家的价值判断,因此生成的定理可能在客观上“有趣”但实际意义有限。
- - **依赖形式化与计算成本**:整个框架构建在 Lean 4 与 Mathlib 等交互式定理证明环境之上,生成的定理需能形式化验证,这限制了探索的数学领域和问题类型,且训练 27B 难度预测模型、推理时搜索和迭代构建库均需要大量计算资源,实际部署门槛较高,不易被小团队复现或扩展到非形式化数学。
- - **与人类专家评估脱节**:文中将内在趣味性与下游效用关联(如引用次数或定理使用频率),但并未邀请大量领域专家对生成定理的“有趣性”进行系统评估。与已有的自动定理证明或猜想生成工作相比,本文更强调自动生成新颖定理,但缺少对生成定理长期数学价值的验证,可能存在模型自我偏好循环的风险。