过去框定未来:Autoregressive 视频生成中的记忆机制
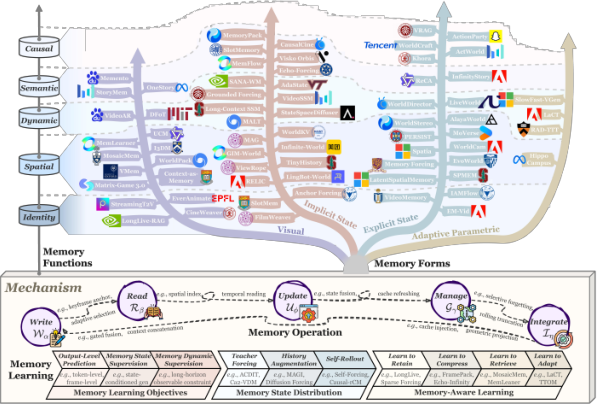
生成模型的进步提升了视频保真度,使长时程生成、交互式世界建模与持续演化的视觉环境成为可能。Autoregressive (AR) 视频生成通过因果式 rollout 延展视觉序列。然而,一个根本性瓶颈随之浮现:随着生成序列不断扩张,实际模型必须在严格受限的 context window、存储与算力预算下运行。因此,关键的历史信息——例如实体身份、动态状态与干预引发的因果变化——往往在其相关性尚未消退之前就已离开活跃上下文。 本文对 AR 视频生成中的记忆机制进行了系统而全面的综述。我们将记忆操作化地定义为:跨外层 AR step 持久保留的历史信息,即使其原始证据已不再可局部访问,仍能影响后续生成。基于这一统一框架,我们从五个互补视角组织相关文献: 1. Forms —— 历史的表征载体; 2. Functions —— 需要保留的具体语义与物理信息; 3. Operations —— 写入、读取、更新、管理与整合记忆的生命周期; 4. Learning —— 闭环 rollout 下记忆行为的优化; 5. Evaluation —— 诊断真实记忆能力的评估范式。 最后,我们综合梳理了开放挑战,包括可组合且资源感知的记忆架构、可信的状态更新、self-rollout 学习以及标准化评测。通过贯通表征、机制与学习范式,本文为构建可靠、以记忆为条件的视频生成系统奠定了结构化基础。
论文精读
TL;DR 本综述系统梳理了自回归视频生成中的记忆机制:将历史信息定义为跨生成步骤持久化、可在证据移出上下文后继续影响未来的状态,并从表征、功能、操作、学习与评测五个维度建立统一框架,为长时程一致性与交互式世界建模提供结构化基础。
问题
问题背景:AR 视频生成正迈向长时程、交互式世界建模与开放式视觉环境,但生成序列扩展时,模型不得不在严格有界的上下文窗口、存储和计算预算下运行。
现有方法局限:多数方法依赖有限滑动窗口或简单缓存,未将历史信息提升为显式可更新的记忆状态。固定窗口丢弃早期帧导致实体遗忘、外观漂移、空间不一致、动态退化;简单缓存缺乏因果状态更新,干预引起的环境变化无法传播到后续生成。此外,记忆读写策略多为启发式,缺少在闭环 rollout 下的端到端学习,难以适应长程分布漂移。
技术挑战与重要性:记忆机制必须同时解决表征压缩、检索效率、状态更新与实际因果一致性;训练记忆行为需要闭环自 rollout,但会引入梯度不稳定和计算开销;评估也缺少标准基准,难以区分真正记忆能力与偶然预测。业界对视频世界模型、具身智能和数字孪生的需求迫切,该问题成为 AR 视频规模化落地的核心瓶颈。
行业类比:类似 LLM 中突破上下文窗口的检索增强与记忆机制,AR 视频生成需要可组合、资源感知的持久记忆层。
核心洞察
- 将记忆定义为跨外部 AR 步骤的持久历史状态,而非局限于当前上下文窗口内的信息。这一观点将记忆从静态的上下文扩展问题重新定义为动态的状态生命周期管理,与以往仅通过长上下文或稀疏注意力来缓解遗忘的工作形成本质区别。对工程实践的启示是:需要设计显式的记忆写入、读取和更新模块,才能支持真正的时间一致性。
- 从“学习”维度审视记忆,强调在闭环 rollout 下优化记忆行为,这不同于传统基于固定数据集的有监督训练。现有工作多在离线生成中评估,而闭环自 rollout 训练才能让模型学会在持续生成中维护状态,适应动作干预等场景。这一视角揭示了当前模型在交互式世界建模中的薄弱环节,并为后续训练范式提供了方向。
- 提出评估记忆能力需要专门的诊断范式,而非常规的视频质量指标。现有指标如 FVD 或 CLIP 分数无法区分模型是否真正记住了实体身份、动态状态或因果变化,容易掩盖记忆缺陷。因此需要设计针对性的探针任务,例如物体再识别、状态一致性检验等。这为社区提供了构建可靠评测基准的方法论。
方法
方法框架
本综述不提出新模型,而是构建一个面向 自回归视频生成 的记忆机制分析框架。
输入:以自回归视频生成相关论文、代码库及评测基准为对象,覆盖离散 token 自回归与连续帧/块生成两类范式。
关键模块:
- 记忆的操作化定义:将记忆定义为“跨外层自回归步骤保持的历史信息,即使原始证据已不在局部上下文,仍能影响未来生成”。
- 五视角分类体系:从 Forms(载体:像素/VAE/特征/参数等)、Functions(需保留的语义与物理信息)、Operations(写入/读取/更新/管理/集成)、Learning(闭环 rollout 下优化记忆行为)、Evaluation(诊断真实记忆能力的范式)五个互补维度组织文献。
- 失效模式梳理:归纳实体遗忘、外观漂移、空间不一致、动态退化、语义漂移、因果/状态不一致等 memoryless rollout 典型失败。
- 开放挑战与资源:提出可组合与资源感知的记忆架构、可信状态更新、自 rollout 学习、标准化评测等方向,并维护 GitHub awesome list。
输出:形成统一记忆生命周期框架与结构化文献地图,为设计 memory-conditioned 视频生成系统提供基础。
与同类方法的差异:区别于仅列举记忆模块的综述,本文以操作性定义和完整生命周期为锚点,建立可指导系统设计的分类与评估范式。
实验
实验设计(综述方法)
本文为系统性综述,未报告独立定量实验。其“实验设计”体现为构建统一的记忆操作性定义:记忆 是跨外层 AR 步骤维护的持久历史信息,能够在原始证据离开局部上下文后继续影响未来生成。梳理范围覆盖五类视角:Forms、Functions、Operations、Learning、Evaluation,并基于此对现有文献归类。
关键发现
- 现有方法在记忆载体上呈现分化:像素空间帧/片段、VAE 空间潜变量、压缩 token 状态等。
- 记忆生命周期包含写入、读取、更新、管理、融合等操作,多数工作缺少统一抽象。
- 记忆失效模式可归纳为六类:实体遗忘、外观漂移、空间不一致、动态退化、语义漂移、因果/状态不一致。
- 开放挑战集中在:可组合与资源感知记忆架构、可信状态更新、自回归 rollout 下的学习、标准化评估基准。
与基线对比的解读
由于是 survey,无单一基线可比较。但综述揭示不同记忆机制在存储开销、读写延迟、长期一致性之间存在权衡:例如像素级记忆保留细节但开销大,VAE 空间记忆更高效但可能丢失高频纹理;显式状态更新方法因果性强但训练复杂。未来工作应关注统一实验协议,否则难以横向对比。
行业影响
落地场景
记忆机制 直接作用于需要长时一致性或交互反馈的 AR 视频生成产品。典型场景包括:
- 电商虚拟试穿与商品展示:用户连续试穿多件服装或切换视角时,系统需要记住用户的身体特征、当前穿戴状态和之前的选择。记忆模块使 AR 模型在后续帧中保持人物外观和衣物细节不变,避免“换一件衣服就变了脸”。
- 内容平台长篇动画/短剧生成:自动生成多集剧情时,角色身份、场景布局和道具状态必须跨集保持。记忆机制让模型在上下文窗口有限的情况下仍能调用早前的视觉证据,生成连贯叙事。
- 交互式虚拟世界/游戏原型:用户操作引起环境变化(如移动物体、破坏结构)后,系统需持久记录这些干预结果。记忆状态可驱动后续生成,实现真正的因果一致。
商业价值
- 降本:减少长视频生成中的人工修正与重生成次数。传统 AR 模型在长序列中频繁出现遗忘或漂移,需要人工干预。可靠的记忆模块可将一次生成成功率显著提升,直接节省 GPU 与人力成本。
- 体验提升:保持角色与场景的连续性,用户不会感知到“跳变”,提升内容消费与交互体验。
- 增收:解锁新的付费场景,如按需生成个性化长篇内容、实时互动虚拟试衣间、可回退/分支的剧情生成。记忆能力让产品从“短片段玩具”升级为可商用的长时生成服务。
跟现有产品/工作流的接口
记忆机制可作为独立模块嵌入现有 AR 视频生成管线:
- 模型侧:以 memory bank 或 memory encoder 形式插入 transformer 层间,接收历史帧/特征并输出条件向量。现有模型如 VideoPoet、Sora-like AR 架构可通过修改 cross-attention 层接入。
- 数据侧:与向量数据库(如 FAISS、Milvus)集成,存储压缩后的视觉 token 或隐状态,供 AR 步长按需检索。
- 工程侧:提供 write/read/update API,让外部系统(如用户交互前端)能显式触发记忆更新。例如在试穿场景中,用户点击“换色”时写入一条状态记录,后续生成自动读取。
综述原文指出:“memory as persistent historical information maintained across outer AR steps”,这为工程实现提供了清晰边界——只需关注跨步长持久化,无需侵入单步推理。
具体落地 use case:
- 电商直播数字人:虚拟主播连续数小时讲解商品,记忆机制确保主播面部、服装、背景不随时间失真,且能根据用户提问实时调用早前展示过的商品信息。
- 教育交互模拟:医学或工程培训中,学员在虚拟环境中操作设备,记忆状态保存每一步动作后果,支持回溯与分步讲解。
集成路径可先从轻量级 visual memory bank 起步,逐步升级到可学习的 memory encoder,与现有云推理服务(如 NVIDIA TensorRT、vLLM)通过 gRPC 对接。
局限
- **综述性质限制**:本文为综述,未提出新的记忆机制或模型,核心贡献在于对现有工作的系统化梳理与统一框架(Forms, Functions, Operations, Learning, Evaluation)。虽然该框架有助于厘清概念,但并未通过实验验证其有效性,也缺乏可操作的实现指导或基准测试。对于期望直接提升模型记忆能力的工程师,本文更像一份导航地图,而非可供落地的算法方案;其 memory formulation 较为抽象,未映射到具体模型架构或训练流程,实际借鉴价值受限。
- **覆盖及时性与完备性存疑**:AR 视频生成领域迭代极快,本文投稿于 2026 年,但所引工作截止时间可能较早,对最新的大规模模型(如 Sora 类及工业界闭源技术)的覆盖难以保证。此外,综述聚焦视觉模态的记忆,对音频、文本等多模态 AR 生成中的记忆问题着墨较少,削弱了框架的普适性;同时,由于缺乏统一的术语体系,部分工作的归类可能存在主观偏差,影响读者对领域全貌的准确把握。
- **评估体系尚不成熟**:文中提出的 Evaluation 视角极具价值,但当前领域确实缺乏标准化的记忆评测基准,各工作使用的指标(如身份保持、状态一致性、因果一致性)差异巨大,难以横向比较。本文虽然指出了方向,但未能给出具体的评测协议、数据集建议或统一的度量标准,使得“记忆能力”的量化仍停留在定性层面,后续研究若据此推进,仍面临较高的实验设计成本与可比性障碍。