StudentBench:AI 与人类辅导在 GRE 学习增益上等效
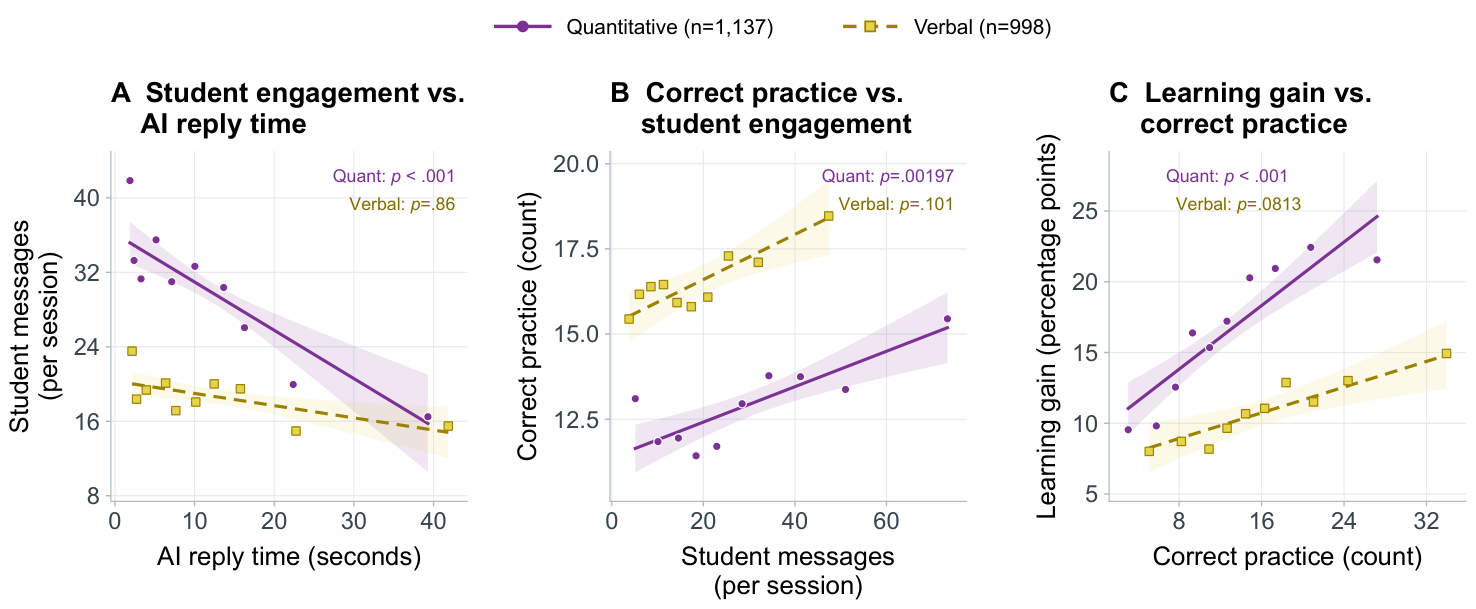
人工智能为增强人类能力提供了前所未有的机遇,但前沿进展主要聚焦于提升模型能力。我们提出 StudentBench —— 一套 AI 教学评测与公开平台,支持大规模数据采集,已积累超过 175,000 条学生-AI 消息,用于研究大语言模型(LLMs)能否产生与人类辅导等效的学习增益。 借助 StudentBench,我们在 Quantitative 与 Verbal GRE 题目上测量了 2,383 名参与者的学习增益,参与者分别接受 AI 辅导、人类辅导或无辅导。结果显示,AI 辅导与专家人类辅导在 GRE 学习增益上统计等效(p = .015),且在七个 GRE 领域中的五个,表现最佳的 AI 导师平均超过人类导师。第二项研究中,专家人类导师通过 2,028 次成对评分量表评估,对比了 LLM 生成的教案与练习题。 两项研究清晰区分了 AI 导师在五个维度的表现:1. 教案设计;2. 练习题生成;3. 对话教学法;4. 成本;5. 参与度。令人意外的是,一个 AI 导师以低 918 倍的成本(每提升一个百分点:AI 为 0.0052 美元,人类为 4.81 美元)取得了与人类辅导等效的学习增益(p = .044)。在 Quantitative GRE 会话中,AI 回复越快,学生消息越多;消息越多,正确练习越多;正确练习越多,学习增益越大(均 p < .002)。StudentBench 平台已在 https://studentbench.org 免费开放。
论文精读
TL;DR StudentBench 平台通过 2,383 名参与者的大规模实验证明,AI 辅导在 GRE 学习增益上与专家人类辅导统计等效,且成本低 918 倍。
问题
问题背景
智能辅导系统 (Intelligent Tutoring Systems, ITS) 长期追求接近人类教师的个性化教学效果。随着 LLM 在自然语言生成与推理上的突破,AI 辅导被寄望以极低成本复制或超越专家教学,但缺少严格的实证评估。
现有方法局限
- 多数 AI 教学基准只评估模型在问答、生成教案或单轮对话上的表面质量,而非真实 学习收益 (learning gains)。
- 缺少大规模随机对照试验 (RCT),样本量小、无人类辅导基线、无控制组,难以建立统计等效性。
- 数据质量与评估完整性不足:学习者可能抄答案、不认真参与,前测/后测设计薄弱。
- 缺乏统一平台来标准化数据收集与多维度比较,导致不同研究间结果不可比。
为什么这个问题难/重要
- 学习收益需长期追踪和严格因果推断,成本高、周期长;教育场景噪声大,个体差异显著。
- 教学效果不仅取决于内容正确性,还涉及对话互动、反馈时机、练习生成、成本与延迟等多因素耦合。
- 业界关注 AI 能否规模化降低优质教育成本,但若不能证明与人类辅导等效,部署风险很高。
行业类比
类似 AI 辅助诊断系统需通过随机对照试验证明与医生诊断的准确性非劣效,才能获得临床采纳;AI 教学同样需要用等效性证据跨越从“能聊天”到“能教学”的信任鸿沟。
核心洞察
- StudentBench 将 AI 评测从模型能力基准转向学习效果基准,通过随机对照试验和统计等效性检验,直接验证 LLM 能否带来与人类专家辅导相当的学习收益。与现有 LLM 基准(如 MMLU、GSM8K)侧重单次任务准确率不同,StudentBench 关注教育干预后的实际学习增量,并采用 **equivalence testing**(p=.015)证明 AI 辅导与人类辅导等效,而非仅报告优越性。该平台收集 17.5 万条学生-AI 交互消息,为 AI 教育研究提供了可复现的大规模实验基础设施,推动从“模型能答对”到“模型能教会”的范式转变。
- 论文引入“每百分点学习收益成本”作为 AI 教育部署的核心效率指标,发现某 AI 导师以 p=.044 等效于人类辅导,而成本仅为人类的 1/918($0.0052 vs $4.81)。传统教育技术评估常忽略经济可行性,而本研究将统计等效性、学习收益与真实 API 成本结合,直接量化 AI 辅导的性价比。这一指标为算法工程师和产品经理提供了规划依据:即使 AI 回复质量略逊,若延迟优化和成本极低,仍可在大规模场景中替代部分人工辅导。该度量也揭示了 AI 教育商业化中成本与效果之间的权衡空间。
- 研究建立了一条可量化的因果链:更快的 AI 回复延迟 → 更多学生消息 → 更多正确练习 → 更大学习收益(Quantitative GRE 中所有关联 p<.002)。该发现将系统性能(延迟)与教育结果直接挂钩,超越单纯模型精度,强调交互体验在 AI 教学中的关键作用。与很多研究只优化模型生成质量不同,StudentBench 提示工程师应将响应延迟作为一等公民,因为更低的延迟可能通过提升学生对话意愿和练习量间接放大学习效果,这对实时教育产品的架构设计有直接指导意义。
方法
StudentBench 采用双研究设计,输入为 GRE Quantitative 与 Verbal 题库、2,383 名人类参与者及多个主流 LLM 作为 AI tutor。参与者随机分为 AI tutoring、expert human tutoring、no tutoring 三组。
关键模块
- 交互式 AI 导师:通过 lesson-planning prompt 与 interactive-tutoring prompt 生成 lesson plans 和 practice problems,并在对话中教学。
- 数据采集管道:记录超过 175,000 条 student-AI messages,包含消息数、正确练习数、AI 回复延迟等指标。
- 学习收益评估:使用 GRE 题目前后测,计算 score gains。
- 专家评审模块:第二个研究中,专家人类导师对 LLM 生成的 lesson plans 和 practice problems 进行 2,028 次 pairwise rubric 对比。
输出
输出七领域学习收益对比、等价性检验(p 值)、成本效益指标(每百分比点成本)以及五个维度的 AI tutor 排行榜。
跟同类方法的差异点:与以往 AI 教学基准侧重模型知识或对话质量不同,StudentBench 直接在真实学习场景中测量增益、成本与参与度,并提供公开平台支持大规模数据收集。
实验
实验设计
利用 StudentBench 平台收集超过 175,000 条学生-AI 消息,招募 2,383 名参与者,随机分配至 AI 辅导、人类辅导或无辅导条件。测量 GRE Quantitative 和 Verbal 题目的学习增益,覆盖 7 个 GRE 领域。第二项研究由专家人类导师对 LLM 生成的教案与练习题进行 2,028 次成对评估。
关键发现
- AI 辅导与专家人类辅导的学习增益统计等价(p = .015)。
- 在 7 个 GRE 领域中,有 5 个领域表现最佳的 AI 导师平均超过人类导师。
- 单个 AI 导师以 p = .044 实现等价,且每百分点增益成本为 $0.0052 vs 人类 $4.81,低 918 倍。
- 更快的 AI 回复与学生更多消息、更多正确练习相关,进而与更大学习增益相关(均 p < .002)。
与基线对比解读
与传统仅比较模型能力的基准不同,StudentBench 直接测量学习结果,关注教学有效性。人类辅导作为强基线,AI 达到统计等价,且成本差异显著,说明可规模化部署的潜力。相关性链(延迟→参与→练习→增益)揭示工程优化方向:降低响应延迟可能提升学习效果。
行业影响
落地场景
StudentBench 可作为 AI 教学能力的标准化评测层,适用于 在线教育平台、企业培训系统、语言学习 App 等产品。典型场景包括:MOOC 平台(如 Coursera)内置 AI 助教 提供课后答疑与练习生成;企业 LMS(如 SAP SuccessFactors)集成 按需技能辅导;语言类 App(如 Duolingo)增加 对话式 AI 陪练。
商业价值
- 降本:单点学习收益成本仅为人类导师的 1/918($0.0052 vs $4.81 per percentage point),可大规模提供个性化辅导。
- 增收:低成本支撑低价订阅或增值服务,触达原本无法负担 1:1 辅导的用户群体。
- 体验提升:即时反馈、24/7 可用、无限生成变式练习,可提升完课率与学习时长。
与现有工作流的接口
通过 StudentBench 平台 及 GitHub 仓库,团队可将现有 LLM 应用接入评测,快速对比 lesson planning、practice-problem creation、conversational pedagogy 等维度。工程集成建议:
- 封装 AI Tutor API 接入聊天界面、LMS 或客服系统;
- 用 StudentBench 的 7 个 GRE 领域 leaderboard 做模型选型与回归测试;
- 参考论文的 pairwise rubric 做人工抽检,处理争议答案。
论文发现更快回复与学生更多练习正相关,工程上可将延迟阈值设为 < 2 秒 以促进互动深度。
具体落地 use case:
- 在线教育平台(如 Udemy/edX)用 AI 导师自动生成 GRE 或职业认证练习与解析,减少教研人力,支持按需刷题。
- 企业员工培训(如客户支持、合规培训)使用 AI 对话导师模拟场景,替代部分外部讲师,可将培训成本降低两个数量级。
局限
- 研究人群与学习材料单一:研究仅使用 GRE 标准化考试题目,且参与者为英语使用者(或未明确地域,但 GRE 本身偏向英语语境),结论可能难以推广到编程、数学证明、创意写作等开放性学习任务。此外,学习增益仅通过短期测试测量,缺乏延迟后测来评估长期保持效果,无法判断 AI 辅导是否产生持久的知识迁移。
- 实验控制与生态效度的张力:为了统计等效性,研究对 AI 和人类辅导的会话时长、互动频率可能做了强制约束,导致两者并非完全自然的辅导场景。人类辅导者数量有限且可能经过挑选培训,与真实世界中参差不齐的辅导质量有差距。成本计算仅基于特定 LLM API 调用价格,未考虑基础设施、人工标注、提示工程等隐性成本,使得 918 倍成本优势在实际部署中可能缩水。
- 数据质量与专家评估主观性:尽管有数据质量筛选,但参与者在线完成 GRE 练习可能存在作弊或低努力作答(如快速随机点击),影响学习增益信度。第二项研究中专家人类辅导对课程计划和练习题的评价采用成对比较,虽然使用共同规则,但专家间一致性未充分报告,可能引入偏见。另外,AI 辅导的生成内容可能随时间变化,而平台固定了特定模型版本和提示,结果无法反映最新模型能力。