FLEET: 从 Logits 熵到文本生成中的增强轨迹
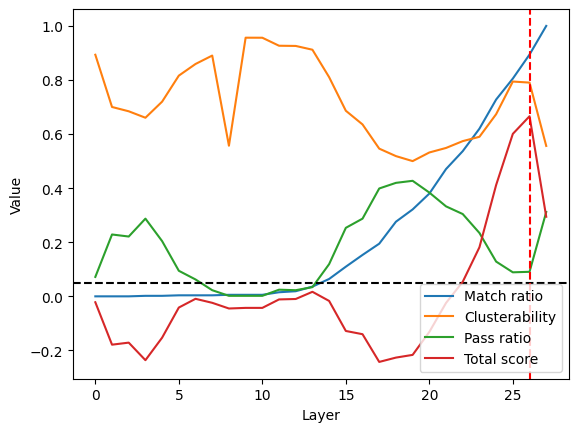
基于 LLM 的解决方案常依赖 temperature sampling(温度采样),通过聚合来自 completion 分布的多个样本提升准确性与稳定性。然而这种无记忆(memoryless)方法本质上并非最优:由于缺乏对先前生成及其评估结果的感知,随着采样数量增加,语义重复的答案占比不断上升,导致收益递减。 为突破这一局限,我们提出 FLEET,一种将记忆机制引入生成过程的新方法。FLEET 把每次生成表示为一个稀疏轨迹,轨迹由熵超过预设阈值的状态构成,并利用这些轨迹推断每个 token 的 utility score,进而对 logits 进行调整。 基准评测表明: - FLEET 在与重复采样基线达到相同准确率的前提下,实现 3x 加速; - 在相同预算下显著提升复杂编码任务表现,LiveCodeBench Pass@32 从 59.9% 提升至 66.2%。 此外,在此处评估的 greedy-decoding 配置下,该方法具有确定性,仅需一次校准过程即可推导其核心超参数,且对现有 LLM 流水线只需极小的改动。
论文精读
TL;DR FLEET 在 LLM 采样中加入熵轨迹记忆,调整 logits 减少重复,同等预算下 Pass@32 提升 6.3% 并加速 3 倍。
问题
问题背景
LLM 推理中,temperature sampling 结合多次采样聚合(如 majority voting、Pass@k)已成为提升准确率的常用手段,尤其在高风险问答与代码生成场景。
现有方法局限
- 传统 temperature sampling 是 memoryless 的:每次采样独立,不参考先前 generation 与 evaluation 的信息。
- 随着采样数增加,semantically duplicate 答案比例上升,导致边际收益递减,计算资源浪费严重。
- 无法识别或规避高熵、易错的 token 状态;对错误路径缺少选择性探索,难以跨任务泛化。
- 不同任务需要重新调温度、采样数等超参,工程成本高。
为什么难/重要
- 引入 memory 机制需在 online decoding 中维护并利用 trajectory 信息,但不能显著增加推理时延或显存。
- 需要将隐状态映射到可解释的搜索状态(如基于 entropy threshold 的稀疏轨迹),并推断 per-token utility scores 调整 logits。
- 业界关注在相同 compute budget 下提升 accuracy,尤其复杂 coding benchmark(如 LiveCodeBench)上 Pass@32 从 59.9% 提升到 66.2%,同时保持 greedy decoding 的确定性。
行业类比
类似于代码助理在生成多个候选补丁时,盲目随机采样会重复产生相似错误,而带记忆机制的搜索能引导模型避开已证明低效的路径,提高每个采样的信息增益。
核心洞察
- FLEET 的核心洞察是将 LLM 生成过程中的高熵 token 状态视为可记忆的决策点,构建稀疏轨迹并学习 per-token 效用分数来调整 logits,从而把无记忆的温度采样转化为有引导的探索。与 self-consistency 等重复采样方法相比,它利用历史生成和评估信息抑制语义重复,在相同预算下突破边际收益递减,提升复杂推理任务的准确率。
- FLEET 在 greedy decoding 配置下实现确定性输出,仅需一次校准即可确定主要超参数,避免了多次随机采样和聚合带来的计算开销与不可复现性。相比传统 temperature sampling + majority voting 的 pipeline,FLEET 在保持同等准确率的同时实现 3 倍加速,并显著提升 LiveCodeBench Pass@32(59.9% → 66.2%),更适合对延迟和稳定性敏感的生产系统。
方法
方法概述
FLEET 在 LLM 自回归生成中引入记忆机制,核心是将每个生成序列表示为若干高熵状态构成的稀疏轨迹,并据此动态调整 logits。
输入:LLM 每步输出的 logits(或对应隐藏状态)。
关键模块:
- 熵阈值检测:计算每个 token 预测分布的熵,超过预设阈值的位置被视为关键状态,形成稀疏轨迹。
- 状态映射与去重:利用 Vector Disjoint Set Union 将不同生成过程中的相似高熵隐藏状态映射到同一搜索状态,避免重复探索。
- 效用分数推断:基于历史轨迹(已生成的样本及其评估结果)为每个 token 推断 per-token utility score,衡量其对最终答案多样性和正确性的贡献。
- logits 调整:将效用分数加到对应 logits 上,改变采样概率,引导模型在后续生成中避开已探索的低效用路径,鼓励高效用探索。
输出:调整后的 token 概率分布,用于采样或贪心解码。
超参数初始化:通过一次校准运行(single calibration pass)确定熵阈值等关键超参数,无需反复调参。
与同类方法(如重复采样、beam search、基于熵的截断)的差异:FLEET 显式维护跨生成记忆,利用历史轨迹的效用反馈进行在线 logits 修正,而非独立采样或静态熵剪枝,从而在相同预算下显著减少语义重复并提升 pass@k。
实验
实验设计
论文对比 FLEET 与 temperature sampling 的 repeated sampling baseline,在 LiveCodeBench 与 GSM8K 上进行评估(GSM8K 从附录提示词推断)。评估指标为 Pass@k 及推理加速比,预算固定。FLEET 在 greedy-decoding 配置下仅需单次校准 pass 初始化超参数,无需大量调参。
关键发现
- 在
LiveCodeBench上,Pass@32从 59.9% 提升至 66.2%(相对提升约 6.3 个百分点)。 - 达到与 baseline 相同准确率时,FLEET 速度快 3 倍。
- 方法确定性,可在现有 LLM 流水线中轻量集成。
与基线对比解读
FLEET 的核心差异在于引入记忆机制,以熵轨迹调整 logits,避免无记忆采样造成的语义重复,缓解边际收益递减。相比之下,repeated sampling 无感知先前生成,导致资源浪费。FLEET 在复杂代码生成中收益更明显,因为其探索空间大,重复采样低效。工程上,FLEET 适合对延迟敏感、需要确定性输出的场景,且改动成本低。
行业影响
落地场景
FLEET 适用于任何依赖 温度采样 + 多次采样聚合 的 LLM 产品,尤其在高难度推理与代码生成场景。例如:
- 代码助手 / Copilot:在 IDE 或 CI 中生成多个候选,用测试用例筛选,FLEET 可将 Pass@32 从 59.9% 提升至 66.2%,同时减少重复答案。
- 金融 / 法律问答:需要多路径推理并验证一致性,FLEET 的记忆机制能避免语义重复,提高最终答案可靠性。
- 教育 / 客服:数学题或技术问题解答,生成多解并投票,降低单次错误导致的级联失败。
商业价值
- 降本:同等精度下 3x 加速,直接削减 GPU 推理成本,尤其对大规模 SaaS 或 API 服务。
- 增收 / 提效:在固定预算内提高复杂任务准确率(LiveCodeBench +6.3%),让产品可支撑更高难度任务,增强付费意愿。
- 体验提升:减少重复答案,用户获得更多样且可靠的候选;确定性 greedy 配置便于结果复现,利于审计与合规。
与现有产品/工作流的接口
FLEET 作为 推理时 logits 后处理 模块,无需重新训练或改变模型架构。只需:
- 在生成循环中按 熵阈值 记录高熵 token 轨迹;
- 用 单次校准 确定超参数;
- 将 per-token utility 分数注入 logits 调整层。
可集成至 vLLM、TensorRT-LLM 或自研 sampling server;对已有 LLM pipeline 改动极小,兼容 ORM 和多数搜索策略。
局限
- 论文采用固定的熵阈值来定义状态,该超参数通过一次性校准确定,这可能限制了方法在不同数据分布或模型规模上的泛化能力。对于熵分布差异较大的任务(如低熵的闭卷问答或高熵的开放式生成),单一的阈值可能不再适用,需要重新校准,增加了实际部署成本。此外,校准过程本身需要额外的推理计算,虽然论文强调只需一次,但在动态变化的在线场景中可能成为负担。
- FLEET 的性能增益主要在具有可验证正确性的任务上得到验证(如 LiveCodeBench、GSM8K),这些任务通常有明确的 ground-truth 或 outcome reward model。对于开放式文本生成、创意写作等缺乏客观评价标准的场景,熵轨迹所隐含的“效用”可能无法准确反映生成质量,导致方法失效或性能不稳定。论文未提供在非验证型任务上的实验证据,限制了其适用范围的判断。
- 与基于强化学习或奖励模型引导的探索方法(如 best-of-n 结合 learned verifier)相比,FLEET 仅使用熵作为探索信号,可能忽略了语义层面的重复与多样性。摘要中提到的记忆机制可以避免完全重复,但对于语义相似但表达不同的答案,是否也能有效区分?论文未与更先进的采样策略(如核采样、典型采样)进行系统性对比,因此其优势边界尚不清晰。