Agent-Editing World Model:重新思考 LLM Agent 的世界建模
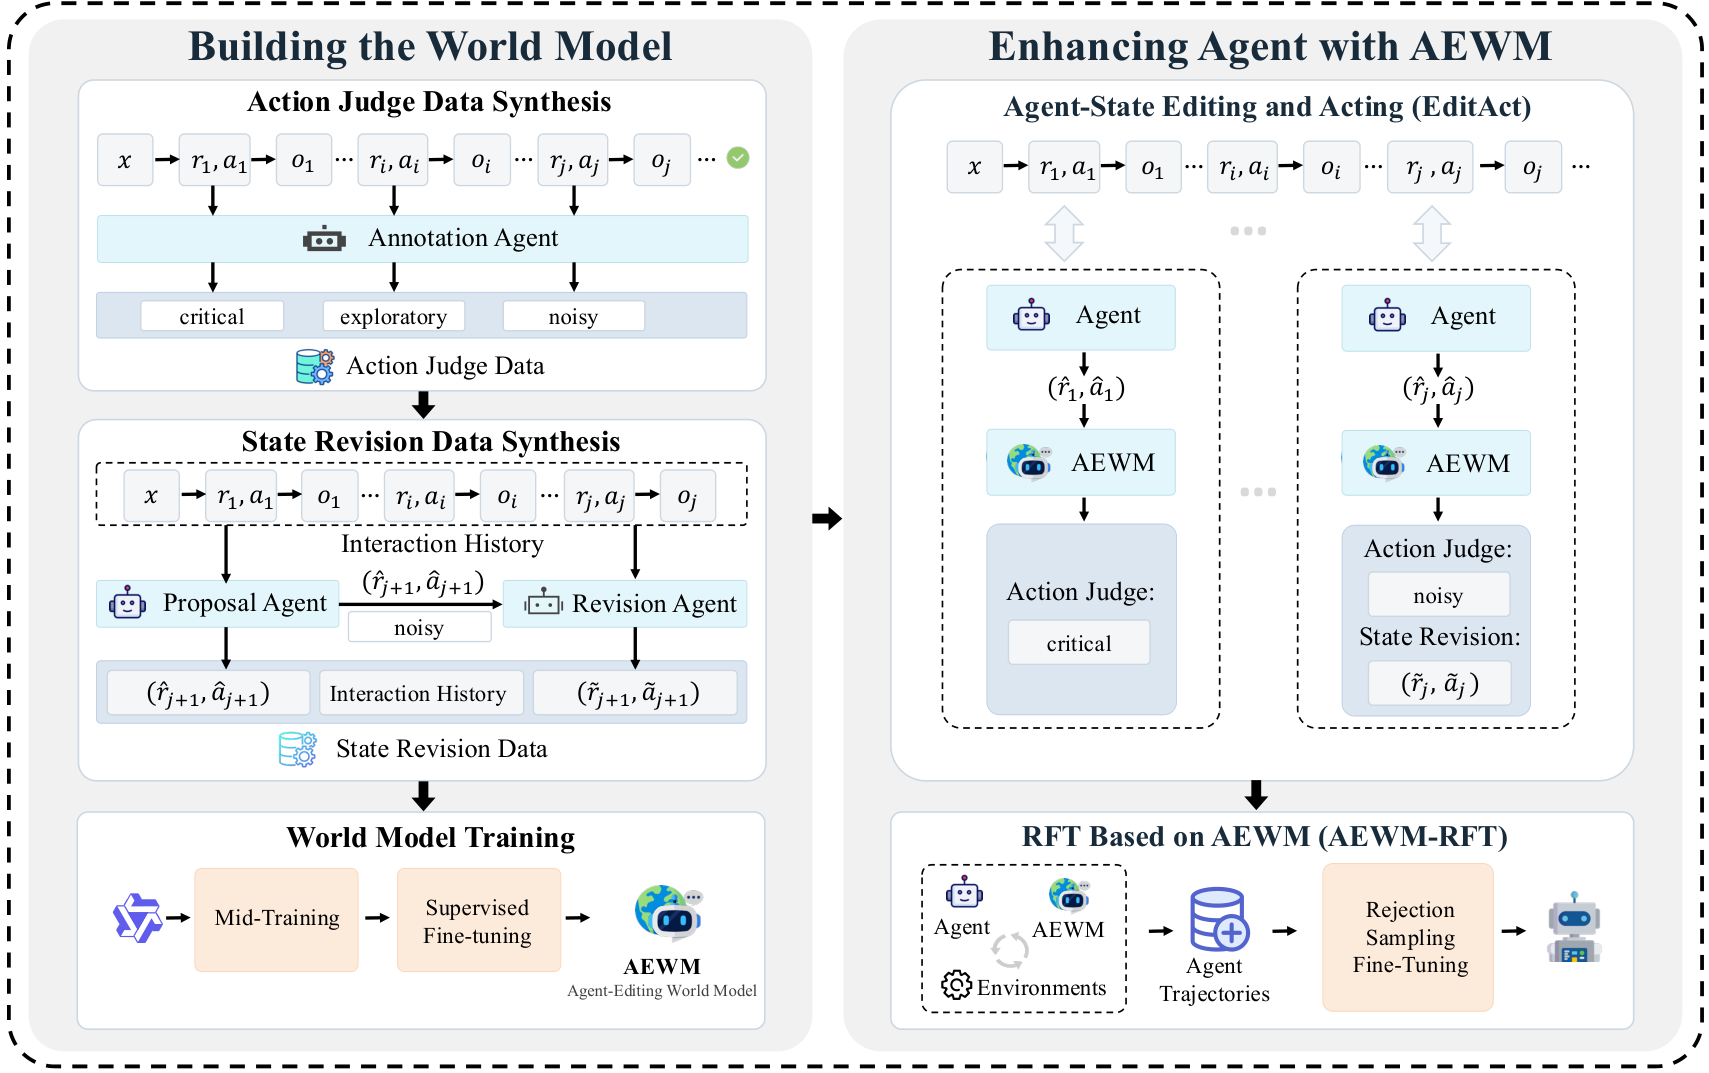
近期,大型语言模型(LLM)的能力进步使 agent 能够在多样环境中处理长时程任务。为提升 agent 表现,现有 language world model 通常预测环境观测,但在真实反馈可用时,重建高熵且依赖执行过程的工具响应价值有限。与此同时,agent 还面临 task-state contamination 问题:缺乏依据的假设与过时计划会滞留于历史中,歪曲后续决策。 为此我们提出 Agent-Editing World Model(AEWM),它建模推理与动作如何塑造未来任务进展,而非模拟工具响应。AEWM 结合两个组件:Action Judge 用于区分 Critical、Exploratory 与 Noisy 决策,State Revision 则在相同的观测历史下编辑含噪的推理—动作续写。EditAct 将上述能力与真实执行整合,直接改变后续决策所依赖的状态,而不仅是给出批评意见。 我们在 Search、Terminal 与 Software Engineering 场景中,通过 mid-training 与 supervised fine-tuning 训练 AEWM。在自建的 Action Judge benchmark 上,AEWM 取得 70.5% 的 macro-F1,超出最强 frontier baseline 10.6 分。在六个 benchmark 与三个 agent backbone 上,EditAct 相较最强基线平均提升 3.2–6.7 分。此外,对经过验证的 EditAct 轨迹做 rejection sampling fine-tuning(即 AEWM-RFT),在三个领域内比 Self-RFT 提升 2.2–2.6 分,且无需在线 AEWM 指导。
论文精读
TL;DR 提出 Agent-Editing World Model (AEWM),通过编辑任务状态而非预测环境观察,修复 agent 历史中的错误假设和过时计划,在多个基准上将平均分提升 3.2-6.7 点,超过最强基线。
问题
问题背景
长期任务的 LLM agents 是当前热点,研究者尝试用 world model 提升 agent 的规划与决策质量。
现有方法局限
现有 language world models 主要预测环境观察(如 tool response),但这些响应具有高熵、执行依赖的特点,在真实反馈可获取时重建价值有限。更关键的是,agent 历史中未经验证的假设和过时计划会持续累积,形成任务状态污染(task-state contamination),扭曲后续决策。传统方法缺乏显式的状态编辑机制,无法从历史中剔除或修正这些污染节点。
为什么这个问题难/重要
长程任务中错误会沿决策链传播,定位并消除状态污染需要区分关键决策与噪声,并对推理-行动序列进行精准修订。训练此类 world model 需要构造决策质量标注与状态修正数据,数据工程复杂。业界对 Search、Terminal、SWE 等真实环境下 agent 的可靠性要求越来越高,而状态建模的缺失直接制约成功率。
行业类比
如同多轮对话系统中,不预测用户下一条回复的原话,而是更新并修正对话状态(意图、槽位)以指导策略,AEWM 让 agent 直接编辑任务状态而非重建环境观察。
核心洞察
- 世界模型应建模任务状态演变而非环境观测。传统 language world model 试图预测工具响应,但工具响应高熵且执行依赖,真实反馈可得时预测价值有限。AEWM 转而建模推理-动作如何改变任务进度,这更贴近 LLM agent 的实际运行机制,降低了建模复杂度,同时聚焦于影响决策的关键状态变量。与现有 world model 或环境模拟器形成根本差异,为世界模型在 agent 场景的应用提供了新范式。
- 任务状态污染是长程 agent 失败的关键因素,主动编辑历史比事后反思更有效。已有方法如 Reflexion 或 self-critique 通常生成反馈但不修改历史状态,污染会持续影响后续决策。AEWM 的 State Revision 直接编辑有噪声的推理-动作片段,从源头消除错误假设和过时计划。EditAct 将编辑与真实执行结合,使状态修正与工具调用同步,让 agent 在决策时基于纠正后的状态,而不是事后修正。
- 通过 rejection sampling 微调可以将编辑能力内部化到 agent,实现推理时无需额外世界模型。AEWM-RFT 在验证过的 EditAct 轨迹上微调,超过 Self-RFT 2.2-2.6 点,且无需在线 AEWM 指导。这为实际部署提供了轻量级方案:训练阶段学习编辑策略,推理时直接用 LLM 自身判断和修正,避免了每一轮额外调用大模型世界模型的开销,同时保留了编辑能力。
方法
AEWM 的输入是 agent 在任务执行中产生的完整轨迹,包括 推理、动作 和 观察。核心出发点在于:现有语言世界模型尝试预测工具响应等高熵且依赖实际执行的观测,价值有限;同时历史中累积的错误假设和过时计划形成任务状态污染,持续扭曲后续决策。
AEWM 包含两个关键模块:Action Judge 和 State Revision。Action Judge 将每个决策分类为三种类型:Critical(关键且正确)、Exploratory(探索性/价值待定)和 Noisy(噪声/错误),用于识别需要编辑的环节。State Revision 则基于同一段观察历史,编辑其中 noisy 的“推理-动作”延续,生成修正后的状态表示。
EditAct 将上述能力与实际执行闭环:在线推理时,先由 Action Judge 判断当前决策质量,若判定为 noisy,则触发 State Revision 对内部状态进行编辑,再基于修正后的状态继续动作选择,而非仅仅生成外部批评文本或重新模拟环境。训练上,AEWM 在 Search、Terminal、SWE 三个领域通过 mid-training 和 SFT 分两阶段完成;进一步利用 rejection sampling fine-tuning 在已验证的 EditAct 轨迹上蒸馏,得到 AEWM-RFT,脱离在线 AEWM 指导也能保持增益。
与单纯提供批评或重新采样动作的方法相比,AEWM 直接编辑 agent 决策所依赖的任务状态,将“世界模型”从预测观察转向塑造任务进展本身。
实验
实验设计
AEWM 实验覆盖 Search、Terminal、Software Engineering 三个领域,使用六个 benchmark: BrowseComp、DeepSearchQA、Terminal-Bench 2.0、SWE-Bench Pro、Doc2Repo、NL2Repo。训练分 mid-training 与 SFT 两阶段,Action Judge 用 turn-level 标注构建 benchmark,State Revision 依赖合成数据。评估在三个 agent 骨干模型上进行,覆盖推理与执行。
关键发现
- Action Judge 达到 70.5% macro-F1,比最强 frontier baseline 高 10.6 个点。
- EditAct 在六个 benchmark、三个 agent backbones 上平均提升 3.2–6.7 分,超过最强 baseline。
- AEWM-RFT 利用 rejection sampling 对 verified EditAct trajectories 微调,在三个领域比 Self-RFT 稳定提升 2.2–2.6 分,且无需在线 AEWM 引导。
对比解读
传统 world model 预测环境观察,但高熵工具响应重建价值有限;AEWM 直接编辑任务状态,避免信息冗余。Action Judge 区分 Critical、Exploratory、Noisy 决策,使 State Revision 能精准修复污染历史。AEWM-RFT 将编辑能力通过验证轨迹内化,离线部署更轻量,较 Self-RFT 提升说明编辑信号比自我反思更有效。
行业影响
落地场景
AEWM 的核心能力State Revision 与 EditAct 可嵌入长程 LLM agent 框架(如 ReAct、SWE-agent、AutoGPT)中,在每一步执行后动态编辑 agent 的内部状态,避免 task-state contamination(错误假设、过时计划污染后续决策)。适用于需要高可靠性的自动化场景:软件工程 agent 修复复杂 issue、终端操作 agent 执行多步命令、深度搜索 agent 进行多轮信息检索。
商业价值
通过 Action Judge 区分关键 / 探索 / 噪声决策,减少无效探索和错误积累,直接降低长程任务失败率与 token 重试成本。实验显示 EditAct 在六项 benchmark 上平均提升 3.2--6.7 分,AEWM-RFT 比 Self-RFT 提升 2.2--2.6 分且无需在线世界模型引导,推理阶段零额外开销,适合对延迟和成本敏感的生产环境。
与现有产品 / 工作流的接口
AEWM 可作为插件式模块集成进现有 agent loop:在 agent.step() 后调用 edit_state() 清理历史,或在 LLM 推理前对上下文进行状态压缩。离线阶段通过 SFT 或 rejection sampling fine-tuning 将编辑能力内化到 backbone(如 Llama、Qwen 系列),无需改变现有工具调用协议。兼容 LangChain、LlamaIndex 等编排框架。
具体 use case
- 企业级代码生成 agent:在长会话修复 SWE-bench 类任务时,利用 State Revision 清除过时的假设(如错误的环境配置),避免后续 patch 偏离正确方向,提高补丁一次通过率。
- 电商智能客服 agent:处理多轮退换货咨询时,通过 Action Judge 识别噪声步骤并编辑错误推理,防止用户意图被误解后持续误导后续回复,降低人工介入率。
局限
- **依赖领域特定合成数据与在线执行耦合**。AEWM 的训练数据依赖于对 Search、Terminal、SWE 三个领域的轨迹进行 Action Judge 标注与 State Revision 合成,其分类标准(Critical / Exploratory / Noisy)可能高度适配这些基于工具交互的文本环境。当扩展到多模态、开放域对话或物理世界 agent 任务时,需要重新设计标注流程和调整模型,泛化性未经验证。同时,EditAct 必须在真实执行后编辑历史,无法在动作执行前预防错误,且对于不可逆操作(如删除文件、提交代码)的编辑风险较高,实际部署中需要额外的安全检查机制。
- **三分类粒度可能不足以刻画任务状态污染**。Action Judge 将每个决策划分为 Critical、Exploratory、Noisy 三类,但这种粗粒度分类可能忽略错误类型的多样性,例如因果推断错误、目标误解或部分噪声动作,导致 State Revision 无法针对性地修正所有类型的污染。此外,AEWM 作为一个预测模型,其编辑建议的准确性受限于自身能力,错误编辑可能引入新的不一致,尤其在历史中多条错误轨迹交织时。论文未提供编辑失败率或编辑一致性分析,这使得实际应用中需要谨慎判断何时信任世界模型的编辑。