QuantWM:面向视频世界模型的时序一致 2-Bit KV Cache 量化
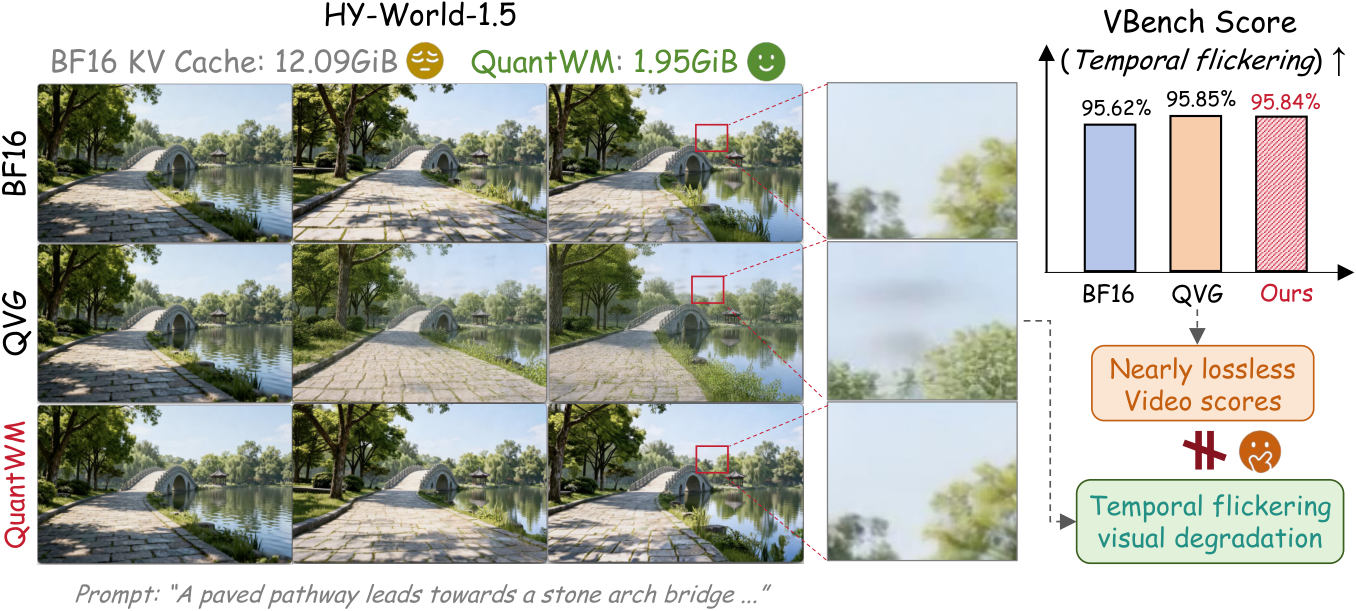
问题与发现: 视频世界模型依靠生成过程中存储的 KV cache 维持长程时序一致性,但不断增长的 cache 使显存成为部署瓶颈,催生了低比特量化研究。现有 2-bit KV cache 量化方法在 VBench 上近乎无损,然而用于视频世界模型时仍会造成严重的时序闪烁与视觉退化。深入分析显示,Key 量化的重构误差小于 Value,却反而带来更大的输出退化;根源在于视频世界模型的 attention 特性:Key 扰动会改变 attention logits,并偏移 Query 选中的时序-空间 token。 方法: 为此,作者提出 QuantWM,一个免训练的 2-bit KV cache 量化框架,包含两项互补技术: 1. QSAC(quantization-sensitivity-aware clustering):联合考虑历史 Query 敏感度与残差范围,挑选对 INT2 友好的 Key 质心,降低对 attention 更关键通道的量化误差; 2. PSAC(principal-subspace attention compensation):借助低秩投影,沿主导 Query 子空间恢复残余 Key 误差,直接且高效地校正并稳定 attention logits。 实验与结论: 在 LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video 与 Causal-Forcing 上的实验表明,QuantWM 显著提升视觉质量与时序一致性,并在各项基准上超越现有方法,实现最高 6.20 的 KV cache 显存压缩,额外开销有限。
论文精读
TL;DR QuantWM 是一种无需训练的 2-bit KV cache 量化框架,通过保持注意力 logits 和 token 选择来消除视频世界模型的时间闪烁,实现高达 6.2 倍压缩且性能优于现有方法。
问题
问题背景
视频世界模型通过缓存 KV cache 实现长距离时序一致生成,但缓存量随生成步数线性增长,成为推理部署的核心内存瓶颈。低比特量化(尤其 2-bit)被视为关键优化方向。
现有方法局限
现有 2-bit KV cache 量化方法在 VBench 等常规视频基准上接近无损,但直接迁移到视频世界模型时会出现明显时序闪烁和视觉退化。作者实验发现:Key 量化的重建误差虽小于 Value,但导致的输出退化却更严重——因为 Key 扰动会改变注意力 logits,进而改变 Query 选中的时空 token 集合。常规量化仅优化逐张量重建误差,未考虑注意力机制对 Key 通道的异质敏感性,以及跨帧时空 token 选择对一致性的影响。
为什么这个问题难/重要
视频世界模型的 KV cache 规模随时间膨胀迅速,2-bit 量化可带来最高 6.20x 内存压缩,但压缩率与视频质量之间存在敏感冲突。挑战在于:Key 量化误差会在注意力计算中被放大,单帧微小 logits 偏移会累积为跨帧 token 选择漂移,破坏物理运动连续性。此外,训练无关(training-free)约束要求不能通过重新训练校准,进一步限制补偿手段。业界关注点在于:如何在保持极低内存占用的同时稳定时序一致性,这直接影响长视频生成、具身智能模拟的部署可行性。
行业类比
这一挑战类似自动驾驶世界模型中的环境状态缓存量化:若历史 token 的注意力选择因低比特近似而漂移,预测出的未来轨迹会随时间发散,难以满足闭环仿真对长期一致性的要求。
核心洞察
- Key 量化引起的注意力 token 选择偏移是视频世界模型严重退化的根本原因,而非 Value 重构误差。这解释了为什么通用视频基准上无损的 KV cache 量化方法在 world model 上会失效。在自回归长时生成的视频世界模型中,Query 根据 Key 动态选择历史时序-空间 token,Key 量化微扰经 attention logits 放大后改变了 token 选择分布,从而破坏帧间一致性。QuantWM 率先从稳定 attention logits 的角度设计量化方案,而不是单纯最小化 key/value 重构误差,这为极低比特 KV cache 量化在生成式世界模型中的适用性提供了新的评判维度。
- QuantWM 通过 QSAC 与 PSAC 两个互补技术,在 2-bit 极低比特下同时控制 Key 误差的关键通道分布和残余误差子空间,实现 training-free 且硬件友好的时序一致性。QSAC 利用离线统计的历史 Query 敏感度指导聚类中心选择,使量化误差集中于对注意力不敏感的通道;PSAC 则通过低秩投影在主导 Query 子空间直接补偿残余 Key 误差,稳定 attention logits。与依赖校准集或训练补偿的方法相比,该框架无需梯度更新,额外计算开销有限,却能在多个视频世界模型上将 KV cache 内存压缩至 6.20 倍,为低比特量化在长视频生成场景中的工程落地提供了可行路径。
方法
方法流程
QuantWM 是一个训练免费的 2-bit KV cache 量化框架,针对视频世界模型长序列生成中的 KV cache 内存瓶颈。输入为视频世界模型推理过程中动态增长的 Key 和 Value 缓存,输出为 2-bit 量化后的 KV cache,目标是在保持视觉质量与时间一致性的前提下实现最高 6.20 倍压缩。
关键模块
1. 量化敏感性感知聚类 (QSAC)
传统 2-bit 量化直接对 Key 通道做均匀聚类,忽略了不同通道对注意力 logits 的影响差异。QSAC 联合考虑历史 Query 敏感性与 Key 残差范围,为每个通道选择更适配 INT2 表示的质心。具体做法是:
- 统计历史 Query 在 Key 各通道上的能量分布,识别对注意力影响更大的敏感通道;
- 在这些敏感通道上使用更精细的聚类质心,减少量化误差;
- 非敏感通道则分配更粗的质心,以平衡整体 bit 预算。
2. 主子空间注意力补偿 (PSAC)
即使 QSAC 降低了敏感通道误差,Key 量化仍可能改变注意力 logits,导致 Query 选择的时序-空间 token 发生偏移。PSAC 通过低秩投影在主导 Query 子空间上恢复 Key 的残差误差:
- 提取 Query 的主子空间方向;
- 将 Key 量化残差投影到该子空间,得到一个低秩补偿项;
- 在注意力计算前将补偿项加回量化后的 Key,直接稳定注意力 logits。
该补偿只增加少量额外计算,但能显著修正因量化引起的 token 选择偏移。
与同类方法差异
现有 2-bit KV 量化方法(如针对 VBench 优化的方案)只关注最小化 Key/Value 的重建误差,未考虑视频世界模型中注意力 logits 和时序-空间 token 选择对视觉一致性的关键影响;QuantWM 首次将注意力 logits 稳定性作为量化目标,通过 QSAC 与 PSAC 协同抑制量化引起的注意力偏移。
实验
实验设计
在五个视频世界模型上评测 QuantWM:LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video、Causal-Forcing。对比基线包括现有 2-bit KV cache 量化方法,这些方法在 VBench 等传统视频基准上接近无损,但在世界模型中表现退化。评测维度覆盖视觉质量、时序一致性、KV cache 内存占用与端到端延迟。
关键发现
现有 2-bit 量化在视频世界模型中导致严重时序闪烁和视觉退化,尽管 Key 量化重建误差小于 Value,但其对注意力 logits 和 temporal-spatial token 选择的扰动是主因。QuantWM 通过 QSAC 聚类与 PSAC 低秩补偿,直接稳定注意力 logits,显著提升视觉质量与时序一致性,实现最高 6.20 倍 KV cache 压缩,且额外开销有限。
与基线对比解读
与通用 KV 量化相比,QuantWM 首次针对世界模型注意力机制定制量化策略:QSAC 依据历史 Query 敏感度选择 INT2 友好中心,PSAC 在主导 Query 子空间恢复 Key 误差,二者协同减少注意力偏移。该训练免费方案在多个世界模型上均优于基线,证明任务特化设计对部署效率的关键价值。
行业影响
落地场景
QuantWM 主要解决视频世界模型(如 LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video)在长序列生成时的 KV cache 内存瓶颈,适用于:
- 自动驾驶仿真:世界模型生成驾驶场景,要求长期时序一致性,QuantWM 可保持连续帧稳定,避免场景闪烁。
- 短视频/直播内容生成:内容平台利用世界模型生成连贯视频片段,量化降低单次生成成本,支持高并发推理。
商业价值
- 降本:2-bit 量化最高实现 6.20 倍 KV cache 压缩,降低显存占用,允许更长上下文或更大 batch,减少 GPU 资源需求。
- 提质:通过稳定注意力 logits,减少时序闪烁和视觉退化,提升生成视频质量,改善用户体验。
- 零训练成本:方法训练无关,可直接应用到现有模型,避免额外训练开销。
与现有产品/工作流的接口
- 作为推理引擎插件,集成到
vLLM、TensorRT-LLM等框架的 KV cache 管理模块,对上层应用透明。 - 依赖历史 Query 统计(QSAC)和低秩投影修正(PSAC),需要在线维护少量统计量,对推理延迟影响有限。
- 与权重量化、激活量化正交,可叠加使用,进一步压缩模型整体内存。
具体落地 use case:在电商平台的虚拟试穿/产品动画生成中,世界模型需生成长时间连贯的产品演示视频,QuantWM 可在有限显存下支持更长生成,提升生成效率与视觉稳定性。
局限
- 方法仅针对视频世界模型中的 KV 缓存量化,且聚焦于 2-bit 场景;对于更低位宽(如 1-bit)或通用 LLM 推理缓存,未做讨论。训练无关的设计避免了重训练成本,但也放弃了通过微调进一步恢复精度的手段,可能难以达到训练感知量化的上限。该局限在论文中未明确提及,但可从方法选择推断。
- 实验仅覆盖五个视频世界模型,且均基于 DiT 架构;不同架构的注意力机制差异可能导致 **QSAC** 的 Query 敏感度聚类策略失效,需要额外验证。此外,评估主要关注视频生成质量与时间一致性,缺少对语言指令遵循、长视频生成等更全面任务的覆盖。
- **PSAC** 引入低秩投影补偿,虽然作者声称额外开销有限,但在超长序列(如长视频生成)下,投影计算和存储开销可能随序列长度线性增长,论文未提供极端长度下的效率分析,部署时需谨慎。