RRSI: Agent Harness 的正则化递归自我改进
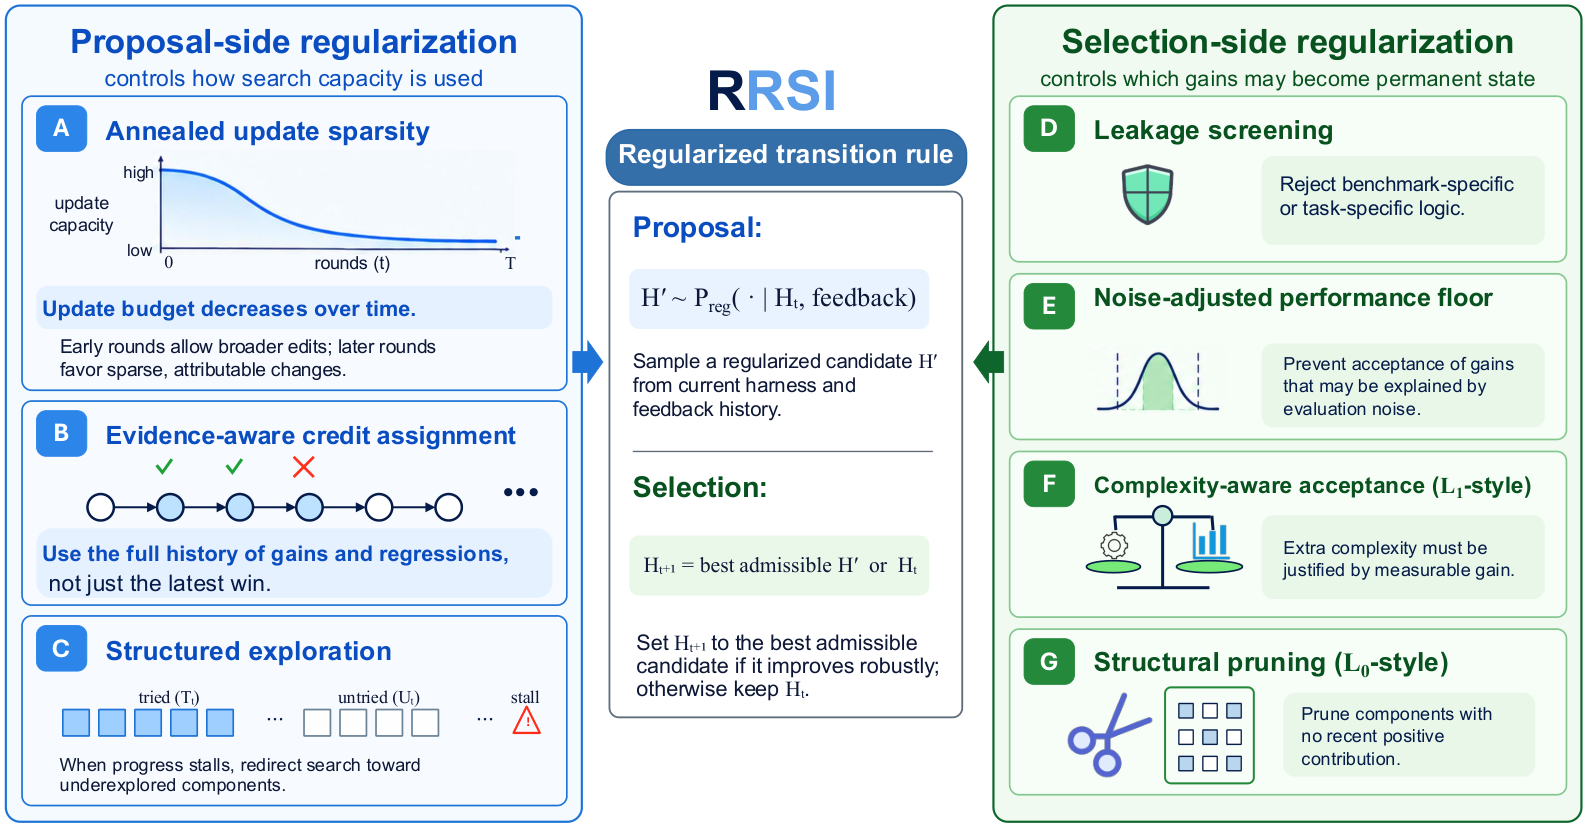
LLM agent 的能力在很大程度上被其 harness 放大,即围绕冻结 backbone model 的 prompts、控制流、tooling、memory 与 context management。近期方法通过迭代地提议并筛选 agent harness 的组件级编辑来实现自动化,在 agent 系统层面实际形成了一种 recursive self-improvement (RSI)。然而这类递归演化可能通过记忆训练任务而过拟合:在 in-distribution 上增益很大,到 out-of-distribution 基准上却缩水甚至消失。 RRSI 将正则化原则引入 harness 的自我改进,对演化候选的提议与选择施加约束: - proposer 使用随时间退火的预算,限制单个候选可捆绑的编辑数量,并依据演化历史鼓励探索未走过的轨迹; - selector 配备 critic 与 pruner:critic 筛除 benchmark-specific 的提议,pruner 移除过小、过贵或已不再有用的改动。 这些约束共同偏向可复用的 agent 机制,而非仅对单一 benchmark 有效的改动乃至噪声。 在覆盖 coding、agentic workspace 与 engineering design 任务的 八个 benchmark 上,RRSI 在自身演化所用的 split 上最高提升 14.1 分,在五个 out-of-distribution benchmark 上最高提升 4.7 分,同时产出的 harness 比未正则化的演化少用 30% 的 policy tokens。代码见 https://github.com/google-research/rrsi ,项目主页见 https://regularized-rsi.com/ 。
论文精读
TL;DR RRSI 通过约束 agent harness 的演化提案与筛选,防止递归自改进过拟合训练任务,在 8 个基准上同时提升分布内与分布外表现,并减少 30% 策略 token。
问题
问题背景
LLM agent 的能力在很大程度上取决于其 harness(提示词、控制流、工具、记忆、上下文管理),而 backbone 模型通常保持冻结。近期工作开始自动化地提出和选择 harness 的组件级编辑,在 agent 系统层面引入递归自我改进(RSI)。
现有方法局限
这类递归演化容易过拟合训练任务:在分布内基准上获得大幅提升,但在分布外基准上增益收缩甚至消失。具体技术缺陷包括:
- 提案侧允许一次性捆绑过多编辑,加剧对训练集细节的记忆;
- 选择侧缺乏对 benchmark 特定 proposal 的筛选,也没有舍弃过小、过贵或已失效的改动;
- 搜索过程未利用演化历史来引导探索,导致大量噪声组件被采纳。
为什么这个问题难且重要
难点在于必须区分可复用的 agent 机制 与仅对特定 benchmark 有效的噪声,而评估信号本身噪声高、演化搜索空间巨大。业界对自动构建 agent 的需求强烈,因为手写 harness 耗时且难以复用;但若自动演化只优化在开发集上,部署后泛化差,会直接损害生产系统的可靠性。因此,如何把传统 ML 的正则化思想迁移到 agent 系统级演化,是当前 agent 工程的关键挑战。
行业类比
类似于 AutoML 中只用验证集调参却忽视泛化误差,或者训练模型时不加 weight decay 导致对训练数据过拟合——agent harness 的递归自我改进同样需要显式正则化来防止“记住题目而不是学会解题”。
核心洞察
- RRSI 的核心洞察是将正则化原则从模型权重训练迁移到 agent harness 的递归自我改进过程。与之前仅迭代选择候选编辑的 RSI 方法(如基于 DSpy 的变体)不同,RRSI 同时约束 proposal 和 selection 两端:proposer 通过退火编辑预算和结构化探索抑制对特定训练任务的记忆化,selector 通过泄漏筛选和复杂度感知接受过滤掉仅在 benchmark 上有效但缺乏泛化价值的修改。这种双向正则化将 harness 演化从“拟合训练任务”重新定向为“发现可复用的 agent 机制”,解释了为何在 ID 增益最高 14.1 点的同时,OOD 仍能稳定获得 4.7 点提升,且策略 token 消耗减少 30%。
- RRSI 提出的证据感知信用分配和稳定性感知接受机制值得关注:它不是简单按最终得分选择候选,而是利用组件级编辑历史和噪声容忍阈值来评估每次修改的真实贡献。这解决了 harness 演化中常见的问题——单次编辑可能因与后续编辑交互而掩盖或夸大其独立效果,导致基准特异性过拟合。通过要求增益超过噪声容忍度才接受,以及移除过小、过贵或不再有用的变更,RRSI 在搜索过程中主动剪枝,使最终 harness 更紧凑、可解释且跨任务迁移性更强。
方法
输入 是一个冻结的 LLM 骨干及其 agent harness(提示、控制流、工具、记忆、上下文管理),以及用于进化的一组任务(benchmark)。
提议器(Proposer)侧正则
- 退火稀疏性:模拟 L0 正则,编辑预算随时间逐渐收紧,限制单次候选捆绑的组件级改动数量,避免大爆炸式修改。
- 证据感知信用分配:根据编辑历史中对性能增益的实际贡献,只把正向信用分配给相关组件,降低噪声编辑被强化的概率。
- 结构化探索:维护进化历史,优先提议尚未尝试过的轨迹,提升搜索多样性。
选择器(Selector)侧正则
- 泄漏筛选(critic 部分):检测并拒绝过度拟合特定 benchmark 的候选,防止把任务特有捷径当作通用机制。
- 稳定性感知接受:只接受增益超过噪声容限的候选,避免随机波动导致的选择。
- 复杂度感知接受(类似
Ridge/L2正则):惩罚过于复杂或推理开销过大的改动。 - 结构化剪枝(类似
Lasso/L1正则):移除增量过小、成本过高或已无用的编辑。
输出 是一个经过正则化演化的 agent harness,在训练任务上提升明显,且在 OOD benchmark 上也有稳健增益,同时推理 token 消耗降低约 30%。
与现有递归自我改进方法不同,RRSI 显式在候选生成和选择两端施加统计正则化约束,使搜索偏向可复用的 agent 机制,而非训练集记忆。
实验
实验设计
RRSI 在 8 个 benchmark 上验证,覆盖 coding、agentic workspace、engineering design 三类任务。演化阶段使用某个 split 进行 harness 自改进,然后在 5 个 out-of-distribution (OOD) benchmarks 上评估泛化能力。对比基线包括 未正则化的 recursive self-improvement (RSI)。
关键发现
- 在演化 split 上,RRSI 最高提升 14.1 points。
- 在 5 个 OOD benchmarks 上,最高提升 4.7 points,显示正则化显著抑制了过拟合。
- 生成的 harness 运行所需的 policy tokens 减少 30%,表明 RRSI 不仅提升效果,还降低推理成本。
与基线对比解读
未正则化 RSI 在训练任务上表现强劲但在 OOD 上增益大幅缩减甚至消失,暴露出记忆训练任务的问题。RRSI 通过 proposal 端的 annealed budget、structured exploration 和 selection 端的 critic、pruner,偏向可复用的 agent 机制,同时剪除微小、昂贵或无用的改动。这解释了其在 OOD 上的稳健提升和 token 效率的改进。相较于单纯追求 ID 分数,RRSI 更符合实际部署中对泛化和成本的双重需求。
行业影响
RRSI 将正则化引入 agent harness 的递归自改进,抑制过拟合,同时降低推理 token 消耗。对工业界的核心价值在于:让 agent 系统的自动化调优更稳健、更经济。
落地场景
适用于任何大规模部署 LLM agent 的产品或业务,尤其是需要频繁更新提示、工具链和上下文策略的场景。典型如电商导购助手、代码辅助工具、企业知识库问答、金融合规审查 agent 等。RRSI 可在训练任务集上自动搜索更优 harness,同时保持对未见任务的一定泛化能力,适合作为 agent 发布前的优化步骤或线上持续改进的环节。
商业价值
- 降本:论文报告 RRSI 产出的 harness 比未正则化进化少消耗 30% 的 policy token,直接降低推理成本。
- 增效:在分布外基准上最高提升 4.7 点,减少因过拟合导致的上线后性能回退,提升客户体验与任务成功率。
- 省人力:自动化替代大量手工提示工程和工具编排调优,缩短迭代周期。
跟现有产品/工作流的接口
RRSI 可作为 agent 开发流水线中的一个优化模块,输入为当前 harness 配置、评估集和骨干模型,输出改进后的 harness。它可以与现有 agent 框架(如 LangGraph、AutoGen、CrewAI)解耦,通过配置文件或版本管理工具(如 MLflow、Weights & Biases)集成。在 CI/CD 中增加一个 evolution stage,使用少量有标签任务训练 RRSI,然后在更广泛的回归集上验证。
具体 use case:
- 电商购物助手:对多种商品类目的问答、推荐和下单流程进行 harness 自动优化,减少不必要的工具调用和上下文注入,在降低 token 成本的同时保持跨类目泛化。
- 企业代码审查 agent:自动调整代码检索、diff 分析和反馈模板,通过 RRSI 找到可复用的审查机制,而非记忆特定代码库噪声,提升跨项目审查质量。
局限
- - **OOD 增益仍然有限**:尽管 RRSI 在多个 OOD benchmark 上取得一致提升,但最大幅度仅 4.7 点,远低于同分布上的 14.1 点。这表明正则化缓解了但未消除 harness 对训练任务分布的过拟合。在更极端的分布偏移或长尾场景下,组件级编辑历史与 critic 筛选可能仍无法保证泛化,agent 可能过度依赖特定 benchmark 的表面特征。未来需引入更强的不变性约束或大规模跨域训练集。
- - **方法复杂性与超参数敏感**:RRSI 引入了 annealed budget、noise floor、pruning thresholds、structured exploration 状态、domain-specific guards 等多个正则化组件,每个都可能需要额外调参或领域知识。论文虽给出超参数设置,但在新任务上复制需要大量实验成本。此外,critic 与 pruner 的质量直接影响筛选效果,若 critic 本身被 benchmark-specific 信号误导,可能错误丢弃通用性改动。
- - **计算开销与可扩展性**:多轮递归自改进需要反复提案、评估、筛选,并维护历史与结构化探索状态,内存与 token 成本可能显著高于单轮优化。虽然最终 harness 减少了 30% 的 policy tokens,但训练过程中的搜索成本未明确权衡。与端到端自动提示优化(如 DSPy)相比,RRSI 的组件级搜索空间更大,可能难以扩展到更复杂的多智能体系统或长 horizon 任务。