Complex KDA: 理解并增强 Kimi Delta Attention 的表达能力
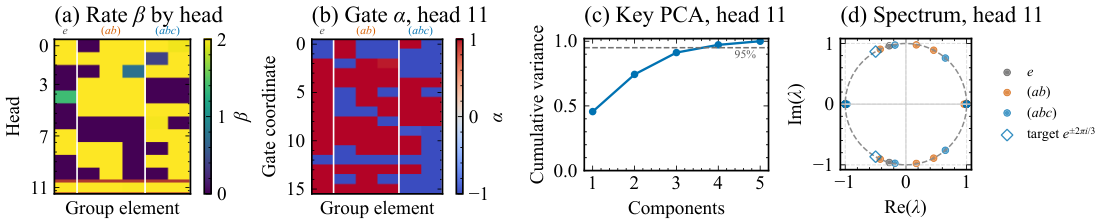
基于 delta-rule 的线性 RNN 能高效建模序列,但低秩修正的线性更新限制了其表达能力。已有工作表明,在单次循环更新中复合两个 delta-rule 转换可建模 2D 旋转,代价是更新的秩与计算成本上升。 本文证明 Kimi Delta Attention (KDA) 可借助单个 delta-rule 变换,加上其 channel-wise gate 提供的第二次反射来实现 2D 旋转。为此需合并两种已有的范围扩展:允许 gate 取值于 [-1,1],并令 delta-rule 系数 β 取值于 [0,2]。所得模型称为 Complex KDA (CKDA),它保持 KDA 的稳定性与效率,transition 仍为 diagonal-plus-rank-one 且非扩张,同时达到 DeltaProduct2 的状态追踪表达能力。 理论上,作者刻画了 CKDA 的表达能力,证明每个正交的 diagonal-plus-rank-one 矩阵都恰好是一个 CKDA transition matrix。单层 CKDA 即可追踪所有与 SO(3) 子群同构的有限群;在许多 state-tracking 结果中,CKDA 比其他 diagonal-plus-rank-one 线性 RNN 少用一层。 实验中,两种扩展的结合在 S3、S4 与周期性音频续写上取得所测 KDA 范围设置中最强的长度外推。在语言建模上,CKDA 优于 Transformer 与其他线性 RNN,与 KDA baseline 结果相近,并展现出有前景的 scaling 行为。代码与模型均已开源。
论文精读
TL;DR 通过扩展 Kimi Delta Attention 的参数范围(门控 [-1,1]、β [0,2]),Complex KDA 用单步 delta-rule 加反射实现 2D 旋转,表达能力对齐 DeltaProduct_2,且保持高效稳定,语言建模和长度外推更强。
问题
问题背景
高效序列建模领域,线性 RNN 与 线性注意力 因推理时的线性复杂度 而受关注,但其状态更新常局限于低秩修正,导致状态跟踪 表达能力不足,难以复现 Transformer 在算法推理与长程记忆上的表现。
现有方法局限
基于 delta rule 的线性 RNN 将新状态写成旧状态加一个rank-one 修正,天然具有对角加低秩的结构,但单步变换无法表示二维旋转。DeltaProduct 通过组合两次 delta-rule 转移实现旋转,却把更新矩阵的秩从 1 提升到 2,参数与计算量翻倍,且破坏了原本简洁的对角+rank-one 形式,导致实现复杂度和内存开销上升。Kimi Delta Attention (KDA) 虽引入逐通道门控,但原始参数范围(门控在 [0,1],β 在 [0,1])不足以让单次转移覆盖旋转群。
为什么这个问题难且重要
要同时获得旋转表达力与高效更新,需要重新设计参数域,使单步转移矩阵仍为对角+rank-one 且保持非扩张(保证数值稳定)。论文证明只要扩展门控到 [-1,1] 且 β 到 [0,2],就能让每个正交 DPLR 矩阵恰好成为 CKDA 的转移矩阵,这是对现有线性 RNN 表达力边界的精确刻画。状态跟踪能力直接关联有限状态自动机与群前缀积的可学习性,是评估序列模型能否处理结构化算法任务的核心指标,对长上下文推理、代码生成等场景有实际意义。
行业类比
就像在端侧部署语音助手时需要模型能稳定跟踪对话状态与周期性音频信号,且不能引入二次方以上的注意力成本,CKDA 在保持线性复杂度与稳定性的前提下补足了旋转等关键表达能力,为超长序列的低成本建模提供了新选项。
核心洞察
- 参数范围扩展使单层 KDA 获得 2D 旋转表达能力。通过同时将 gate 范围拓宽到 [-1,1]、delta-rule 系数 β 拓宽到 [0,2],CKDA 将原本需要两层 delta 规则组合才能实现的 2D 旋转压缩进单层更新,且保持对角加秩一结构与非扩张性。与 DeltaProduct_2 相比,CKDA 以更低秩的更新达到相同状态追踪表达能力,揭示了门控机制作为“反射”补充 delta 规则旋转的潜力。
- 定理刻画了 CKDA 转移矩阵与正交对角加秩一矩阵的等价性,证明所有正交 DPLR 矩阵都是 CKDA 转移矩阵。这一结果把状态追踪能力从经验观察提升为可判定的代数条件,解释了为何 CKDA 能在 SO(3) 子群上单层追踪 S_4 等有限群,而同类对角加秩一线性 RNN 往往需要更多层。该刻画为后续针对旋转对称性的参数初始化与正则化提供了明确的理论锚点。
方法
输入与状态表示
CKDA 接收序列 token,线性投影得到查询、键、值与逐通道门控;隐藏状态为零初始化,逐 token 更新。
关键模块:双区间扩展与单步旋转
核心创新同时扩展 KDA 两个参数区间:逐通道门控 gate 从 [0,1] 扩到 [-1,1],使门控可扮演 反射 角色;delta-rule 更新系数 beta 从 [0,1] 扩到 [0,2],使单次 delta-rule 变换覆盖更大旋转角度。两者结合后,单次状态更新等价于“一次 delta 规则变换 + 一次门控反射”,能精确实现二维旋转,无需 DeltaProduct_2 那样堆叠两个 delta-rule 子步。更新矩阵保持 对角加秩一 结构且具有 非扩张性,避免状态爆炸与记忆不稳定。
输出与训练
每步状态经读出层映射为 logits,用于下一 token 预测或状态跟踪分类;训练用标准交叉熵,无额外正则项,初始化适配扩展后的参数范围。
与 DeltaProduct_2、RWKV-7 等对角加秩一线性 RNN 相比,CKDA 以单次更新、相同状态容量达到更高有限群跟踪表达力,许多任务可比同类方法少用一层。
实验
实验设计
实验围绕 两个核心验证目标 展开:
- 状态跟踪与长度外推:在群论任务
S_3、S_4以及周期音频续写任务上,对比 CKDA(同时扩展 gate 至[-1,1]、β 至[0,2])与其它 KDA 范围设置的性能。 - 语言建模与扩展性:在语言建模基准上对比 Transformer、其它线性 RNN 和 KDA 基线,并分析 scaling law 行为。
关键发现
- 在
S_3、S_4和周期音频续写任务中,同时扩展两个参数范围 的 CKDA 在长度外推上表现最强。 - 语言建模任务中,CKDA 优于 Transformer 和其它线性 RNN,与 KDA 基线结果相近,并呈现 promising scaling behavior。
- 理论上证明 CKDA 的转移矩阵可精确表示所有 正交对角加秩一矩阵,单层即可追踪
SO(3)的有限子群,相比其它对角加秩一线性 RNN 所需层数更少。
与基线对比的深度解读
相比 DeltaProduct_2,CKDA 在保持 diagonal-plus-rank-one 结构和非膨胀性的前提下,达到了同等的状态追踪表达力。这意味着 CKDA 用更低的秩更新成本实现了原本需要组合两个 delta-rule 转移才能获得的旋转表达能力。在语言建模上,CKDA 相对 KDA 基线没有显著性能损失,但理论表达力增强,为后续高效序列建模提供了更紧凑的架构选择。
行业影响
落地场景:CKDA 适用于对长序列建模与推理效率敏感的产品,例如电商智能客服(多轮对话状态跟踪、长上下文意图识别)与金融时序异常检测(高频数据流式处理)。其线性复杂度与状态跟踪能力可保障低延迟响应与长程一致性。
商业价值:主要收益在降本与体验提升。CKDA 在语言建模上超越 Transformer 且保持线性复杂度,可在相同硬件上支持更长上下文或更高并发,降低单位推理成本,尤其利于边缘或 CPU 部署。同时,其更强的长度外推能力减少长文档处理中的分块误差,提升生成质量。
接口集成:CKDA 作为基于 PyTorch 的开源模型,可作为注意力层的即插即用替换,兼容 HuggingFace Transformers 等框架。推理端利用 recurrent 形式支持流式生成,可对接 vLLM、TensorRT-LLM 等引擎,并适配移动端与嵌入式硬件。其 diagonal-plus-rank-one 结构也便于定制化加速。
局限
- 论文自身承认的局限:CKDA 在语言建模上与 KDA 基线性能相近,并未展示出显著超越,其核心收益集中在状态跟踪任务和长度外推上。同时,作者明确指出单层 CKDA 虽能跟踪 SO(3) 子群的所有有限群,但 A5 需要四维构造,而 S5 存在谱障碍,表明其表达性并非无界,复杂群仍需额外层或高维扩展。
- 可推断的局限:扩展参数范围后,门控 g ∈ [-1,1] 与 β ∈ [0,2] 需要配合约束或初始化策略以保证转移矩阵非扩张和稳定,增加实际调参负担。signed gate 虽提供了三种实现,但在硬件上可能带来额外延迟或内存开销,对生产级推理不够友好。GitHub 仓库仅 2 个 star,社区验证有限,尚未经过大规模真实场景考验。
- 与同类工作对比的弱点:与 DeltaProduct_2 相比,CKDA 虽达到相同的状态跟踪表达性且保持 DPLR 结构,但 DeltaProduct 的乘积形式可表达任意高阶旋转,而 CKDA 单步仅能实现 2D/3D 旋转,更高维旋转需堆叠多层,灵活性不足。此外,实验集中于合成任务和小规模语言建模,缺乏大规模预训练或更广泛下游任务的验证,其优势能否泛化到实际大规模系统尚未得到充分证明。