反思、修订、复用:面向 GUI Agent 的免训练技能演化
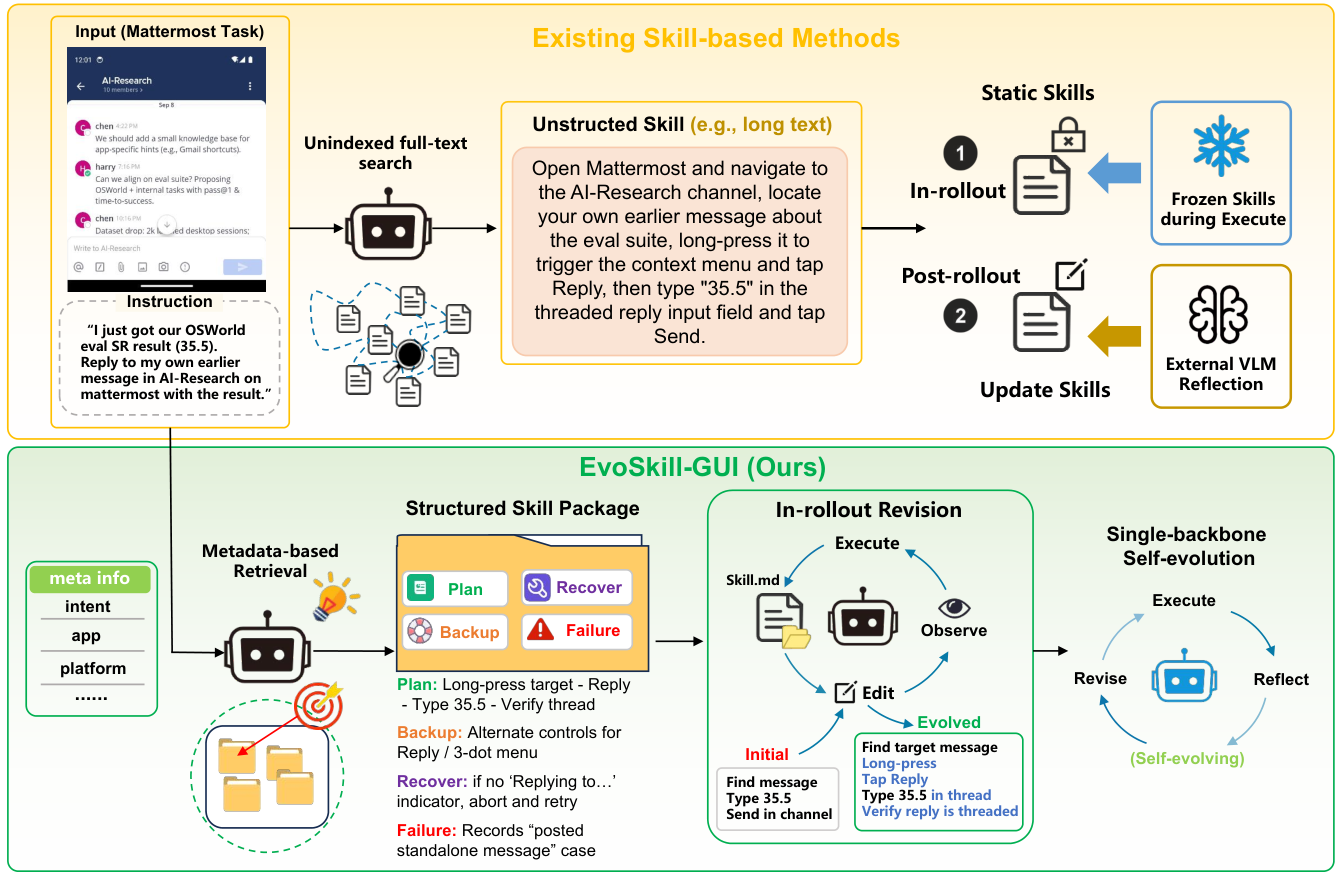
GUI agent 需要在动态图形界面上执行长时程任务,弹窗、延迟加载与控件移位常常让执行前固定的计划失效。近期的 agent 技能框架通过封装可复用的程序性知识来缓解这一问题,但现有技能设计大多并未针对 GUI 执行动态特性,且把技能当作部署前产出的静态产物,而非能在部署过程中持续改进的「活的」程序性知识。 我们认为 GUI agent 需要的不是更好的静态技能,而是能在部署时依据执行反馈、无需额外训练即可修订的技能。为此我们提出 EvoSkill-GUI,一个免训练框架:每个技能都是一个结构化的多文件包,包含检索元数据、可执行计划、备用定位、失败恢复规则、无障碍工具以及失败案例。 EvoSkill-GUI 通过 reflect-revise-reuse 循环运行:(1) 执行器在 rollout 内进行即时修订;(2) 独立的 critic 在严格信息隔离下诊断失败轨迹;(3) 执行器通过受限工具接口编辑特定技能文件。 在 MobileWorld、AndroidWorld 与 OSWorld 三个覆盖移动与桌面的主流 GUI 基准上,EvoSkill-GUI 在完全无需训练的情况下持续提升多个基座模型,最大增益分别达 +16.2%、+6.0% 与 +10.5%;演化后的技能库还能继续惠及相关任务,而非需要从零重建。代码已开源:https://github.com/ZJU-REAL/EvoSkill-GUI。
论文精读
TL;DR EvoSkill-GUI 让 GUI 智能体的技能包在部署时通过反思-修订-复用循环无训练演化,在 MobileWorld、AndroidWorld、OSWorld 上最高提升 16.2%。
问题
GUI 智能体 在动态界面上执行长程任务时,弹窗、延迟加载和控件移位等变化会频繁使预设计划失效。现有技能框架将可复用过程知识封装为静态技能包,在部署前生成,不随执行反馈更新,且技能设计多未针对 GUI 执行动态性,缺乏失败恢复机制。当实际执行遇到界面变化时,静态技能无法即时调整,导致任务失败或需要昂贵的重试。
这一问题在工程上具有挑战性:GUI 环境高度非平稳,无法在训练阶段枚举所有界面状态;部署时的执行反馈是提升技能可靠性的关键信号,但如何在不重新训练的前提下安全地修订技能,避免错误累积和灾难性遗忘,是当前自我演化智能体 技术的核心难点。业界对自主智能体的持续学习能力 和低维护成本 有强烈需求,训练无关的技能演化成为一条有吸引力的路径。
类比于 RPA 流程在运行时遇到异常需要实时处理,而不是每次修改后重新部署整个自动化脚本,GUI 智能体也需要在部署阶段根据反馈动态改进技能,而不是回到离线训练。
核心洞察
- 将 GUI 技能设计为可逐文件修订的**结构化多文件包**,而非静态整体,是适应动态界面长程任务的核心。以往技能库多为部署前生成的不可变文本或代码块,无法应对弹窗、延迟加载、控件移位等运行时变化;EvoSkill-GUI 将每个技能包拆分为检索元数据、执行计划、备用定位、恢复规则、可访问性工具、失败案例等独立文件,执行器可在 rollout 中即时修订,critic 按失败类型精确编辑对应文件。这种细粒度局部更新避免整体重写,且技能库能跨任务累积经验。
- **信息隔离的批评-修订分离机制** 保证了技能演化源于客观轨迹而非执行器自我偏见。大多数自我进化框架让同一模型既执行又反思,或向 critic 暴露完整上下文,容易导致确认偏误和表面修复。EvoSkill-GUI 的 critic 与执行器严格隔离,仅接收失败轨迹和技能文件相关片段,被迫基于真实环境反馈诊断错误;执行器通过受限工具接口只能编辑指定文件,防止过度修改。这种设计使训练无关的技能演化成为可控的工程迭代,无需额外参数更新即可可靠改进。
方法
输入与技能表示
EvoSkill-GUI 接收 任务指令、当前 GUI 屏幕状态及已积累的 技能库。每个技能不是单一文本,而是 结构化多文件包:metadata 记录检索元数据,plan 存放可执行步骤,backup_locator 提供备选元素定位方法,recovery_rules 描述失败恢复规则,accessibility_utils 封装无障碍树操作,failure_cases 保存历史失败样本。
核心循环:reflect-revise-reuse
- 检索:执行器根据当前任务与屏幕的 embedding,计算与技能
metadata的相似度得分,按阈值选出相关技能包。 - 执行与即时修订:执行器按
plan操作,若某步骤失败(弹窗、延迟加载、控件位移),立即利用backup_locator与recovery_rules做 rollout 内修订,避免任务整体中断。 - 隔离反思:失败的完整轨迹送入 隔离 critic。critic 仅观察轨迹与技能包内容,在严格信息隔离下诊断失败原因,输出结构化的编辑建议;不接触执行器内部状态,防止自我合理化的偏置。
- 受限修订:执行器依据 critic 建议,通过受限工具接口只编辑技能包中对应文件(如更新
plan、追加failure_cases、调整recovery_rules),不重写整个技能。
输出与复用
修订后的技能包存回库,供后续相似任务检索复用。整个过程 无需训练,模型参数不变。
与静态技能库方法不同,EvoSkill-GUI 将技能视为部署中持续演化的“活知识”,通过结构化的多文件包和隔离反思实现训练无关的增量改进。
实验
实验设计
EvoSkill-GUI 在 MobileWorld、AndroidWorld、OSWorld 三个主流 GUI 基准上评估,覆盖移动端与桌面端任务。实验采用多个基础模型,应用 reflect-revise-reuse 循环:执行器在 rollout 中即时修订,隔离的评论家诊断失败轨迹,执行器通过受限工具接口编辑技能文件。对比基线包括直接使用基础模型及静态技能方法。
关键发现
- EvoSkill-GUI 在三个基准上均一致提升多个基础模型,最大增益分别为 +16.2%、+6.0%、+10.5%。
- 技能库在相关任务上持续发挥效用,无需从头重建。
- 消融研究显示:结构化技能包优于单体技能文件;即时修订防止级联失败;元数据检索优于全文匹配;信息隔离提升反思质量;无障碍树工具改善跨模型 grounding。
- 技能进化三轮后增益趋于饱和,表明其成本效率。
与基线对比解读
与静态技能相比,EvoSkill-GUI 的核心差异在于技能被设计为可在部署时修订的活知识,而非预生成的固定产物。通过隔离评论家与受限编辑接口,框架避免了执行上下文对诊断的污染,使修订更具针对性。在同等推理预算下,技能进化优于重复采样,说明有向的失败反馈修订比盲目重试更高效。这一训练免费的范式为 GUI 智能体提供了轻量且可迁移的持续改进路径。
行业影响
落地场景
EvoSkill-GUI 适用于需要长期运行、界面动态变化的 GUI 自动化任务,例如电商后台批量处理订单、金融报表自动抓取、企业 IT 工单系统操作、移动端 App 测试等。其训练无关的技能演化机制让技能包在部署后持续从失败轨迹中学习,特别适合界面频繁改版或存在弹窗、延迟加载的复杂业务系统。例如,电商平台的退款审核机器人需跨多个页面操作,界面元素位置常变,EvoSkill-GUI 可在每次执行后自动修订技能文件,无需重新训练模型。
商业价值
核心收益是降低自动化维护成本并提升任务成功率。传统 RPA 脚本和静态技能在界面更新后容易失效,需人工重写;EvoSkill-GUI 的 reflect-revise-reuse 循环使技能库自我进化,减少人工介入。论文显示在主流基准上最大提升 +16.2%(MobileWorld),意味着更少的失败重试和人工接管。同时,技能库可跨任务复用,避免从零构建,进一步摊薄开发成本。对提供 SaaS 自动化服务的企业,这可以直接转化为更高的客户 SLA 达成率。
与现有产品/工作流的接口
EvoSkill-GUI 以结构化技能包(含检索元数据、可执行计划、失败恢复规则等)形式存在,可通过受限工具接口被现有 agent 框架调用,如 LangChain、AutoGen 或自研执行器。
- 集成形态:作为技能库中间件,通过工具接口暴露
load_skill,edit_skill等操作。 - 模型无关:不依赖微调,可直接与 OpenAI、Anthropic 或开源模型 API 配合。
- 部署路径:在现有 agent 循环中插入 critic 和 reviser 模块,无需改动执行器核心。
开源代码(GitHub)提供了参考实现。
局限
- 批评家(critic)与执行器共享同一 backbone 时,自我诊断可能引入系统性偏差。尽管信息隔离减轻了直接泄漏,但错误归因或漏诊仍可能发生,尤其在长轨迹中故障定位的准确性下降。这导致技能修订质量高度依赖 critic 的判别能力,而论文未对 critic 自身的错误率进行定量分析。此外,方法假设执行反馈足够明确且可解析,当环境奖励稀疏或噪声较强时,reflect-revise 循环可能无法触发有效修订,限制了在真实动态 GUI 场景中的鲁棒性。
- 技能库的累积增长缺乏有效的管理机制。随着任务流增加,检索空间扩大,元数据匹配的精度和效率可能退化,且过期或冲突的技能条目可能导致错误的执行策略。虽然论文展示了技能在相关任务上的泛化,但未讨论技能库的容量上限、淘汰策略或一致性维护。另外,结构化技能包的设计和初始生成需要人工定义模板与规则,迁移到新领域时前期准备成本较高。训练免费并不等于免配置,工程落地时需要投入领域知识来构建技能包结构。
- 实验仅在 MobileWorld、AndroidWorld、OSWorld 三个模拟基准上验证,虽然覆盖移动和桌面平台,但与真实生产环境的复杂性仍有差距。评测任务数量有限,模型种类也未覆盖所有主流 backbone,泛化性证据不足。论文附录提及 OSWorld 存在负例,说明技能引导有时会过度复杂化直接操作,引入不必要的步骤导致性能下降。该现象提示方法对任务特征敏感,并非所有 GUI 任务都能从技能演化中获益,尤其对简单或少步任务可能产生负向干扰。