模态自回归世界-动作模型
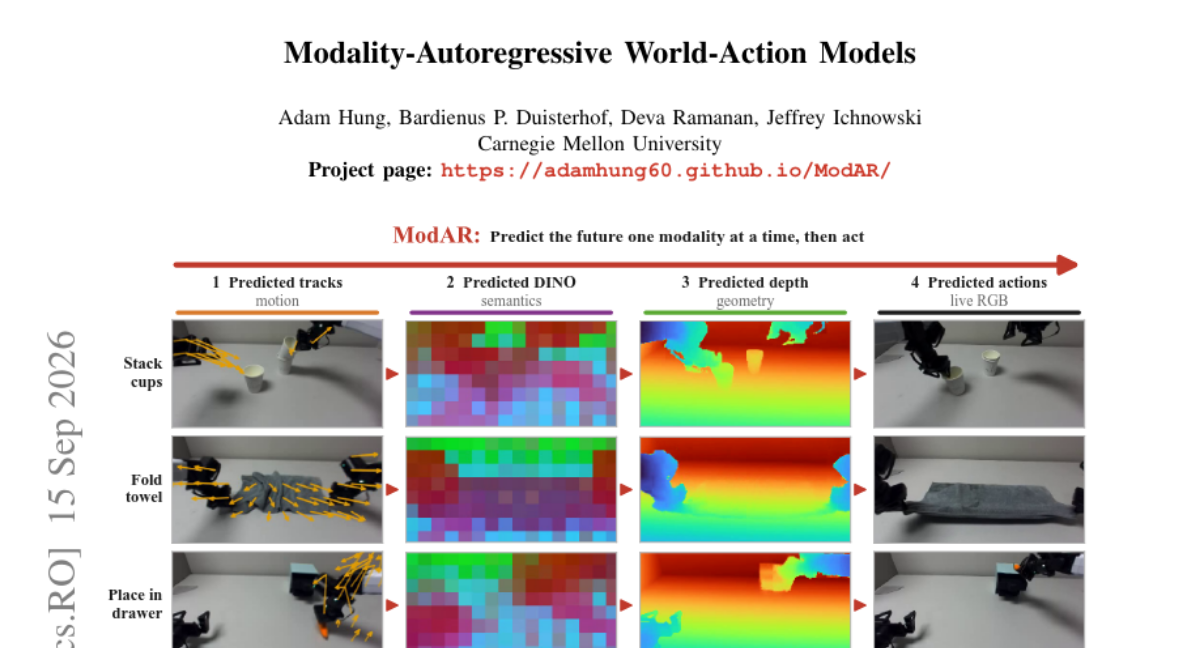
世界-动作模型(WAM) 联合建模未来观测与动作,通常以 RGB 图像形式预测未来。深度图、预训练视觉特征、点轨迹等其他视觉模态能更高效地捕捉几何、语义与运动信息,但如何在 WAM 中最好地组合这些模态仍是未解问题。 我们提出 ModAR,首个在预测动作之前对多种未来模态进行自回归去噪 的 WAM,使每一次预测都能以先前生成的模态为条件。我们从零开始训练,系统研究训练数据配比、预测模态与 WAM 形式对性能的影响。 实验发现: - WAM 能从预测点轨迹、DINO 特征 与 深度图 中获益; - 额外预测未来 RGB 并未带来一致收益; - ModAR 的顺序生成优于现有 WAM 形式,在所有评测数据规模上取得最高平均成功率。 在相同数据上微调由视频模型初始化的 WAM Flex-π 后,ModAR 取得略高的观测平均成功率(75% vs. 72%),同时训练 FLOPs 约少 20 倍,且无需预训练。在三个真实世界双臂任务上,ModAR 优于基线,并能随人类视频数据的引入而持续提升。
论文精读
TL;DR ModAR 是首个多模态自回归世界-动作模型,依次生成点轨迹、DINO特征、深度图等未来模态再预测动作,成功率高于现有 WAM 和预训练视频模型 Flex-π,且训练 FLOPs 节省约 20 倍。
问题
问题背景: 世界-动作模型(World-Action Models, WAMs)在机器人学习中通过联合建模未来观测与动作来学习丰富世界表示,是通用机器人策略的核心组件。
现有方法局限: 现有 WAMs 大多仅将未来观测预测为 RGB 图像,忽视了深度、预训练视觉特征(如 DINO)、点轨迹 等其他模态。这些模态能更高效地编码几何、语义和运动信息,但如何组合它们仍无定论。少数工作尝试多模态预测,但通常采用并行生成或简单融合,未显式建模模态间的顺序依赖,导致生成质量受限或计算浪费。此外,缺乏对训练数据混合、预测模态选择和 WAM 公式的系统性研究,使得设计选择依赖经验而非证据。
为什么这个问题难/重要: 多模态未来观测预测面临表征异质性、模态间条件依赖复杂、以及机器人数据稀缺等挑战。业界对利用无动作视频和预训练模型提高样本效率高度关注,WAMs 的多模态融合能力直接影响下游策略的泛化性和训练成本。本文提出的 ModAR 通过模态自回归去噪顺序生成未来模态,允许后续预测条件于先前生成结果,在仿真和真实机器人任务中显著超越现有方法,同时训练 FLOPs 降低约 20 倍,对实际部署具有很强的吸引力。
行业类比: 类似视频生成模型从仅生成图像扩展到同时生成音频、文本等多模态输出的演进,WAMs 也需要从单一 RGB 预测走向多模态顺序生成,以更全面地建模物理世界的动态与语义。
核心洞察
- ModAR 引入模态自回归去噪,将多种未来观测模态(点轨迹、DINO 特征、深度图)按顺序逐步生成,每个模态预测条件于已生成的模态。这一设计不同于现有世界动作模型普遍并行生成所有模态或仅预测单一 RGB,而是显式建模模态间的依赖关系,使后续模态受益于先前模态的几何、语义或运动线索,提升动作预测所需的表征质量。在多种数据规模下均取得最高平均成功率,证明了顺序生成架构的优越性。
- 论文实证指出,非 RGB 模态(点轨迹、DINO 特征、深度图)作为预测目标比 RGB 图像更能提升世界动作模型性能,且额外预测 RGB 并未带来一致收益。这挑战了以 RGB 为默认未来观测模态的惯例,说明几何运动、语义抽象和空间结构对机器人控制更为关键,而 RGB 像素级细节可能引入冗余或噪声。因此训练数据混合与模态选择应依据任务需求审慎设计,而非盲目堆积 RGB 生成。
- ModAR 从零训练且不使用预训练,在相似成功率下将训练 FLOPs 降至 Flex-π 的约 1/20,优于视频模型初始化的 Flex-π。这表明精心设计的模态自回归条件机制能有效替代大规模视频预训练,大幅降低计算与环境成本,对资源有限的机器人学习部署具有实际意义。
方法
输入与处理流程
ModAR 以当前观察(可包含 RGB、深度、点轨迹或 DINO 特征)与任务描述为输入。首先将观察编码为潜在表示,作为后续生成的初始条件。
关键模块:模态自回归去噪
核心创新是多模态自回归生成:模型按固定顺序对每一种未来视觉模态执行扩散去噪。典型顺序如:点轨迹 → DINO 特征 → 深度图。每生成一种模态后,该模态被拼接到条件输入中,供后续模态去噪使用。这样,每种模态的预测都能利用已生成模态中的几何、语义或运动信息,形成跨模态条件依赖。最后,在所有未来模态生成完毕后,模型基于原始观察与全部生成模态预测动作。
训练从零开始,联合优化:
- 各模态的扩散重建损失(如去噪得分匹配)
- 动作预测损失(分类或回归)
训练数据混合机器人数据与人类视频,以系统研究模态选择、数据规模和 WAM 公式对性能的影响。实验发现点轨迹、DINO 特征和深度图能稳定提升成功率,而额外预测 RGB 未来帧并未带来一致收益。
输出与差异点
输出为未来模态序列与最终动作。与现有 WAM 一次性联合预测所有未来模态(通常仅 RGB)不同,ModAR 通过自回归顺序生成引入跨模态条件依赖,并且聚焦于非 RGB 模态,避免了 RGB 生成带来的计算冗余,在更少训练 FLOPs 下取得更高成功率。
实验
实验设计
ModAR 从头训练,系统研究训练数据混合、预测模态与 WAM 公式对动作成功率的影响。评估覆盖模拟任务与 3 个真实世界双臂操作任务。基线包括现有 WAM 公式与视频模型初始化的 Flex-π 微调。
关键发现
- WAM 从预测 point tracks、DINO features、depth maps 中显著受益;额外预测未来 RGB 没有一致增益。
- ModAR 的逐模态自回归去噪顺序生成优于现有 WAM 公式,在所有数据规模上平均成功率最高。
- 与 Flex-π 相比,ModAR 在真实世界任务平均成功率 75% vs 72%,训练 FLOPs 约少 20 倍,且无需预训练。
- 引入人类视频可进一步提升 ModAR 在双臂任务上的表现。
与基线对比解读
Flex-π 借助大规模视频预训练,但 ModAR 仅从头训练仍略胜一筹,说明模态生成顺序与条件化设计比单纯预训练更关键。这提示工程上可通过精确的模态组合与生成规划,在低算力预算下获得有竞争力的 WAM,而非盲目依赖大规模预训练。
行业影响
落地场景
ModAR 为机器人操作与自动驾驶提供轻量世界-动作建模方案。适用产品包括:
- 工业/仓储机器人:利用 point tracks + depth 进行精确抓取与轨迹规划,减少对高分辨率 RGB 生成的依赖。
- 自动驾驶:以 DINO 特征作为语义先验,结合点跟踪预测未来场景,辅助决策。
- 服务机器人:在双手操作任务中,ModAR 可融合人类视频提升成功率,适合人机协作场景。
具体 use case:电商仓库分拣机器人使用 ModAR 预测深度和点轨迹,在低算力边缘设备上实现实时抓取;自动驾驶仿真测试中,用 ModAR 生成多模态未来状态以加速场景验证。
商业价值
- 降本:比 Flex-π 训练 FLOPs 少约 20×,且无需预训练,大幅降低训练算力与时间成本,使得中小企业可自训专用 WAM。
- 增收/体验:成功率从 72% 提升至 75%(平均),在真实世界中利用人类视频提升性能,直接减少机器人失败率,提升自动化产线效率与用户满意度。
与现有工作流接口
可在现有机器人学习 pipeline 中作为可插拔世界模型:
- 训练时作为辅助目标,帮助动作预测头学习更鲁棒表征;部署时可省略未来观测生成,只保留动作输出,降低推理延迟。
- 与主流视觉 backbone(如 DINO、深度估计网络)无缝衔接,直接使用其输出特征;ModAR 从 scratch 训练,避免依赖特定预训练视频模型(如 Flex-π 初始化的模型),更易定制到私有数据。
- 支持多模态融合,可逐步添加或减少预测模态,以适应不同硬件资源。
局限
- **自回归多模态生成的计算开销**:ModAR 需要顺序去噪生成多个未来模态(如深度、DINO 特征、点轨迹),每一步都依赖上一步输出,这可能导致推理延迟显著高于单模态或并行生成方法。论文未报告推理时间或实时性指标,对于需要高频控制的实际机器人部署,这种顺序依赖可能成为瓶颈。后续可探索并行去噪或仅训练时使用多模态、测试时省略部分生成来缓解。
- **数据规模与预训练依赖的局限**:尽管 ModAR 从零训练且 FLOPs 低于 Flex-π,但其最优性能仍建立在特定数据规模之上(不含大规模预训练)。实验未展示在超大互联网视频数据上的扩展性,而预训练 WAM 可能在该场景下更具优势。此外,发现预测未来 RGB 收益不一致,可能削弱模型对细节纹理的建模能力,在需要精细视觉辨识的任务(如小物体操作)中可能表现不足。
- **评估任务范围较窄且对比不完全**:真实世界实验仅覆盖三个双手操作任务,模拟环境也为特定场景,难以证明在开放世界、复杂动态环境下的鲁棒性。与现有 WAM 的对比仅限于 Flex-π,未与更多 SOTA 方法(如基于世界模型的策略学习、逆动力学模型等)进行充分比较。多模态预测对预训练特征提取器(如 DINO)的质量敏感,其在不同视觉 backbone 下的泛化性未经验证。