面向 LLM 助手的可验证社会推理
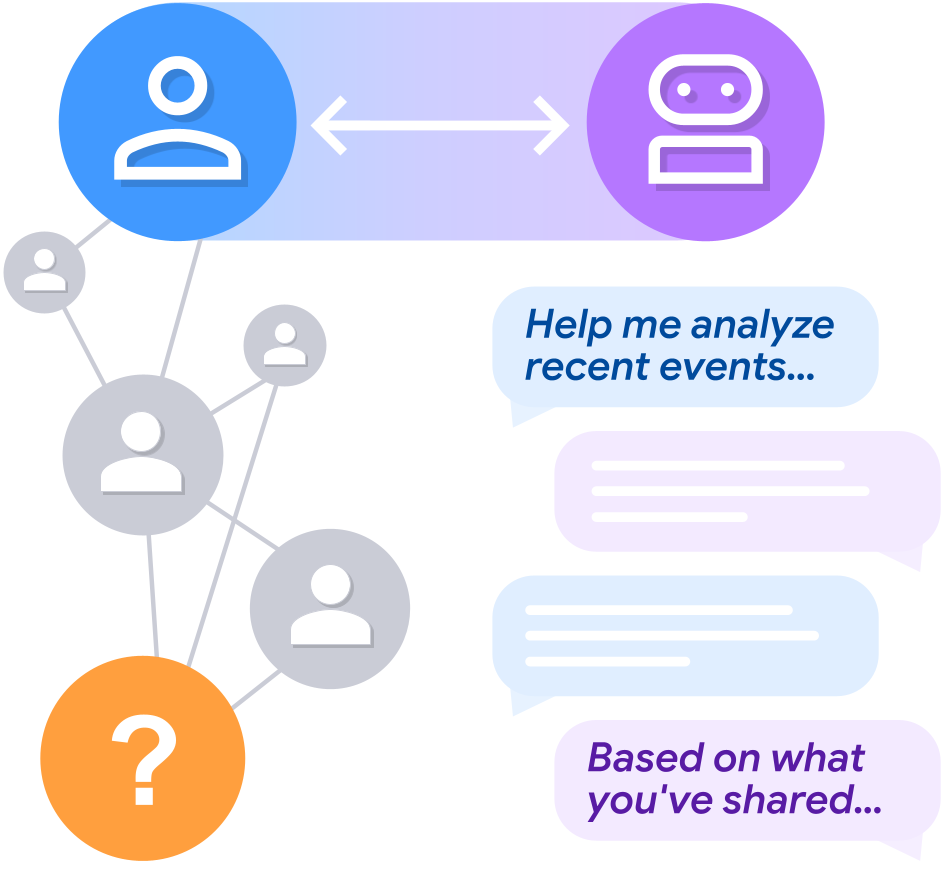
LLM 助手已广泛用于日常社交建议,但在这种咨询场景下评估其社会推理能力仍具挑战:一方面需要让助手从主观的用户叙述中学习社交情境,另一方面诸如他人意图等社交属性通常缺乏可验证的 ground truth。 为此,我们提出 Fuse,一个用于研究用户中介社会推理 的多智能体仿真框架。在 Fuse 中,带有隐藏动机的目标智能体与其他智能体交互,其中一个是代表用户的智能体;随后用户咨询被评估的助手以推断目标智能体的动机,从而在构造上提供可验证的 ground truth。我们通过包含 24k 条标注 的人类研究验证了仿真的忠实性。 我们将 Fuse 应用于 12 个 LLM,并通过系统性地隔离关键因素展示其分析价值: - 用户中介 会加剧社会推理本身的固有难度; - LLM 对带有偏见的用户表述 表现出系统性敏感; - 模型有时需要比人类更多的细节才能得出正确预测; - 更长的对话并不总能提升表现,尽管它提供了澄清提问的机会。 我们开源了 Fuse 以及一个包含 21k 条样本 的数据集。
论文精读
TL;DR Fuse 多智能体模拟框架通过构造隐藏动机的社会交互并采集用户咨询,为 LLM 社会推理提供可验证基准,揭示用户偏差、叙事细节和多轮对话的影响。
问题
问题背景
LLM 助手越来越多被用于日常社交建议与情感支持,社交推理能力成为评估重点。
现有方法局限
当前社交推理评测通常直接将完整客观情境输入模型,但真实咨询中助手只能通过用户主观叙述了解情况,缺少用户中介环节。同时,社交属性(如他人意图、动机)缺乏可验证真值,导致评估结果难以对齐真实能力。现有数据集多基于脚本化故事,无法模拟多主体动态交互与主观视角差异。
为什么难/重要
- 构造可验证真值:需要隐藏目标动机,并让用户代表参与交互,再通过多方叙事验证,技术门槛高。
- 用户中介引入偏差:用户转述可能带偏见、遗漏细节,模型需在噪声中推理,难度高于直接观察。
- 业界关注:AI 助手在心理健康、人际冲突等场景的应用增多,错误归因可能造成实际伤害。
行业类比
类似推荐系统中对用户反馈的归因:模型只看到带偏见的交互信号,却需推断真实偏好,偏差放大直接影响决策质量。
核心洞察
- Fuse 构建了可验证的用户中介社会推理评估:通过多智能体模拟,目标 agent 具有隐藏动机,用户参与互动后向被评估助手转述主观叙述,从而让动机成为已知 ground truth。这解决了以往社会推理评测中意图不可验证的问题,且与直接向模型提供全量情境的范式不同,更贴近真实助手咨询场景。24k 人类标注验证了仿真保真度,为可靠测量 LLM 在主观信息传递下推理能力提供了基础。
- 论文揭示 LLM 社会推理与人类存在系统性差异:模型对用户偏见框架高度敏感,需要比人类更多叙事细节才能得出正确预测,且多轮对话并不总是带来性能提升。这与多数基准只测静态任务不同,Fuse 通过隔离变量展示了这些效应,指出 LLM 可能缺乏先验社会常识或主动澄清策略,对产品设计有直接启示:需要引导用户中性表述、显式建模不确定性、以及设计更有效的追问机制。
方法
Fuse 是一个多智能体模拟框架,用于评估 LLM 在用户中介场景下的社交推理能力。其方法流程如下:
输入:从 ATOMS 社会情境分类出发,生成场景模板,明确目标智能体的隐藏动机(如欺骗、合作等)、角色关系及社会背景。
关键模块:
- 场景生成:将抽象社会概念具体化为可模拟的场景模板,包含隐藏动机及可观察的行为线索。
- 多智能体互动模拟:目标智能体携带隐藏动机与其他智能体(包括代表用户的智能体)进行自然语言对话,生成社交实现(social realization)。
- 用户汇报模拟:用户智能体基于互动经历向被评估助手进行主观叙述(debrief),允许叙事带有偏见或不完整信息。
- 助手评估:被评估 LLM 根据用户叙述推断目标智能体的隐藏动机,采用强制选择预测(forced-choice prediction),并与构造的真值对比计算准确率。
输出:助手对隐藏动机的预测类别及置信度,用于计算准确率、鲁棒性等指标。整个流程确保每个样本都有可验证的 ground truth(隐藏动机为人为设定),避免了传统社交推理中真值缺失问题。模拟忠实度已通过 24k 条人类注释验证,并开源了包含 21k 样本的数据集。
与现有社交推理评估(直接给模型完整客观场景)不同,Fuse 引入用户中介环节,使评估更贴近真实咨询场景,并能通过隔离变量分析用户偏差、叙事细节等因素。
实验
实验设计
Fuse 是一个多智能体模拟框架,通过五步流程生成场景:主题构建、场景模板生成、社会实现模拟、汇报模拟和助手评估。目标智能体持有隐藏动机,与其他智能体(包括代表用户的智能体)交互,用户随后向被评估 LLM 助手咨询以推断目标动机,由此构造出可验证的真值。通过 24k 人工标注验证模拟保真度,并应用于 12 个 LLM。
关键发现
- 用户中介加剧了社会推理的固有难度;
- LLM 对用户偏置框架表现出系统性敏感;
- 模型可能需要比人类更多细节才能正确预测;
- 更长的对话并不总是提高性能,尽管提供了澄清问题的机会。
基线对比解读
论文通过比较助手观察者差距(Assistant-Observer Gap),将用户中介与直接观察者进行对比,量化了用户描述引入的偏差。与人类基线相比,LLM 对用户措辞的敏感性和信息需求差异表明其在社会推理中缺乏稳健性,反映出潜在的对齐与谄媚问题。
行业影响
落地场景
Fuse 框架适用于需要用户中介社会推理的 AI 产品评估,例如:
- 企业服务:HR 辅助机器人分析员工对同事意图的描述,评估模型是否受用户偏差影响。
- 情感陪伴 / 心理咨询:用户向 LLM 倾诉人际冲突,模型需推断第三方动机;Fuse 可生成带真实标签的测试用例。
- 内容平台:社区治理助手根据用户举报描述判断违规动机,避免被单一叙事误导。
商业价值
- 降低评估成本:Fuse 用多智能体模拟自动生成高保真、可验证的社交推理数据,替代昂贵的人工标注(论文验证即用了 24k 人工标注)。
- 减少线上风险:通过系统隔离用户偏差、细节需求、多轮动态等因素,模型厂商可在部署前发现 sycoophancy(迎合用户框架)等缺陷,避免错误社会建议引发的信任危机。
- 加速迭代:将 Fuse 纳入回归测试,每次模型更新自动跑分,把社交推理可靠性量化,直接提升用户体验与留存。
与现有工作流的集成
Fuse 可作为 LLMOps 评估模块 插入现有 pipeline:
- 在 CI/CD 中运行 Fuse 生成模拟对话与 ground truth,计算
assistant-observer gap、bias amplification等指标。 - 与现有安全评测(如红线、价值观对齐)并列,输出统一报告。
- 利用合成数据做微调或强化学习,改善模型在用户偏差下的表现。
例如,将 Fuse 集成到 LangSmith / MLflow 等评估平台,为每个模型版本打上社会推理得分;或用于 人工审核排班系统,优先抽检低分场景。
局限
- **仿真保真度有限**:Fuse 基于多智能体模拟生成用户叙事与对话,其社交场景由预定义的 ATOMS 类别和模板构建,可能无法覆盖真实世界社会互动的全部复杂性与开放性。尽管人类研究验证了仿真可信度,但模拟环境中的动机推断难度、对话动态和用户偏见表达可能与现实咨询场景存在系统性偏差,导致评估结果的外推性受限制。
- **评估指标与任务形式单一**:论文主要采用强制选择预测作为核心指标,仅考察模型能否从候选动机中选出正确项,缺乏对推理过程、置信度校准、解释质量或开放式回答的评估。此外,用户介导的咨询过程被简化为单轮或多轮文本交互,未涵盖语音、情绪信号、非语言线索等真实社交信息,可能低估了模型在更丰富输入下的表现。
- **人类基线对比有限**:虽然进行了大规模人类研究验证仿真,但在模型与人类对比中,人类基线仅覆盖有限子集(如用户介导单消息基线),且参与者可能不具备专业社交推理训练,导致对比不够全面。同时,论文未深入分析不同文化背景、个体差异对社交推理的影响,限制了结论的普适性。