LimiX-2:面向通用结构化数据智能的上下文机制网络
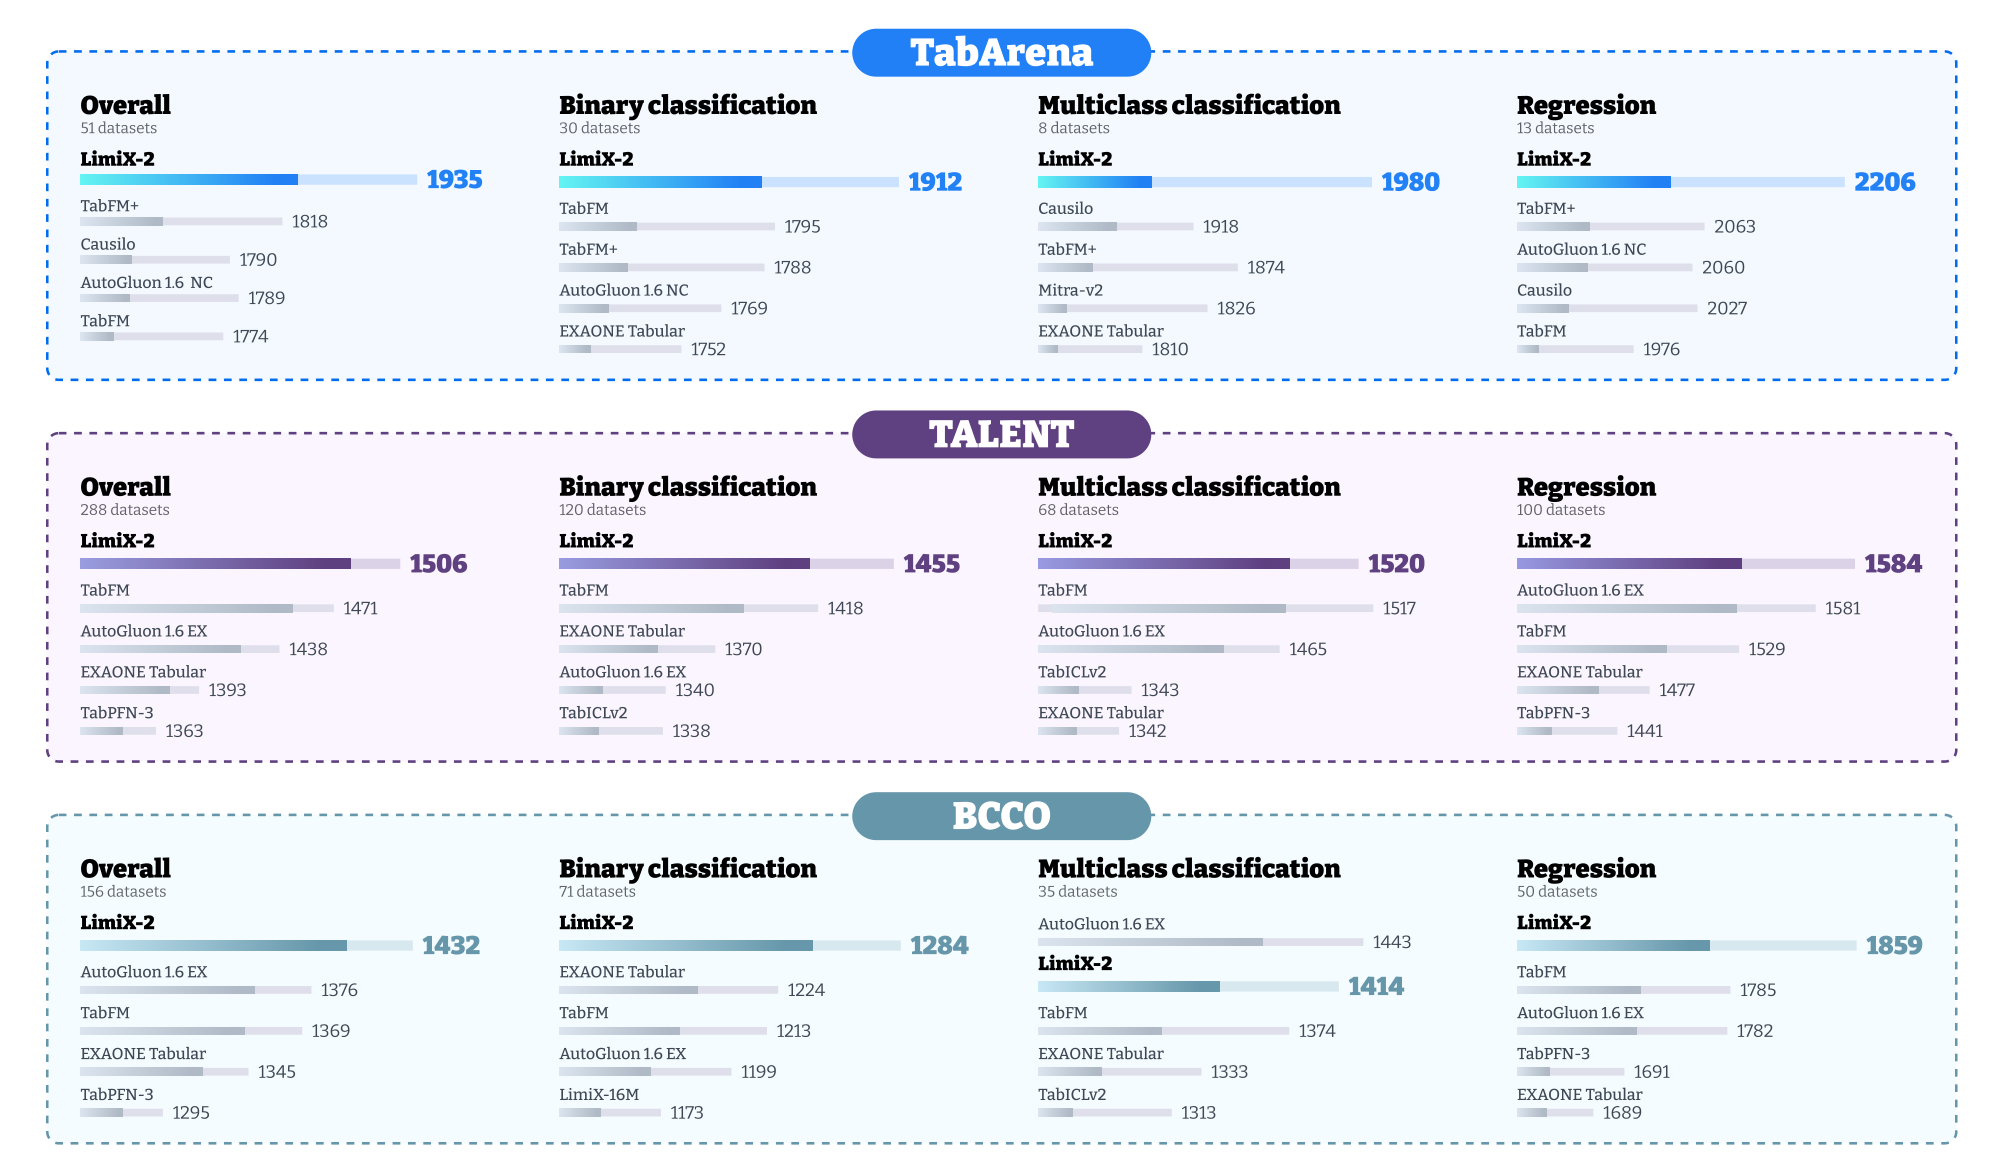
LimiX-2 是 LimiX 家族的新成员,基于此前建立的 scaling laws,通过模型与数据的规模化训练而成。它采用 Contextual Mechanism Networks(CMNs)范式,并以 Context-Conditional Masked Modeling(CCMM)进行预训练。 CMNs 将 in-context learning 的组织原则从以目标为中心的预测,转变为面向机制的联合建模。与传统表格 PFN 围绕 p(y | x, D{context}) 目标构建不同,该网络围绕学习 p(x, y | D{context}) 来设计,即对数据生成背后的联合结构进行依赖上下文的表示。预训练数据由 structural causal models(SCMs)生成的合成数据集构成,覆盖多样的图结构、功能机制与观测过程。 在 TabArena、TALENT 与 BCCO 上的评估表明,LimiX-2 优于当前针对特定数据集训练的模型与表格 foundation models。除预测性能之外,CMN 范式还赋予 LimiX-2 因果意识:其特征注意力编码了直接的因果关系,从而能够准确恢复因果骨架。
论文精读
TL;DR LimiX-2 提出 Contextual Mechanism Networks,将表格数据上下文学习从目标预测转向联合分布建模,通过合成因果数据预训练,在 TabArena 等基准上超越专用模型,并具备因果结构恢复能力。
问题
问题背景
通用结构化数据智能(tabular intelligence)正成为 AI 基础模型的重要方向,研究者试图构建能跨数据集、跨任务进行预测和推理的表格模型。
现有方法局限
以 TabPFN 等为代表的表格先验拟合网络(PFN)将学习目标定位于条件分布 p(y | x, D_context),即给定特征预测目标。这种目标中心式学习存在明显不足:
- 只关注特征到目标的映射,忽略特征之间的联合依赖和底层数据生成机制;
- 难以处理特征缺失、分布偏移和因果推断等场景;
- 预训练通常基于单一分布假设,跨表格泛化能力有限。
为什么这个问题难/重要
表格数据的特征空间高度异质(数值、类别、有序、缺失),特征交互复杂且真实因果结构未知。学习联合分布 p(x, y | D_context) 并从中提取机制性知识,需要模型具备高维依赖建模和隐式因果发现能力,计算与优化挑战大。然而,表格数据广泛存在于金融风控、临床医学、工业质检等领域,通用表格智能的突破将带来显著效率提升。业界对能处理任意表格、具备因果意识的基础模型需求迫切。
行业类比
类似语言模型从预测下一个 token 进化到构建世界模型,表格基础模型也需要从拟合条件分布转向学习数据生成机制,才能逼近真正的通用结构化数据智能。
核心洞察
- LimiX-2 的核心创新在于用 Contextual Mechanism Networks (CMNs) 取代传统 tabular PFNs 的目标中心预测,转而学习上下文条件下的联合分布 p(x, y | D_context)。这一转变迫使模型理解整个数据生成机制,而非仅拟合条件映射,从而在分布外数据和元学习场景中表现更稳健。与 TabPFN 等以 p(y | x, D_context) 为目标的模型相比,CMN 通过联合建模特征与标签的交互结构,提升了模型对底层因果关系的感知能力,为结构化数据智能提供了新的组织原则。
- LimiX-2 通过由结构因果模型 (SCMs) 生成的合成数据进行预训练,并结合 Context-Conditional Masked Modeling (CCMM) 掩码目标,使模型不仅预测准确,还具备因果骨架恢复能力。与依赖随机特征或简单相关性的合成数据生成方法不同,SCM 覆盖多种图结构、函数机制和观测过程,使预训练分布更接近真实世界数据的因果多样性。实验表明,模型的特征注意力直接编码了直接因果关系,无需显式因果发现算法即可从注意力中恢复因果骨架,这为可解释性和因果推断提供了内建支持。
方法
输入与数据流
LimiX-2 的输入由上下文数据集 D_context 和一个查询样本 x 组成。上下文数据以表格形式呈现,每行是一个样本,每列是一个特征,可能包含缺失值。模型需要预测查询样本的目标 y(分类或回归)。
关键模块
- 嵌入层:将表格数据中的类别特征和数值特征统一映射到高维向量空间。类别特征使用可学习的嵌入表,数值特征通过分段线性编码(ple)或类似方案转换为连续向量。
- 判别特征编码:对每个特征列施加独立的可学习变换,增强特征的表征能力,同时保留特征轴的结构信息。
- 骨干网络:基于 Transformer,但采用两个不对称的注意力机制:
- 样本轴注意力:在样本维度上进行自注意力,捕捉上下文样本之间的依赖关系。
- 非对称特征轴注意力:在特征维度上进行注意力,但通过掩码或位置编码限制信息流向,使得每个特征只能关注其因果父节点或相关特征,从而嵌入因果归纳偏置。
- 独立 SwiGLU:每个特征维度使用独立的 SwiGLU 前馈网络,避免特征间不必要的耦合。
- 多头注意力机制保证长序列稳定性。
- 预测头:针对分类和回归任务分别设计输出层。
预训练目标与数据生成
预训练采用 Context-Conditional Masked Modeling (CCMM):对于给定的上下文 D_context,随机掩码部分样本的部分特征,要求模型重建被掩码的值。目标函数等价于学习上下文条件下的联合分布 p(x, y | D_context),而非仅学习条件分布 p(y | x, D_context)。掩码模式经过专门设计(如掩码整行、掩码单特征、掩码目标列等),掩码嵌入使用可学习向量。
预训练数据由 结构因果模型 (SCM) 合成:随机采样有向无环图(DAG)结构、函数机制(线性、非线性、异方差等)和观测过程,生成大量表格数据集,覆盖广泛的因果和统计模式。
输出与因果涌现
模型不仅输出查询样本的预测值,还通过特征轴注意力权重编码了特征之间的直接因果关系。实验表明,从注意力矩阵中可以恢复因果骨架(即哪些特征直接导致哪些特征),无需额外训练。
与同类方法的差异点:传统 tabular PFN 仅以目标为中心建模 p(y | x, D_context),而 LimiX-2 的 CMN 范式以机制为中心学习联合分布 p(x, y | D_context),从而在预测性能之外获得因果结构感知能力。
实验
实验设计
LimiX-2 在三个结构化数据基准上评估:TabArena、TALENT 与 BCCO,覆盖分类、回归、配对比较及元特征子组。预训练数据由结构因果模型 (SCM) 合成,涵盖多种图结构、函数机制与观测过程,采用上下文条件掩码建模 (CCMM)。
关键发现
- 在TabArena、TALENT、BCCO 上,LimiX-2 均优于现有的数据集特定模型与表格基础模型。
- 模型的特征注意力编码了直接因果关系,使其能够进行准确的因果骨架恢复,表明 CMN 范式促进了因果意识。
与基线对比解读
传统表格 PFN 以 p(y|x,D_context) 为目标,预测是目标中心的;LimiX-2 的 CMN 转向学习 p(x,y|D_context) 的联合分布,更接近数据生成机制。这种机制导向的建模可能解释其在跨数据集任务上的泛化优势,以及额外的因果发现能力。但论文未提供具体数值指标与算力细节,因此无法量化对比提升幅度。建议后续关注消融实验与计算成本分析。
行业影响
落地场景
LimiX-2 主要面向表格数据,适用于需要快速预测和因果分析的业务:
- 电商动态定价 / 销量预测:基于商品属性、历史销售等表格数据,直接产出预测。
- 金融信用评分:处理混合类型特征,无需人工分箱或特征工程。
- 医疗风险预测:利用结构化电子病历数据预测疾病概率。
- 企业 BI 增强:嵌入数据分析平台,用户上传表格即可获得模型预测与特征重要性。
商业价值
- 降本:大幅减少每个数据集单独建模的人力与算力消耗,缩短建模周期从数天到分钟级。
- 增收:预测精度提升直接改善业务 KPI(如点击率、转化率、风险识别率)。
- 决策支持:因果骨架恢复能力提供可解释的特征因果关系,辅助业务归因和策略制定。
- 规模化复用:预训练模型跨任务泛化,无需频繁重新训练,提升 AI 资产利用率。
接口与集成
- 作为 AutoML 引擎后端:替换现有表格模型训练组件,接入 ML pipeline(如 Kubeflow、Airflow)。
- REST API 服务:接收 JSON/CSV 格式表格数据,返回预测值、概率和特征注意力权重。
- 与 feature store 协同:从 Feast 等特征平台拉取特征,输出预测,实现实时推理。
- 因果分析模块:输出因果骨架图,可对接 DoWhy 等因果推断库进行干预分析。
具体用例:电商平台使用 LimiX-2 预测用户购买概率,无需为每个品类单独建模,直接调用预训练模型,并利用注意力权重识别关键驱动特征(如价格、促销),优化运营策略。
局限
- - **预训练数据分布偏差**:该模型依赖合成 SCM 数据进行预训练,尽管生成过程覆盖多种图结构和函数机制,但真实表格数据常包含复杂缺失模式、测量误差、异质特征类型及分布漂移,这些在 SCM 生成器中可能未被充分建模。这会导致模型在分布外真实数据上的泛化能力存在不确定性,尤其在金融、医疗等高度非平稳场景中可能难以达到预期性能。
- - **计算与扩展性限制**:CMN 范式要求联合建模 p(x,y|D_context),即对所有特征进行预测而非仅目标变量,这会显著增加预训练的计算量和内存占用。此外,论文中的非对称特征轴注意力机制虽然提升了表征能力,但其复杂度可能与特征数量呈二次增长,限制了模型在超宽表格(如数万列)上的扩展性。实际部署时需权衡模型容量与推理延迟。
- - **因果推断的可靠性风险**:论文通过特征注意力恢复因果骨架,但注意力权重常受特征尺度、相关性和网络结构影响,并不等同于严格的因果效应估计。在存在隐混淆或选择偏差的真实数据中,该方法可能产生错误因果结论。且因果恢复评估仅基于合成 SCM 基准,缺少真实世界因果发现任务验证,其因果可靠性仍需进一步检验。