手指即腿:用拟人手学习自支撑运动与操控
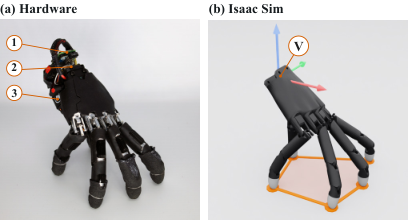
一只会行走的机械手,必须用同一组手指 来完成移动身体、支撑自重以及与环境交互三件事。本文展示了一只 anthropomorphic hand 如何在保留原有手指设计与位置控制器的前提下学会这些技能;其板载电源与计算 让整个平台自包含、无需外部供给。 在方法上,我们的强化学习 方案专门考虑了这只手手指不等的结构特点,并在由硬件测量校准过的模拟器 中完成训练。仿真结果显示,相比原本为四足机器人调优的奖励,我们提出的奖励公式 能让手移动得更快。 在硬件实验中,针对具体任务训练的策略实现了无缆爬行、转向 与跌倒恢复。在支撑自身重量的同时,该手还能在没有视觉的情况下依次执行键盘指令,并借助俯视视觉反馈 把物体推到指定目标。 这些结果展示了一个紧凑的移动操作平台:它复用同一组手指兼顾运动与交互,而无需任何单独的运动机构。
论文精读
TL;DR 一种无需额外移动机构的拟人机械手,利用自身手指作为腿实现自支撑行走与操控,通过强化学习与硬件校准仿真,在实物上完成无绳爬行、转向、跌倒恢复、按键和物体推动等任务。
问题
通用移动操作 是机器人学习的前沿方向,希望单一平台既能稳定移动又能精细操作,避免冗余机构。
现有方法局限:
- 多数移动操作机器人依赖 分离式移动底盘 + 机械臂,体积大、能耗高,难以进入狭小空间或废墟缝隙。
- 已有“手指行走”方案要么修改手指硬件以适配行走,牺牲操作灵巧性;要么使用手工设计步态或简化奖励,无法同时兼顾承重稳定与末端操作。
- 四足机器人上成熟的强化学习奖励函数直接迁移到人手形平台时,会因手指长度、力量分布极不均匀导致策略发散或步态失衡;仿真到现实转移缺乏手指-地面接触的精确校准,真实硬件上策略频繁失效。
为什么难/重要:人手形机器人行走时需同时满足 多指协调支撑、重心动态调整、接触序列优化 三个目标,动作空间维度高(20+ 自由度),而每个手指在承重时还要保留后续操作能力,这是一个高度非凸的优化问题。业界对 紧凑型移动操作平台 的关注持续上升,因为狭小空间巡检、灾后搜救、微型物流等场景要求机器人放弃传统底盘,利用自身末端执行器移动,从而快速切换“移动”与“操作”模式。
行业类比:类似 多任务强化学习 中的共享表示挑战,在传感器与执行器资源极度受限时,单一策略必须平衡移动与操作两个冲突目标,如同自动驾驶中单目摄像头同时用于障碍物检测与车道保持。
核心洞察
- 利用手部不均衡手指的解剖学先验进行**姿态校准的指尖目标**,将四足机器人上针对对称足设计的奖励函数迁移到人手形态上,避免了直接套用现有 locomotion 奖励导致的学习效率低下或步态不自然。该工作的独特之处在于:不是把手指当作通用腿,而是显式建模每根手指的不同角色(例如拇指的偏置位置和力输出),并在奖励中分别校准站立参考框架与足底目标,使 RL 策略在保持手指原有位置控制器不变的前提下,学会利用中指、食指等较长手指承重,而拇指承担辅助支撑与转向。
- 将**移动与操作统一在同一组手指上**,通过任务特定策略切换(键盘按压无视觉、视觉引导物体推送)而不是设计单一多任务策略,展示了自足式移动机械手在受限空间中的工程可行性。相比已有手指爬行机器人(常依赖外部电源或简化手设计),该平台提供**板载电源与计算**,并采用硬件校准的仿真进行 sim-to-real,让同一硬件既能 untethered crawling,又能 fall recovery 和物体操纵。这为未来手臂无法跟随的精细作业场景(如管道内检修)提供了一个紧凑的移动操作范式。
方法
输入与硬件平台
该工作基于 WUJI 拟人右手,保留原手指设计和位置控制器,板载电源与计算单元使其完全自包含,无需外部线缆或独立移动机构。策略输入包括手部关节角度、身体姿态(IMU)、接触状态以及任务指令(如键盘按键序列或目标位置)。
关键模块
- 硬件校准的仿真:使用从硬件测量数据校准的模拟器,缩小 sim-to-real 差异,支持强化学习训练。
- Morphology-Adapted Locomotion 奖励设计:针对拟人手不等长手指的特点,引入 stance-calibrated control frame(以当前支撑手指为参考系)、footprint objective(扩大支撑多边形)、auxiliary lift objective(辅助抬升)和 auxiliary direction objective(辅助方向)等奖励项,替换原先为四足机器人设计的调优奖励。
- 任务特定策略:分别训练爬行/转向、跌倒恢复、无视觉键盘按压、视觉引导推物等策略,通过 RL 优化关节位置命令。
输出
策略输出为手指关节的目标位置,由底层位置控制器执行,实现自支撑移动和操作。
与同类工作的差异点:相比直接将四足机器人调优奖励用于手部,该方法通过支撑姿态校准和形态自适应奖励,在仿真中实现更快移动,并避免额外移动机构,将手变成紧凑型移动操作臂。
实验
实验设计与关键发现
实验设计:论文基于 WUJI 右手 打造自包含平台,在硬件校准的仿真器中训练 RL 策略。主要验证三类能力:自支撑移动(爬行、转向、跌倒恢复)、无视觉键盘按压、视觉引导推物。仿真部分进行奖励项消融,对比原为四足机器人调参的奖励。
关键发现:
- 提出的姿态校准指尖目标等奖励项使手在仿真中移动更快,优于调参后的四足奖励。
- 硬件上实现无系绳的爬行、转向与跌倒恢复,手指同时承受体重并执行操作。
- 无需视觉即可连续按下键盘序列,使用头顶视觉反馈将物体推到目标位置。
基线对比解读:与直接沿用四足奖励相比,针对人手不等长手指和手指-地面接触特性设计的奖励函数显著提升学习速度与性能。这表明形态学特异的奖励设计对多用途末端执行器至关重要。
行业影响
落地场景
手指即腿的紧凑移动机械手可应用于需要同时具备移动与精细操作的场景,典型用例:
- 狭小空间检修:在工业设备内部、管道或受限腔体中,移动手可自行爬入执行拧螺丝、按钮操作,无需额外移动底座。
- 电商仓储拣选:移动手可爬入货架层板之间,用同一手指拨取小件物品并搬运到目标位置,补充传统机械臂无法覆盖的间隙区域。
商业价值
该方案消除了独立移动机构(轮/腿),降低硬件成本与整机复杂度。自包含板载电源与计算使平台无需外部缆线,提升部署灵活性。通过 RL 学会手指行走与支撑,扩展现有末端执行器的功能,使一台机器人完成“移动+操作”双重任务,可能减少设备数量与维护成本。跌倒恢复能力增强在非结构化环境中的鲁棒性,减少停机时间。
与现有产品/工作流集成
可对接现有机器人软件栈:仿真训练环境(如 Isaac Gym / MuJoCo)中校准硬件参数后生成策略,部署到自包含手部平台。接口上,将移动手视作可自移动的末端执行器,通过标准 ROS 话题订阅目标位姿或视觉反馈,与上层任务规划系统(如行为树)衔接。策略可保留原手指位置控制器,降低集成难度。例如在电商仓库系统中,WMS 下发拣选指令,移动手通过头顶摄像头反馈完成闭环操作。
局限
- **任务特定策略限制通用性**:论文中的每个技能(爬行、转向、跌倒恢复、键盘按压、物体推动)都需要单独训练策略,没有统一的多任务模型或在线切换机制。实际部署时需预选或由上层控制器调用对应策略,增加了系统复杂度,也限制了机器人对未知任务的适应能力。
- **移动速度与效率有限**:虽然奖励设计使仿真中的移动速度优于为四足机器人调整的奖励,但作为手指行走,步幅和步频受限于手指长度与关节速度,绝对速度远低于传统轮式或腿式平台。论文未给出具体速度指标,但可推断其适用于近距离精细移动,难以胜任长距离或快速机动。
- **操作鲁棒性依赖环境结构化**:键盘按压任务在无视觉条件下执行,依赖预先标定的按键位置,对环境变化(如键盘位移)的鲁棒性不足;物体推动虽使用头顶视觉反馈,但假设平面工作空间和已知物体特征,对形状、重量的泛化性有限。与专用移动平台相比,手指作为腿的负载能力和耐用性也需长期验证。