拉平长上下文 Mixture-of-Experts 训练中的每一处显存峰值
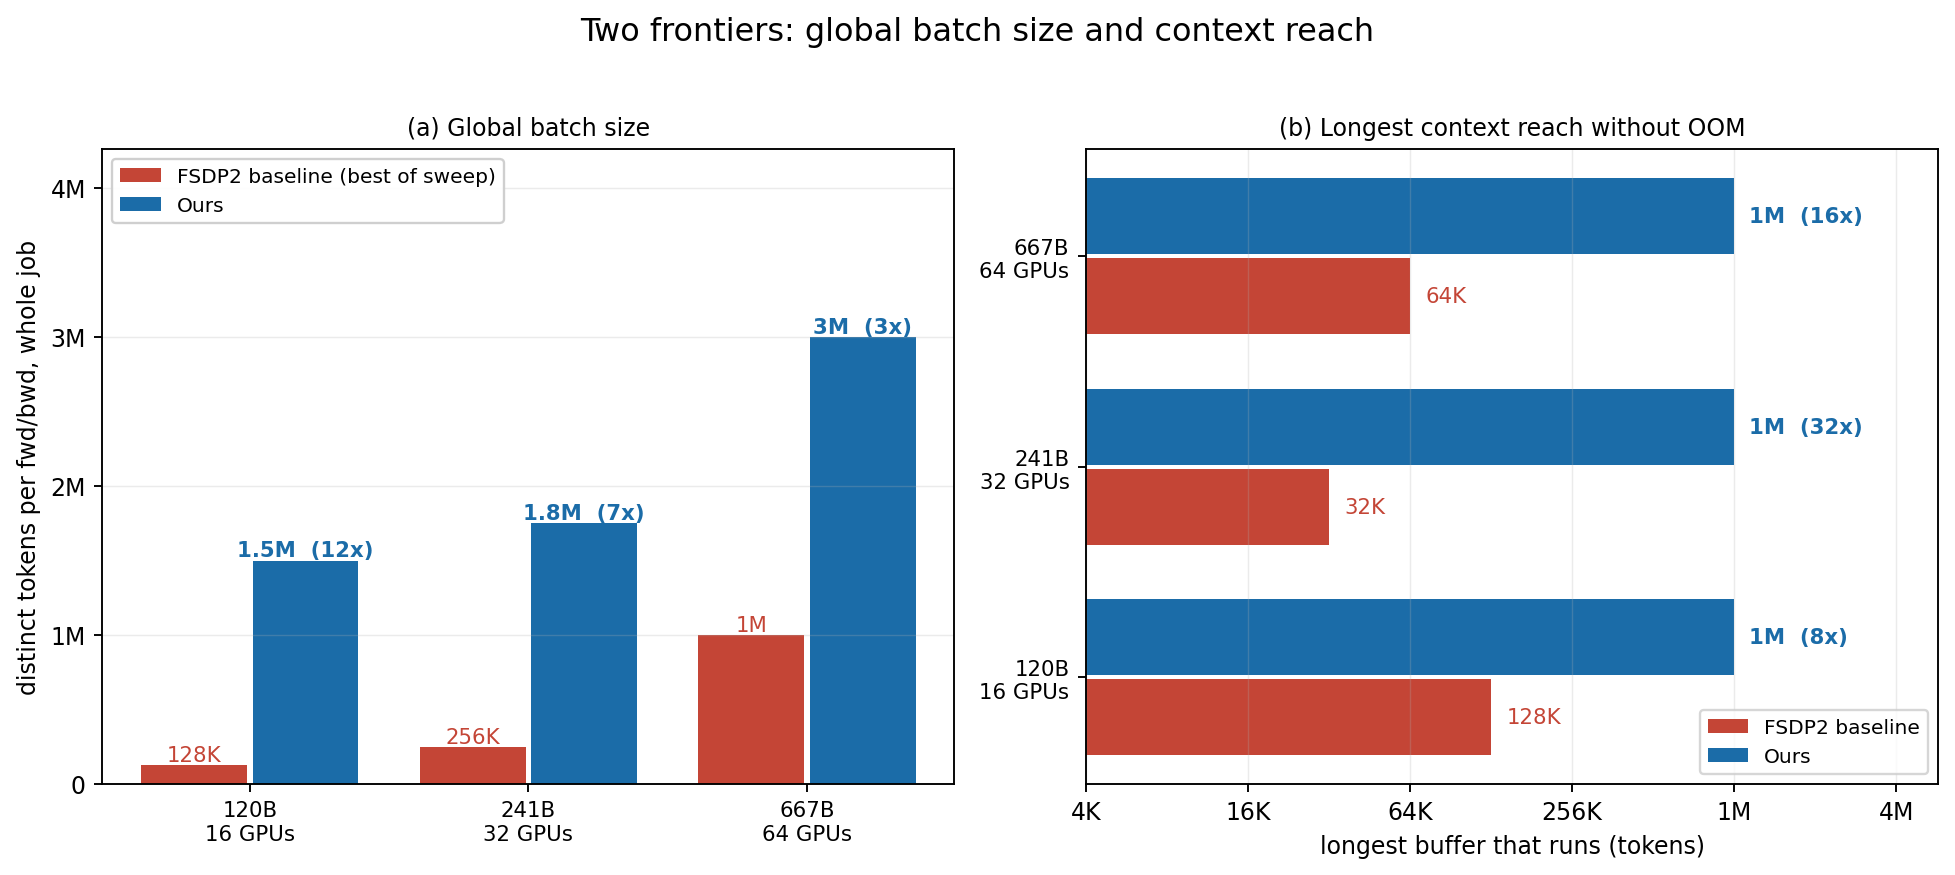
问题:在长上下文或大 batch size 下训练 Mixture-of-Experts (MoE) 模型时,只要任一组件峰值显存超过设备内存就会失败,因此目标是同时约束所有峰值而非平均占用。常用并行方案中有四处峰值不受限,且增长方式各异:expert dispatch 随 routing matrix 增长,vocabulary projection 随 tokens × vocabulary 增长,gradient checkpoint 边界随深度 × 序列长度增长,optimizer state 随参数量增长。谁先耗尽取决于模型、上下文长度与设备数,压低最大项只会暴露下一项。 方法:四项技术把峰值固定在启动时的 GPU working set: - PipelinedLLEP 在 least-loaded expert parallelism 上限制每个 source 对 dispatch chunk 的 token 贡献; - Ring-DTP 在 vocabulary projection 处以 ring 循环激活或权重分片,并把 logits block 折叠为 online log-sum-exp; - SCO(selective checkpoint offload)把每个 checkpoint 边界唯一的长生命周期张量留在 CPU 内存; - OffloadStreamAdamW 把串行 CPU Adam 更新改为 bucket pipeline。 四者仅改变计算与数据移动的顺序和粒度,loss 与梯度保持精确。 实验:组件匹配测试中,MoE dispatch 峰值最多降 59.3% 且吞吐不减,vocabulary projection 峰值降 86.6%,offloaded optimizer step 快 2.05 倍。在 120B–667B 参数 MoE 上组合使用,可训练 1M 上下文,覆盖范围为调优 FSDP2 基线的 8–32 倍,吞吐最高为基线 10.4 倍。
论文精读
TL;DR 论文提出 PipelinedLLEP、Ring-DTP、SCO、OffloadStreamAdamW 四个固定显存方案,同时消除 MoE 长上下文训练的四个内存峰值,将上下文长度扩展到 1M,吞吐最高提升 10.4 倍。
问题
问题背景
长上下文 Mixture-of-Experts (MoE) 训练是大模型扩展的关键路径,业界关注如何在高上下文长度与大批量下控制设备内存峰值,同时保持吞吐与训练精度。
现有方法局限
常见并行方案如 FSDP2 与专家并行只优化平均内存占用,未对峰值做上界约束。四个内存峰值随配置不同成为瓶颈:
- 专家分发:路由矩阵导致 dispatch 峰值随 token 数线性增长;
- 词汇投影:
tokens × vocabulary矩阵在输出层瞬间膨胀; - 梯度检查点边界:激活保存量按
depth × sequence length增长; - 优化器状态:Adam 状态内存直接由参数量决定。 任一峰值超限训练即失败;单纯降低某一峰值只会暴露下一个瓶颈,无法统一解决。
为什么难/重要
这四类峰值增长模式互不相同,且瓶颈取决于模型规模、上下文长度与设备数量,无法通过静态配置规避。需要在不改变数值结果(loss 与 gradients 精确一致)的前提下,通过调度与数据移动顺序约束 GPU 工作集上界,同时保持吞吐不降。业界对长上下文 MoE 训练需求强烈,但缺乏系统性方案同时处理所有峰值。
行业类比
类比于大规模推荐系统推理中同时优化 embedding 查表、特征交叉与输出 softmax 的峰值内存:只优化单个算子会转移瓶颈,必须全局调度所有组件。
核心洞察
- 长上下文 MoE 训练的关键不是降低平均内存占用,而是同时约束所有组件的峰值内存,因为任何一个组件超限都会导致整体失败。论文明确指出四个峰值来源(dispatch、vocab projection、checkpoint boundary、optimizer state)在不同配置下轮流成为瓶颈,仅降低其中一个只会暴露下一个。这与常见的 FSDP2 等并行方案形成对比:后者往往只针对平均或单一峰值优化,缺乏全局峰值预算视角。因此,作者提出每个算子的 GPU working set 在启动时固定,从系统设计上保证可预测性和扩展性。
- 四种技术(PipelinedLLEP、Ring-DTP、SCO、OffloadStreamAdamW)通过改变计算和数据移动的顺序与粒度,而非引入近似或量化,实现了精确的梯度与损失。这一点在系统优化中十分独特:通常为了降低内存不得不牺牲数值精度或采用有损压缩,而本文证明纯调度层面的创新即可大幅削减峰值(例如 vocab projection 峰值降低 86.6%),同时保持训练数学等价。这对于需要大规模预训练且对模型质量敏感的团队具有直接工程借鉴意义,避免在内存和精度之间做二选一。
方法
输入
长上下文 MoE 训练中,四个内存峰值未受并行计划约束:expert dispatch 的路由矩阵、vocabulary projection 的 tokens × vocab 张量、gradient checkpoint boundary 的 depth × sequence length 激活、以及 optimizer state 的参数量。任一峰值超过显存即导致训练失败,且瓶颈随模型、上下文长度、设备数动态变化。
关键模块
- PipelinedLLEP:扩展 least-loaded expert parallelism,为每个 dispatch chunk 设定源 token 数量上限,将专家派发工作集固定为启动时可预测的大小,避免路由矩阵突发膨胀。
- Ring-DTP:在词汇投影处沿环形拓扑循环激活或权重分片,将每块 logits 折叠进 online log-sum-exp,使词汇投影峰值降低且不改变最终损失。
- SCO:选择性将 checkpoint 边界唯一长寿命张量保留在 CPU 内存,其余重计算所需激活按需驻留 GPU,从而消除深度×序列长度导致的激活峰值。
- OffloadStreamAdamW:将原本串行的 CPU Adam 优化器更新重构为桶流水线,GPU 只维护有界更新缓冲,消除优化器状态在 GPU 侧的瞬时高占用。
四种方法组合后,按 per-rank 显存预算统一调度,计算与数据移动仅改变顺序和粒度,损失与梯度保持精确。
输出
在 120B 至 667B 参数 MoE 模型上实现 1M 上下文长度 训练,显存可达性是调优 FSDP2 基线的 8–32 倍,吞吐最高提升 10.4 倍。
与 FSDP2 等通用并行方案不同,本工作不依赖单纯卸载或降低平均占用,而是对每个峰值算子独立施加有界流式调度,使 GPU 工作集在启动时即固定,从而同时压平所有峰值。
实验
实验设计
论文针对长上下文 MoE 训练中四个内存峰值瓶颈,分别设计隔离基准测试验证每个调度策略的峰值削减与吞吐影响。实验覆盖 120B 到 667B 参数的 MoE 模型,在 1M 上下文长度下与调优的 FSDP2 基线对比。核心组件包括 PipelinedLLEP (有界专家分发)、Ring-DTP (词汇投影环形分块)、SCO (选择性检查点卸载) 与 OffloadStreamAdamW (优化器状态流水线)。
关键发现
- PipelinedLLEP 将 MoE 分发峰值最多降低 59.3%,且不损失吞吐 (与未受限分发相比)。
- Ring-DTP 将词汇投影峰值降低 86.6%,通过在线 log-sum-exp 保证精确梯度。
- OffloadStreamAdamW 将卸载优化器步骤加速 2.05 倍,突破串行 CPU Adam 更新瓶颈。
- 组合所有策略后,模型在 1M 上下文下可训练,上下文可达性是 FSDP2 基线的 8-32 倍,吞吐量最高提升 10.4 倍。
与基线对比解读
FSDP2 在长上下文下会因任一组件峰值超限而失败,论文方法通过固定 GPU 工作集在启动时绑定所有峰值,而不是降低平均占用。这直接解决了“降低最大峰值只会暴露下一个”的短板,让实际部署中不再需要根据模型、上下文长度、设备数动态调整并行策略。工程启示:将内存管理从平均优化转向峰值绑定,并提供有界流式算子,是长上下文训练可扩展的关键路径。
行业影响
落地场景
本方案面向 长上下文 MoE 训练,服务于企业文档分析、代码库级 Copilot、长视频理解、多轮对话记忆等产品。支持 120B–667B 参数 MoE 模型在 1M context 长度训练,解决显存峰值瓶颈。
商业价值
核心收益是降本与差异化体验。四个引入的方法将显存峰值压平,使原本无法训练的 1M 上下文配置可跑通,且与 FSDP2 baseline 相比可达 8–32x 上下文 reach、最高 10.4x throughput。这意味着更少 GPU 卡或更低配置可训练同等长上下文模型,降低训练成本;同时产品具备处理整本书、整代码库、长视频的体验升级。
与现有工作流接口
方法只改变计算与数据移动顺序和粒度,不改变模型结构与损失/梯度,可嵌入 PyTorch FSDP2 等并行训练栈。PipelinedLLEP、Ring-DTP、SCO、OffloadStreamAdamW 可作为训练框架的调度/卸载插件,按需启用,无需重写模型。
具体场景
- 电商:将商品详情、多轮客服对话、用户评价拼接成长上下文,训练 MoE 模型做意图分类或摘要。方案让会话窗口扩展至 1M token,避免 dispatch 与词表投影显存爆掉。
- 金融:长篇幅研报、招股书、合规文档生成与问答。300B+ 模型训练成为可能,峰值显存固定,减少集群规模。
局限
- 该方法需要同时引入四个自定义算子(PipelinedLLEP、Ring-DTP、SCO、OffloadStreamAdamW),每个都改变了计算和数据移动的调度。集成到现有训练框架(如 FSDP2)需要大量工程改造,且组合后的通信同步开销可能增加。对于非 MoE 或非长上下文场景,部分算子的收益可能有限,例如 Ring-DTP 在词汇表较小或序列较短时可能引入不必要的通信延迟。
- 实验主要基于 120B 到 667B 参数的 MoE 模型和特定 GPU 拓扑(论文未详细披露硬件配置),对更小模型、不同 batch size 或不同网络带宽下的适用性未充分验证。OffloadStreamAdamW 依赖 CPU 内存和主机带宽,在高性能单机多卡或 HBM 充足的环境下可能成为瓶颈;Ring-DTP 的环形通信在低带宽网络条件下可能显著拖慢训练,抵消内存节省带来的吞吐提升。
- 与已有 expert parallelism、ZeRO-Offload、activation checkpointing 等工作相比,该工作强调同时解决所有峰值,但针对的是特定并行方案(FSDP2 基线),对于使用其他并行策略(如 Megatron-LM 的张量并行)的框架可能需要重新适配。且方法关注内存峰值而非整体训练吞吐量,可能在某些配置下以牺牲一定吞吐换取内存安全,其通用性仍有待进一步验证。