StepAudio 3 Realtime 技术报告
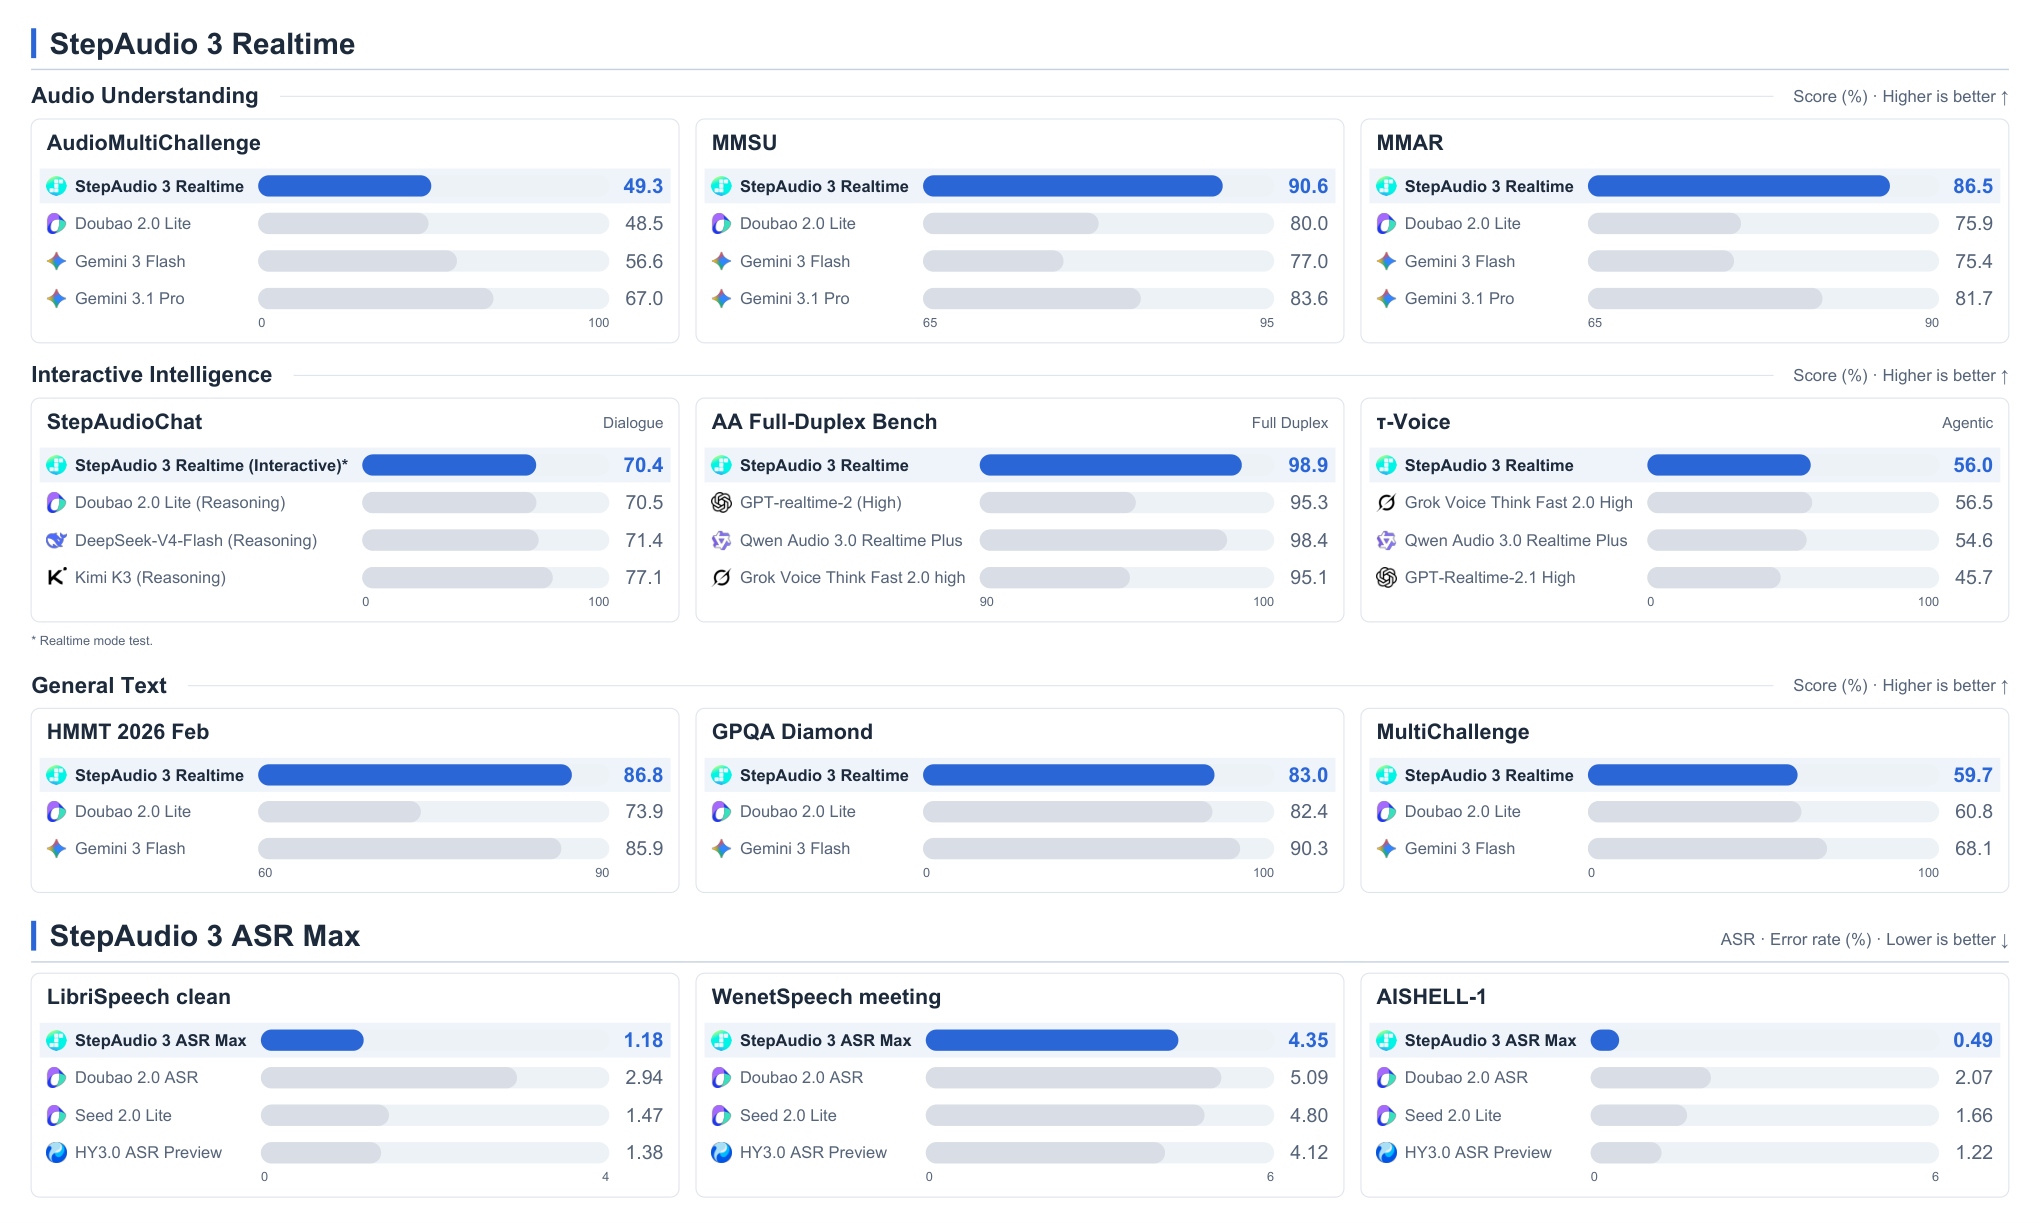
实时语音交互对深度推理、即时响应与流畅的轮次切换提出了很高要求。为此,我们提出 StepAudio 3 Realtime,一个围绕「听—说—想—做」连续闭环组织的音频语言基础模型。 模型包含两大核心能力:Deep Perception 捕捉丰富声学线索以解读用户意图; Seamless Duplex 对同步音频流建模,自然处理停顿、附和与打断。关键在于,我们通过 Think-While-Speaking 化解深度思考与低延迟之间的矛盾,让私有推理与语音输出并行执行。 在推理模式下,StepAudio 3 于 StepAudioChat 上取得 73.0 的宏平均成绩; 借助 Think-While-Speaking,它在实时说话的同时,对话与推理表现可与专门的推理模型相媲美。此外,集成的 Voice Agent 能异步执行工具调用,而不打断对话流。 StepAudio 3 Realtime 在多个关键维度上达到顶尖水平:MMSU 基准 90.6,Artificial Analysis Full-Duplex Bench 总体 98.9,并在 τ-Voice 上取得 56.0% 的宏任务成功率。
论文精读
TL;DR StepAudio 3 Realtime 通过 Think-While-Speaking 在说话同时进行私有推理,解决实时语音交互中深度思考与低延迟的矛盾,实现自然双工对话,并在 MMSU 等基准上取得顶尖成绩。
问题
问题背景
实时语音交互已从简单命令识别演进为开放域多轮对话,系统需要在深度推理、即时响应和自然轮次管理之间取得平衡,行业焦点转向能思考、会用工具且不打断对话流的语音 agent。
现有方法局限
- 级联 ASR-LLM-TTS 系统延迟叠加,并丢失韵律、副语言等声学特征;端到端语音模型虽降低延迟,但多数为单工或半双工设计,难以同时处理停顿、回馈词(backchannels)和打断。
- 现有实时对话模型在推理深度上明显弱于文本大模型:若引入长 deliberation 会加大延迟,若牺牲思考则复杂任务表现差,缺乏并行思考与说话的能力。
- 多数模型不支持异步工具执行:工具调用会中断对话流,导致“静默等待”或突兀切换,无法在等待 API 返回时继续自然对话。
困难与重要性
技术挑战:需要同时优化声学感知、流式推理、语音生成、对话地板管理、工具调用调度等多目标,且各模块延迟预算相互耦合。 业界关注度:实时语音交互正成为 AI agent 的关键载体,评估指标从 WER 扩展到任务成功率、全双工体验和 reasoning 深度。 本质困难在于推理 compute 与实时性 latency 存在根本张力——如何在不阻塞口语输出的前提下执行私有推理,是决定用户体验的核心问题。
行业类比
如同自动驾驶中“感知-规划-控制”必须在毫秒级循环内并行执行,语音 agent 也需要一个持续的 listen-converse-think-act loop,而不能像批处理系统那样等全部输入完成再响应。
核心洞察
- Think-While-Speaking 将私有推理与口语输出并行化,在实时语音交互中兼顾深度思考与低延迟。相比现有实时语音模型要么牺牲推理深度换取即时响应、要么因显式推理延迟破坏对话节奏,StepAudio 3 通过“边想边说”机制解耦推理过程与语音生成,使模型在生成音频的同时持续执行多步思考。这一设计在 StepAudioChat 上达到 73.0 macro average,接近专用推理模型水平,同时保持实时性,工程上可通过异步推理流水线与语音合成并行化实现类似效果。
- Seamless Duplex 将全双工对话中的停顿、backchannel 和打断建模为连续流状态,解决了传统半双工或端点检测方案无法优雅处理用户重叠语音的问题。该模型引入上下文感知的交互控制,能够区分自然停顿与回合结束、在用户插话时平滑切换,并通过 midtraining 与 posttraining 专门优化交互行为,最终在 Artificial Analysis Full-Duplex Bench 取得 98.9 Overall。对工程实践而言,这意味着需要将声学事件检测与对话状态机深度融合,而非简单依赖 VAD 或固定等待时间。
方法
输入音频流首先由 Deep Perception 处理:StepAudio 3 ASR Max 负责高精度语音识别,音频理解分支提取韵律、情绪等声学线索以推断用户意图。随后 Seamless Duplex 维护流式交互状态机,区分停顿、话轮结束、背景语音和插话,并通过上下文感知控制决定响应或继续聆听。
对话智能层在共享的 Conversational Context 上协调推理与语音动作。非推理模式下直接生成语音;需要深度推理时启用 Think-While-Speaking,将私有推理与语音输出并行执行,自适应思考策略决定何时激活推理,并利用 MTP 加速私有推理。多轮对话数据经因子化构造和质量评估路由,由专用教师训练后通过加权参数合并集成。
Voice Agent 负责异步工具调用:解析用户请求、触发澄清,并在工具执行期间维持自然对话。最终输出为实时语音流与工具执行结果。
与常见 ASR-LLM-TTS 级联或端到端串行推理不同,该方法在一个循环内统一深度推理、全双工交互与工具调用,并通过并行推理缓解延迟。
实验
实验设计
StepAudio 3 Realtime 围绕 listen-converse-think-act 循环,在四个维度建立评估:Deep Perception 用 MMSU 测音频理解,Seamless Duplex 用 Artificial Analysis Full-Duplex Bench 测全双工交互,Conversational Intelligence 用 StepAudioChat 测推理与对话,Voice Agent 用 τ-Voice 测异步工具调用的任务成功率。实验同时对比专用 reasoning models,重点验证 Think-While-Speaking 是否在实时口语中牺牲推理质量。
关键发现
- StepAudioChat:reasoning mode 达到 73.0 macro average;启用 Think-While-Speaking 后性能与专用 reasoning models 相当,且保持实时说话。
- MMSU:90.6,音频理解能力 top-tier。
- Full-Duplex Bench:98.9 Overall,流式双工、插话、背景语音抑制等交互管理表现优秀。
- τ-Voice:56.0% macro task-success rate,说明 Voice Agent 可在不中断对话流的情况下完成异步工具执行。
基线对比与工程启示
对比专用 reasoning models,StepAudio 3 Realtime 的关键差异在于 Think-While-Speaking:私有推理与语音输出并行,缓解深度推理与低延迟的矛盾。全双工指标 98.9 高于多数实时语音模型,但 MMSU 与 τ-Voice 的绝对分数提示:音频理解仍受长尾场景限制,agentic 任务成功率 56.0% 意味着复杂工具调用仍有较大提升空间。工程落地时需关注实际延迟、算力成本与多轮状态一致性,论文未披露 GPU 配置与推理延迟,难以直接复现或估算部署资源。
行业影响
落地场景
StepAudio 3 Realtime 可作为统一音频基础模型,直接用于实时语音客服、AI 语音助手、车载交互与企业智能会议助理。例如在电商客服场景,模型能处理用户打断、语气停顿与背景噪声,并在通话中并行进行私密推理——用户询问“这件衬衫还有 XL 码吗?帮我查一下物流”时,可在回答前半句的同时调用订单系统查询,无需等待完整话轮结束。在线教育口语陪练中,模型可识别学习者犹豫、回补式修正等副语言线索,动态调整反馈策略。
商业价值
- 降本:替代传统 ASR→LLM→TTS 级联架构,减少组件间延迟与运维复杂度,降低推理成本。
- 增收:通过更自然的打断与并行推理,减少用户对话流失率,提升电商导购与金融咨询的转化效率。
- 体验提升:Seamless Duplex 模型对背景语音拒识、回音消除的处理能力,可显著改善嘈杂环境下的交互成功率;τ-Voice 达到 56.0% 的任务成功率意味着在真实 agentic 任务中具备可用性。
与现有产品/工作流的接口
模型以流式音频输入输出暴露 API,可直接替换现有语音栈中的语音前端与对话管理模块。集成时保留现有业务 RAG、工具编排层:
- 通过 WebSocket 或 gRPC 接入多路音频流,模型输出可听语音与结构化的对话状态事件。
- Voice Agent 提供工具调用协议,可在推理间隙异步执行 CRM 查询、订单创建等 API,并通过状态回传保持对话连续性。
- 对于已有基于文本 LLM 的服务,可将 StepAudio 3 作为实时语音交互网关,仅需将最终回复文本转成语音令牌流,降低迁移成本。
局限
- - **内部基准外推风险**:StepAudioChat 是团队自建的对话推理评测集,其题目构造、难度校准与质量过滤虽有说明,但尚未经过外部社区验证。相较于广泛使用的公开推理基准,缺少系统性映射与第三方复现报告,可能导致在 StepAudioChat 上的 73.0 macro average 对真实开放域推理能力的高估。
- - **Think-While-Speaking 的一致性边界**:论文提出边思考边说话,但未充分讨论长时间生成中已发出的语音与后续私有推理结果冲突时的处理机制;MTP 加速私有推理的实测吞吐、额外显存占用以及在不同硬件上的可扩展性缺乏基线对比,限制了工程部署时的成本评估。
- - **全双工 Agent 任务成功率仍有明显缺口**:τ-Voice 宏任务成功率仅 56.0%,虽然达到 top-tier,但复杂异步工具调用、请求路由与澄清策略的失败模式未被分解;报告未提供纠错或重规划机制的实际效果,表明真实对话中 agentic task completion 仍存在较大提升空间。