跨模态 In-Context Learning 的收敛涌现
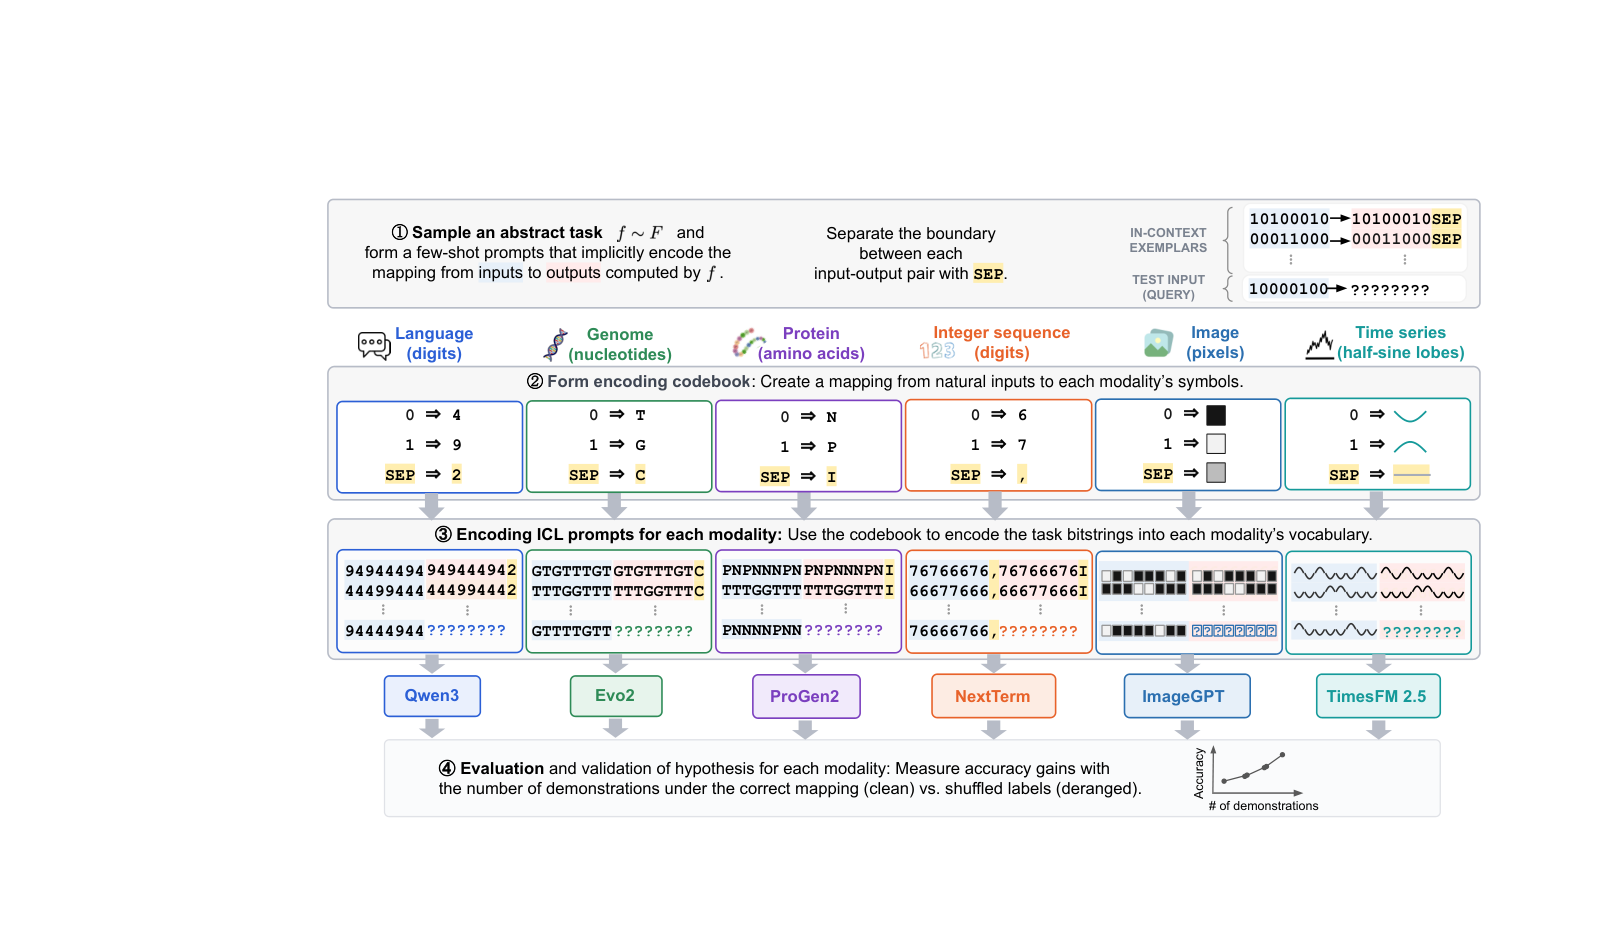
少样本 in-context learning (ICL) 指模型从 prompt 中给出的输入-输出示例推断抽象模式并应用于新输入的能力,此前主要在基于人类文本做 next-token prediction 训练的大语言模型中被广泛研究。近期,自回归基因组模型也展示出了 few-shot ICL。这引出一个问题:ICL 是否在跨领域中广泛涌现?若是,它们又共享何种共同结构? 为此,作者构建了一个受控的跨模态框架,在多种模态中实例化同一套任务,以检验其提出的 Convergent Emergence Hypothesis(收敛涌现假设),即 few-shot ICL 一旦涌现,便共享一个跨模态的难度剖面 —— 在某一模态中受益于 ICL 的任务,往往在其他模态中也同样受益。 实验结果显示,配对映射 ICL 在六种模态(语言、基因组、整数序列、时间序列、图像与蛋白质)中均有涌现,超越受控基线,并在其中五种模态上呈现出相关的逐任务效应。这些结果为 Convergent Emergence Hypothesis 提供了一定支持,但并非适用于所有模态。
论文精读
TL;DR 构建跨模态任务套件,在语言、基因组、图像等六种模态上发现少样本上下文学习(ICL)的难度分布存在跨模态一致性,支持 ICL 可能源于通用底层机制。
问题
问题背景
当前 AI 行业关注基础模型在 next-token prediction 目标下涌现的 few-shot in-context learning (ICL) 能力。该能力最初在大型语言模型(LLMs)中被广泛研究,近期在 基因组模型 中也观察到类似现象,引发对 ICL 是否具备跨模态普遍性的追问。
现有方法局限
过往研究把 ICL 视为语言模型的专属属性,评估任务通常依赖自然语言提示和文本输入输出,缺乏统一的 跨模态任务套件。这使得不同工作之间无法直接比较 ICL 增益,且难以剥离模型规模、数据分布、tokenization 等因素的影响。已有跨模态探索往往只关注单一新模态(如基因组),没有在多个模态中实例化相同任务并测量每任务效应相关性,因此无法验证 收敛涌现假说。
为什么这个问题难/重要
难点在于不同模态的数据表示和序列化方式差异巨大——例如图像像素、基因序列、时间序列——如何定义“相同任务”并公平量化 ICL 增益本身就是一个设计挑战。重要性体现在:如果 ICL 在跨模态中共享难度分布,说明 next-token prediction 本身可能诱导通用的上下文学习机制,而非语言特有的归纳偏置。这对多模态基础模型的设计、预训练目标选择、以及从文本到其他模态的 prompt 策略迁移有直接指导意义,也触及模型泛化能力的根本理解。
行业类比
这类似于多语言迁移学习中,在高资源语言上验证有效的 prompt 设计或任务难度评估可以迁移到低资源语言:若 ICL 跨模态难度分布一致,在一个模态上调试出的 任务原语 或评估方法可低成本复用到其他模态,减少多模态产品研发中的重复实验。
核心洞察
- “收敛涌现假设”提出跨模态少样本 ICL 的困难度应具有一致性,为检验 ICL 是否由通用机制驱动提供了新框架。以往 ICL 研究集中于语言模型或单模态,缺乏统一任务套件的跨模态对照,不同模态间难以直接比较。该工作将同一任务套件实例化到六种模态,并发现配对映射 ICL 显著超越受控基线,且五个模态的任务效应呈正相关,表明底层模式归纳能力可能共享部分结构。这一角度跳出了单一模态的观察,转向跨模态验证,对理解 ICL 的本质和设计通用序列模型具有直接启示。
- 跨模态相关中出现的例外(未在所有模态中相关)表明 ICL 并非完全由统一机制支配,存在模态特异因素。该发现区别于简单假设“模型规模足够大即可涌现通用 ICL”的乐观预期,提示序列数据的统计结构、tokenization 方式或预训练目标可能影响 ICL 的迁移性。对于工程实践,这意味着在构建跨模态基础模型时,不能假定 ICL 能力可自动泛化,需要针对特定模态进行验证或调整训练策略。同时,这种部分相关性也为研究 ICL 涌现条件提供了更细粒度的实验证据。
方法
跨模态 ICL 评估框架
输入:统一的任务原语集,包含多种抽象函数类型(如配对映射、序列变换、算术关系)。每个任务在六个模态(语言、基因组、整数序列、时间序列、图像、蛋白质)中被实例化为对应的输入-输出示例对,形成少样本提示。
关键模块:
- 任务实例化:将抽象函数表示在目标模态的符号空间中,例如语言用 token 序列,图像用 patch 序列,基因组用碱基序列。每种模态选用一个自回归预训练模型作为 ICL 载体。
- 少样本 ICL 评估:对每个任务构造 k-shot 上下文(k 个示例加一个新输入),让模型自回归生成输出。计算任务成功率或精确匹配指标。
- 控制基线:设计非 ICL 基线(如 zero-shot、随机预测、基于局部统计的启发式),隔离 ICL 增益。比较有/无示例时的性能差,得到每任务的 ICL 收益。
- 跨模态相关性分析:对同一任务在不同模态下的 ICL 收益向量,计算模态间相关系数(如 Pearson 或 Spearman),检验收敛涌现假设。
输出:跨模态任务难度画像,指示哪些任务在多个模态中一致受益于 ICL;并识别配对映射等任务族的涌现证据。
与以往单模态 ICL 研究不同,该框架通过严格控制任务原语与评估协议,首次实现六个模态间 ICL 行为的直接可比,从而验证收敛涌现假设。
实验
实验设计
- 跨模态框架:同一任务套件实例化于六种模态:语言、基因组序列、整数序列、时间序列、图像、蛋白质。
- 任务类型:重点考察 paired-mapping ICL(成对映射任务的上下文学习)。
- 对照基线:设置受控基线以排除简单统计匹配等混淆因素。
- 评估协议:测量各任务在 ICL 条件下相对基线的性能提升,并计算跨模态任务难度相关性。
关键发现
- ICL 跨模态涌现:六种模态中均观察到 paired-mapping ICL,且表现优于受控基线。
- 跨模态难度相关:五对模态之间存在显著的任务难度相关性,支持 Convergent Emergence Hypothesis 在部分模态成立。
- 并非全部模态一致:至少一个模态(可能为蛋白质或图像)未表现出与其它模态的相关性,提示 ICL 涌现受模态特定因素影响。
与基线对比解读
- 论文的受控基线排除了“仅依赖上下文表面统计线索”的可能,ICL 显著超越基线说明模型进行了抽象模式推理。
- 与以往仅在 LLM 中研究 ICL 的工作不同,本工作将 ICL 扩展到非文本模态,并引入统一任务套件进行系统比较,方法论上具有创新性。
- 跨模态相关性提示存在通用序列学习机制,但模态差异(离散符号 vs 连续信号、数据结构先验)可能导致 ICL 表现分化,为多模态预训练和统一基础模型设计提供线索。
行业影响
落地场景
跨模态 ICL 的收敛性表明,统一的多模态基础模型可以在文本、图像、时间序列、基因组、蛋白质等数据类型上,用少样本提示 快速适配新任务,无需针对每个模态分别微调。典型应用包括:
- 电商平台:用少量示例让模型从商品图片+描述中抽取新属性(如风格、材质),或学习新的分类规则。
- 内容平台:多模态内容安全审核中,通过少量违规样例快速更新审核策略。
- 生物医药:基于蛋白质或基因组序列的少样本功能预测,加速靶点发现或变异影响分析。
商业价值
主要降本增效:减少为每个垂直任务训练专用模型的计算和标注成本;新任务上线时间从数天缩短到分钟级(仅需设计 prompt 示例);统一模型架构降低运维复杂度。在长尾、低资源场景中,少样本 ICL 可能成为唯一可行方案,提升产品覆盖面。
接口与工作流集成
可作为模型推理服务(如 LLM API 或自建 serving)的一个少样本适配层,接收用户提供的输入输出示例,动态生成任务推理。集成进现有 MLOps 流程时,可在推理网关中增加 few-shot adapter,与 RAG 检索到的示例结合,调用底层多模态编码器。例如:
- 电商平台在商品上架流水线中,调用 ICL 接口批量抽取新属性,将示例模板存于配置中心,非技术运营人员即可更新规则。
- 生物信息平台将 ICL 嵌入序列分析工具,用户上传少量标注序列即可获得新预测模型。
收敛涌现意味着跨模态共享难度分布,这为设计通用少样本服务提供了理论依据,但需注意并非所有模态都表现一致(论文中个别模态未达标),落地时应按模态验证。
局限
- - 论文自身承认跨模态一致性并不全面:摘要明确指出结果仅“在部分模态中”支持 **Convergent Emergence Hypothesis**,并非所有六种模态均显现一致的难度分布。这意味着所提出的假设并非普适规律,而是依赖模态属性和任务特征,后续需要进一步剖析哪些因素(如数据分布、序列自相似性、离散性)驱动或抑制了 ICL 的跨模态对齐。
- - 方法层面,受控任务套件局限于 **paired-mapping** 任务族,这只能覆盖 ICL 能力的一小部分,无法外推到更复杂的推理、组合泛化或需要工作记忆的任务。受控框架的人为构造也可能偏离真实世界数据流形,因而观察到的 ICL 效应可能被高估或扭曲,限制了结论向自然数据(如开放域文本、未结构化的多模态输入)的迁移。
- - 实验中的模型规模与训练数据量未与 ICL 涌现阈值进行系统关联分析。论文未探讨模型参数、训练 token 数、上下文长度等因素对跨模态 ICL 涌现的定性影响,也未与更大规模基线的表现进行对比。若模型规模接近 ICL 涌现临界点,所测相关可能不稳定,导致对“收敛涌现”的解释存在混淆变量。