HuRo: 将人类视频机器人化以实现可扩展的 VLA 预训练
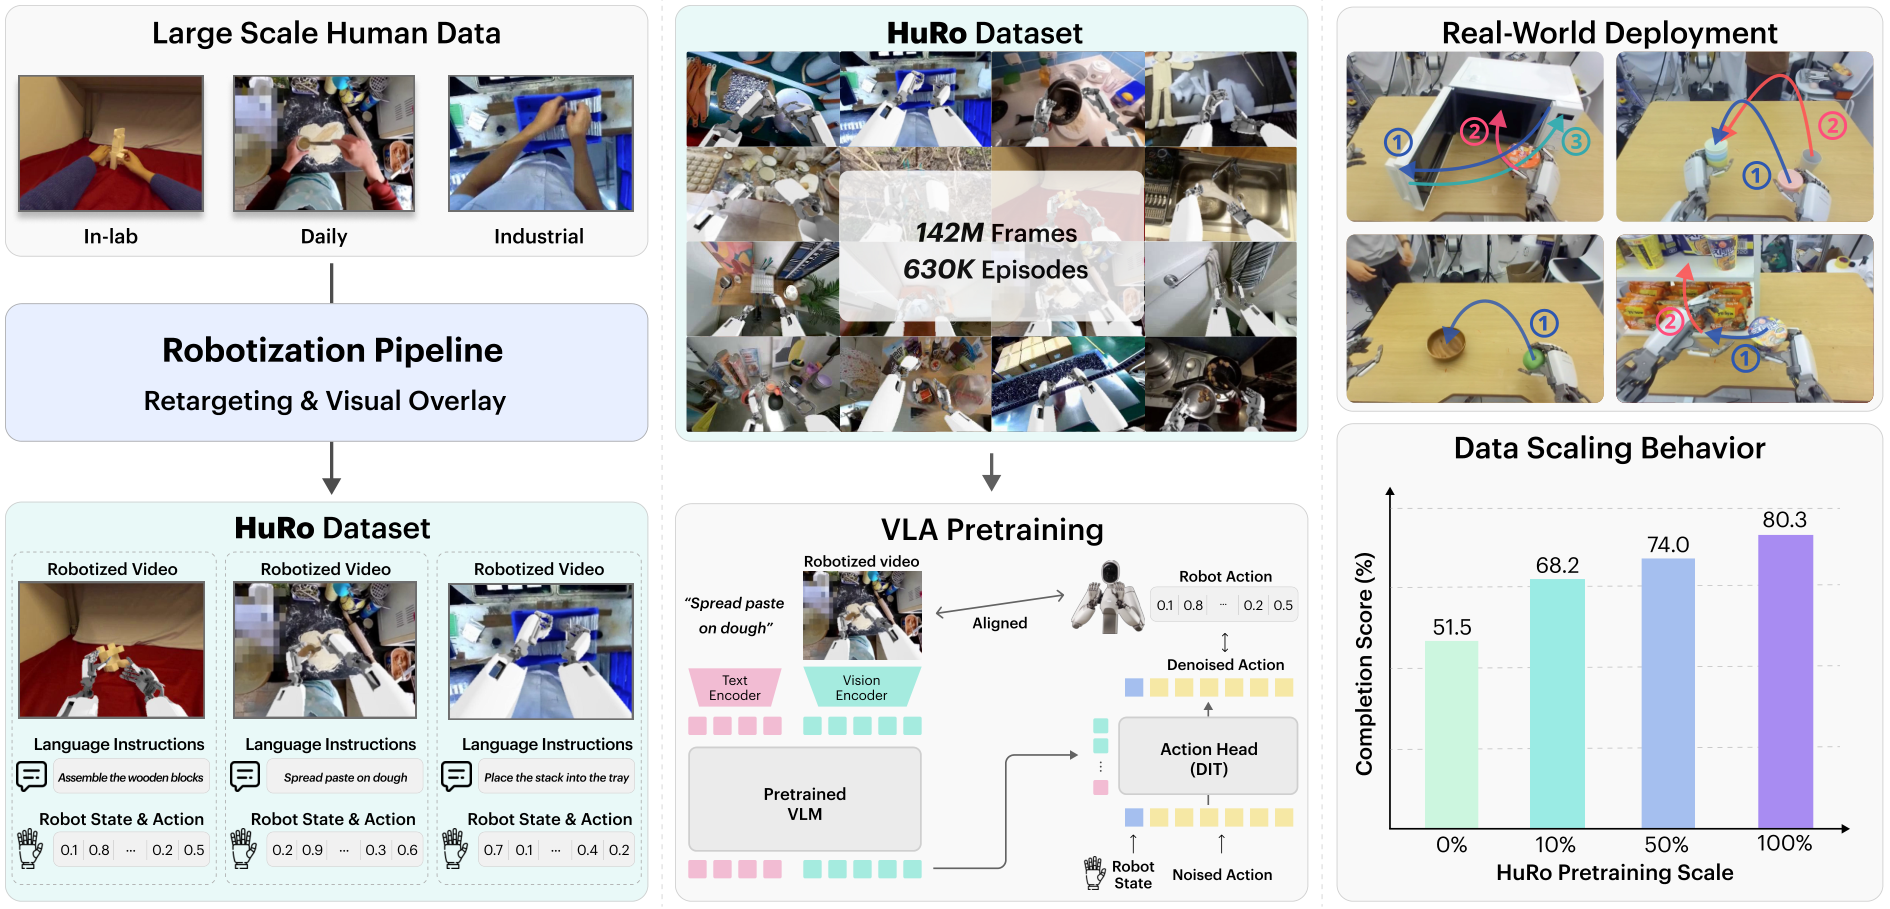
人类视频数据集提供了丰富多样的交互数据,可作为昂贵真机数据的补充。为弥合人-机器人具身鸿沟,现有方法要么在任务匹配的设定下对视频进行机器人化,要么在大规模上分别处理观测与动作对齐。本文系统性地考察了机器人化的人类视频能否作为 VLA 预训练 中有效且可扩展的监督来源。 为此,我们开发了一套机器人化流水线,将异构人类视频转化为机器人对齐的观测与动作轨迹,并在不同标注层级上推断缺失的中间信号。基于该流水线,我们构建了 HuRo 数据集,包含来自五个人类视频来源的约 630K 机器人化 episode 与 142M 处理帧。 在四个真实世界操作任务上,增加机器人化预训练数据量使整体完成率从 51.5% 提升至 80.3%,空间与视觉偏移下的 OOD 完成率 从 34.9% 提升至 72.2%。消融实验进一步表明: - 视觉机器人化可提升 OOD 鲁棒性; - 采用重定向动作的端到端预训练优于仅视觉层面的迁移。
论文精读
TL;DR HuRo 将大规模人类视频机器人化为 VLA 预训练数据,构建 630K 机器人化片段,让操作完成率从 51.5% 提升至 80.3%,并显著增强 OOD 鲁棒性。
问题
问题背景
机器人操作策略预训练(VLA pretraining)严重依赖昂贵的真实机器人采集数据,而人类视频数据量大、交互多样,是潜在的低成本补充来源。
现有方法局限
早期方法只在任务匹配环境中进行视频 robotization,需要针对每个任务定制视觉转换与动作映射,难以扩展到大规模异构数据;后续工作将视觉对齐(robot-like 渲染)与动作对齐(retargeting)拆成独立阶段,缺乏端到端联合优化,导致训练监督信号割裂。此外,多数 pipeline 未能从人类视频中同时推断相机内参、手部 6D 姿态、相机轨迹等中间信号,造成观察与动作时间不一致,影响策略学习。
为什么难/重要
人类手部到机器人末端执行器的映射是欠约束问题,需要同时处理外观差异(人手 vs. 夹爪)与运动学结构差异;从嘈杂互联网视频中估计精确相机轨迹、手部姿态并生成连续 action trajectory,要求鲁棒且可扩展的自动化 pipeline。数据规模和质量直接影响 VLA 的泛化能力,因此系统验证 robotized human videos 能否作为可扩展的预训练监督来源具有核心工程价值。
行业类比
类似于用海量网络图像预训练视觉模型再下游微调,但机器人策略要求动作监督与物理一致性,不能仅靠视觉相似度迁移。
核心洞察
- **联合观察-行动机器人化** 是 HuRo 区别于先前工作的核心思路。现有方法要么在任务匹配的小规模场景中做视觉迁移,要么分别处理观察对齐和动作重定向,难以规模化。HuRo 构建了端到端流水线,将人类视频转换为机器人视角的观测和可执行动作轨迹,同时推断缺失的中间信号,最终在 630K episodes 上预训练 VLA,使 4 个真实操作任务的完成率从 51.5% 提升到 80.3%,OOD 完成率从 34.9% 提升到 72.2%,证明规模化机器人化人类视频可作为有效的 VLA 预训练监督信号。
- **视觉机器人化** 对 OOD 鲁棒性的贡献独立于行动重定向。消融显示,仅进行视觉对齐(去除人手、叠加机器人外观)就能提升空间和视觉偏移下的任务成功率,而端到端联合训练优于视觉迁移。这表明人-机器人 embodiment gap 不仅在于动作空间映射,还在于观测分布差异;预训练阶段应直接模拟目标机器人的视觉输入,这与仅做行动重定向或后处理域适应的方法形成关键差异,为设计低成本、大规模 VLA 数据管道提供了明确指引。
方法
输入与整体框架
HuRo 以异构人类视频为输入,通过机器人化流水线转换为机器人对齐的观测和动作轨迹,用于 VLA 预训练。
关键模块
- 人类视频注释:估计相机内参、手部跟踪与姿态、相机轨迹,并用 VLM 生成分块字幕,补齐缺失中间信号。
- 动作转换:将人类手部动作重定向为机器人末端执行器动作,生成动作轨迹。
- 视觉转换:移除人类手臂并叠加机器人模型,产生机器人视角的观测图像。
- 数据集构建:整合以上步骤得到 HuRo 数据集,约 630K episodes、142M frames。
- VLA 策略训练:采用端到端预训练,策略架构与动作表示针对机器人操作设计,同时利用视觉和动作监督。
与同类方法的差异
现有工作要么仅在任务匹配场景下机器人化视频,要么分离处理观测对齐和动作对齐;HuRo 则联合优化观测与动作对齐,并在大规模异构数据上推断缺失的中间信号,实现可扩展的预训练。
实验
实验设计
在四种真实世界操作任务(Apple Pick-and-Place、Cup Stacking、Cup-Noodle Handover、Microwave Loading)上,用不同规模的 HuRo 机器人化视频预训练数据训练 VLA 策略。数据规模从少量逐步增加至约 630K episodes。评估指标包括 总体完成率 和 OOD 完成率(空间与视觉偏移)。消融实验对比视觉机器人化 vs 无视觉机器人化、端到端(视觉+动作 retargeting)vs 仅视觉迁移。
关键发现
- 增加机器人化预训练数据显著提升性能:总体完成率从 51.5% 提升至 80.3%;OOD 完成率从 34.9% 提升至 72.2%。
- 视觉机器人化主要贡献于 OOD 鲁棒性;端到端预训练结合 retargeted actions 优于仅视觉迁移。
与基线对比
现有方法要么在 task-matched 设置下机器人化视频,要么分别处理观察与动作对齐,缺乏大规模联合机器人化。本文系统性地在异构数据上联合进行观察-动作机器人化,证明了其作为可扩展监督来源的有效性。数据规模收益表明,机器人化人类视频可有效补充昂贵真实机器人数据,缓解数据稀缺;视觉域对齐是泛化关键,而动作监督进一步优化策略。
行业影响
落地场景
HuRo 通过将大规模人类视频转换为机器人可用的观察-动作对,直接赋能通用机器人操作策略的预训练。主要落地场景包括:
- 家庭服务机器人:利用互联网上海量的人类手部操作视频(如烹饪、整理、维修),预训练出具备常识操作能力的 VLA 策略,加速面向厨房、客厅等复杂场景的部署。
- 仓库与物流拣选:将人类搬运、分拣视频机器人化,预训练出适应不同物体形状、摆放位姿的抓取策略,减少对真实机器人数据采集的依赖。
- 人机协作场景:可用于服务机器人在人类环境中理解并模仿人类操作意图,提升交互自然度。
商业价值
- 降低数据采集成本:真实机器人遥操作数据成本高、扩展慢;HuRo 提供了一条“从互联网视频中挖掘机器人监督信号”的路径,有望将数据成本降低一个数量级,缩短产品迭代周期。
- 提升策略泛化能力:论文显示增加机器人化预训练数据可将任务完成率从 51.5% 提升到 80.3%,且 OOD 完成率从 34.9% 提升到 72.2%,这直接减少机器人部署后的失败率和人工干预需求,改善用户体验。
- 解锁长尾场景:人类视频覆盖大量真实世界长尾交互,可以补足机器人采集数据的分布偏置,提升模型在极端视觉/空间变化下的鲁棒性。
与现有产品/工作流的接口
HuRo 的产物是一个大规模机器人化预训练数据集 + 对应 VLA 预训练策略,可以集成进现有机器人学习栈:
- 对于采用 OpenVLA / Octo / RT 系列等开源 VLA 模型的公司,可以直接将 HuRo 数据集作为额外的预训练语料,在自有任务上微调,无需修改模型架构。
- 对于拥有真实机器人采集平台的团队,可以将 HuRo 的视觉机器人化模块(
human removal + robot overlay)和动作重定向模块作为数据增强工具,将已有的少量人类演示视频转换为机器人可用的训练样本。 - 提供项目页和 GitHub 仓库,方便集成:项目主页 。GitHub 。
具体用例:某电商仓储机器人公司希望训练一个通用抓取策略。他们可以使用 HuRo 数据集预训练,然后仅用少量真实仓库数据微调,从而在几周内获得适应新 SKU 的抓取模型;某内容平台的视频理解团队可以复用 HuRo 的视觉机器人化管线,从用户上传的手工制作视频中提取操作知识,辅助探索机器人内容生成场景。
局限
- 动作重定向保真度有限:HuRo 的 pipeline 依赖 HaMeR 等模型估计手部姿态并映射到机器人动作,但缺少接触力、触觉等中间信号,导致精细操作(如抓取易变形物体)的重定向精度不足。与真实机器人数据相比,自动转换的动作轨迹可能包含噪声和系统性偏差,预训练策略在真实机器人上微调时可能需额外修正,限制了 zero-shot 迁移潜力。
- 视觉机器人化引入分布偏移:将人类从视频中移除并叠加机器人模型,虽提升了 OOD 鲁棒性(消融显示),但合成画面可能与真实机器人相机观测存在明显差异(如光照、纹理、机器人运动学外观),部署时仍需大量域适应。且该方法依赖特定机器人 embodiment(如使用的夹爪型号),跨不同机器人平台迁移需重新 robotize,扩展成本高。
- 数据源多样性与 pipeline 误差传播:HuRo 基于五个公开人类视频源构建,内容以厨房、手部操作为主,场景和任务类型有限,难以覆盖工业、户外等广泛机器人应用。同时,标注 pipeline 包含多个级联模型(手检测、姿态估计、相机轨迹估计、VLM 标注),每个环节的误差会累积到最终数据集,但论文未量化各环节误差对下游策略性能的影响,数据集质量保证不足。