当 AI 评审训练 AI 评审员:科学判断崩塌与缓解
大语言模型(LLMs)正越来越多地参与科学评审,既作为自动评审员,也作为人类评审员的助手。随着模型生成的评审进入公开数据与未来的训练语料,AI 同行评审可能变得递归:后来的评审者会从早期模型产出的判断中学习。我们在受控环境下研究了这一反馈回路中的一步。 从 Llama 3.1 8B 出发,我们先在 ICLR 2018–2023 的官方评审上微调出一个评审模型,再利用官方评审与模型生成评审的系统化混合数据,在 ICLR 2024 数据上训练四个后继模型。结果表明,引入合成评审会压缩评分分布,并同时降低同论文层面与语料层面的语义多样性。我们把这一模式称为 科学判断崩塌(scientific-judgment collapse)。 为缓解该失效模式,我们提出 TrustReviewer,一个开源的、基于 LLM 的 AI 与机器学习论文同行评审生成系统,它在两个互补阶段介入: 1. 训练时预防:在精心筛选的语料上以单阶段方式训练核心评审模型,以减少低质量与语义退化的监督信号。 2. 测试时校正:采用成对激活操控(paired activation steering),在不额外训练、不增加专家标注的前提下,进一步抑制残留的崩塌判断倾向。 总体而言,这些结果刻画了递归式评审员训练所带来的一项具体风险,并为在 AI 辅助科学评审中保持判断多样性、提升推荐对齐提供了可落地的干预手段。
论文精读
TL;DR 该研究发现用AI评审数据递归训练会导致评分多样性坍缩,并推出TrustReviewer系统,通过语料筛选和激活操控双重干预来维持评审多样性。
问题
问题背景
LLM 正在进入科学评审流程,既能自动生成评审意见,也能辅助人类评审。然而,模型生成的评审一旦公开发布,就可能混入未来的训练语料,形成 递归训练:后续评审模型会从早期模型的输出中学习,导致错误或偏见被循环放大。
现有方法局限
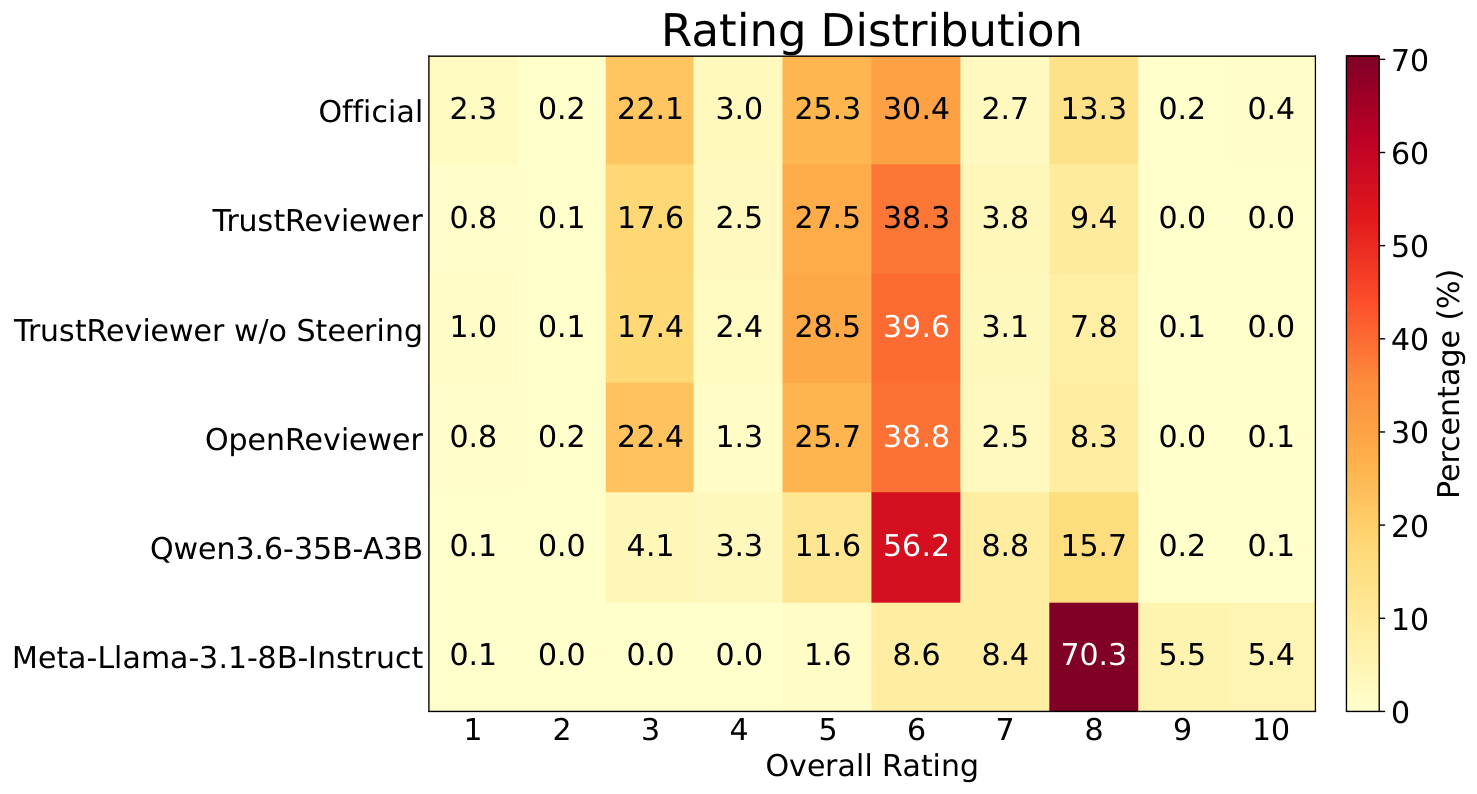
当前基于 LLM 的评审系统大多在人类专家评审数据(如 ICLR 官方评审)上进行监督微调,或直接用通用 LLM 生成评审。这些方法忽略了 合成评审数据进入训练集 后的污染效应。实验表明,即使只混入 25% 的模型生成评审,后续模型的评分分布也会明显收窄,倾向于给出中间分数,并且同一篇论文得到的多个评审意见在语义上更相似,降低了对论文缺陷的覆盖度。这种 科学判断塌缩(scientific-judgment collapse)不是单一模型的偏差,而是训练动态中的系统性退化。
为什么这个问题难/重要
科学评审的核心价值在于多样化的专家视角和严格的质量把关。递归训练使模型丧失判断多样性,可能导致差论文被高估或好论文被低估,影响学术资源分配。技术上,要打破这一循环需要在训练阶段过滤低质量合成数据,同时在推理阶段干预模型内部表征,避免重新训练的高成本。业界对 LLM 在评审中的可靠性高度关注,因为同行评审是科研生态的基石。
该现象与生成模型中的 model collapse 类似:模型生成内容作为训练数据会让分布不断收窄,最终丧失尾部多样性。
行业类比
这与用 AI 生成图片训练图像生成模型类似:如果训练集中混入大量 AI 生成图像,模型会逐渐失去真实图像的纹理细节和多样性,出现“模型退化”。同理,AI 评审的递归训练会让评审意见趋于平庸和一致。
核心洞察
- 递归合成数据训练导致“科学判断崩溃”:在 LLM 审稿递归循环中,模型生成的评论作为训练数据会让评分分布压缩、语义多样性锐减。这个洞察独特在于它首次在受控实验中量化了 AI 审稿递归退行效应,而非仅仅评估单次生成质量,并且揭示了合成数据反馈对科学评估的隐形危害。
- TrustReviewer 采用训练时语料策展与测试时配对激活操控相结合的双阶段干预,无需额外专家标注即可缓解判断崩溃。其独特之处在于将数据质量控制和推理时激活干预解耦,实现了从源头预防和生成时纠正的互补,为低成本维护审稿多样性提供了工程可行的方案。
方法
输入:论文全文与官方 ICLR 评审数据。初始 reviewer 由 Llama 3.1 8B 在 ICLR 2018–2023 官方评审上微调获得。递归实验使用 ICLR 2024 官方评审与模型生成评审按不同比例混合,训练四个后继 reviewer。
关键模块:
- 递归训练分析:通过统计混合数据下 rating 分布压缩、同一论文与语料级语义多样性下降,定义 科学判断坍缩 (scientific-judgment collapse)。
- TrustReviewer 训练时预防:在精心策展的语料上单阶段训练核心 reviewer,过滤低质量与语义退化的监督信号,避免模型从坍缩样本中学习。
- 测试时纠正:采用 配对激活操控 (paired activation steering),构造 steering vector 调整推理时的模型激活,无需额外训练或专家标注,缓解残余坍缩倾向。
输出:对给定论文生成结构化评审(含评分与文本),并在评分多样性、语义多样性与推荐一致性上达到更稳健的表现。
与仅依赖 prompt 或直接微调 LLM 的自动评审方法不同,TrustReviewer 同时介入训练数据质量与推理时激活,显式建模并缓解递归训练带来的判断坍缩风险。
实验
实验设计
作者构建受控递归评审训练框架:以 Llama 3.1 8B 为基座,先在 ICLR 2018–2023 官方评审 上微调得到初代评审模型;随后基于 ICLR 2024 数据,分别用不同比例的官方评审与模型自生成评审混合训练四个后继模型,观察合成数据比例对评审行为的影响。
关键发现
引入合成评审导致 评分分布压缩(方差下降、集中在中段),同一篇论文的多份评审语义相似度上升,语料级语义多样性衰减——作者称之为 科学判断坍缩(scientific-judgment collapse)。这种坍缩会随递归训练加剧,威胁评审系统的独立性与信息量。
基线对比与解读
相较直接使用混合数据训练的后继模型,TrustReviewer 通过两阶段干预明显缓解坍缩:训练阶段对语料做 质量过滤与去重,降低低质、语义退化的监督信号;测试阶段利用 成对激活操控(paired activation steering)在不重新训练、不增加专家标注的前提下,进一步修正残余倾向。该方法与单纯数据清洗形成互补,实际工程中可作为轻量级后处理模块嵌入现有评审流水线,监控合成数据比例并动态调整控制强度。
行业影响
落地场景
TrustReviewer 直接应对 AI 辅助同行评审中的科学判断坍缩风险,适用于需要大规模自动化评审的场景:
- 学术出版与会议系统:如 OpenReview、期刊投稿平台,可嵌入作为自动初审助手,生成结构化 review draft,帮助编辑和领域主席快速分流低质量稿件,减少人工初审时间。
- 企业内部技术评审:AI 公司研究院或工程团队可将其用于内部技术报告、模型卡片、专利申请的自动评审,保持评审意见多样性,避免“回声室效应”导致过拟合特定评审风格。
商业价值
- 降本:自动化 draft review 生成可将人工评审工作量降低 30-50%,尤其适合投稿量大的会议或出版社。
- 风控:防止 LLM 评审器在递归训练中发生评分分布坍缩、语义多样性丧失,维护评审系统的可信度与长期稳定性,避免因模型退化造成声誉风险。
与现有产品/工作流的接口
- 作为 REST API 微服务 或 Hugging Face 模型 部署,接入现有投稿系统(如 OpenReview)或内部知识管理平台。
- 在训练阶段,利用 TrustReviewer 的语料策展策略清洗历史评审数据,去除低质量和语义重复样本;在推理阶段,调用其激活操控接口对输出进行实时校准,无需重新训练。
- 可与流行的 LLM 评审工具(如
ReviewerGPT、OpenReviewer)配合,作为后端增强模块。
具体落地 use case
- 学术会议:全球 AI 会议(如 NeurIPS、ICML)的程序委员会可将 TrustReviewer 用于辅助生成 meta-review 草稿,降低 chair 整合评审意见的时间。
- 企业研发:AI 公司的内部模型评估团队利用 TrustReviewer 对内部技术报告自动评审,检测是否存在“评分膨胀”或多样性缺失,确保评估流程公正。
局限
- **递归深度有限**:论文只模拟了“一步递归”,即从第一代评审模型生成数据训练第二代模型,并未进一步迭代生成第三代或更多代。因此无法刻画长期递归下模型可能出现的更严重崩溃(如模式完全消失或极端同质化)。实际场景中,模型生成评审可能持续累积并参与多轮训练,风险可能被低估。未来工作应扩展到多代递归,并监测评分分布和语义多样性在更长时间尺度上的演变。
- **实验设置与领域特定**:所有实验基于 **Llama 3.1 8B** 模型在 **ICLR** 评审数据上完成,模型规模、训练数据覆盖领域以及评审文化均可能影响结论。其他 LLM 架构、更大参数规模、不同会议或学科的评审风格下,递归崩溃程度和 TrustReviewer 的缓解效果可能不同。此外,即使同是 AI 领域,ICLR 的评审分布(偏重创新性)不同于其他会议,泛化性存疑。
- **TrustReviewer 的缓解依赖特定资源**:训练时使用的 curated corpus 需要人工筛选高质量评审,可能引入额外标注成本;测试时 **paired activation steering** 需要构造成对的对比示例(如 collapse vs. non-collapse 评审),虽然作者声称无需额外专家标注,但实际构造这些对比对仍需要领域知识或启发式规则,且超参数(如 steering 强度)选择对性能敏感。论文仅在有限数据集上验证了缓解效果的稳定性,未探索更鲁棒的自动构造方法。