面向干细胞显微成像的 Cellpose-SAM 保留下限约束训练后量化
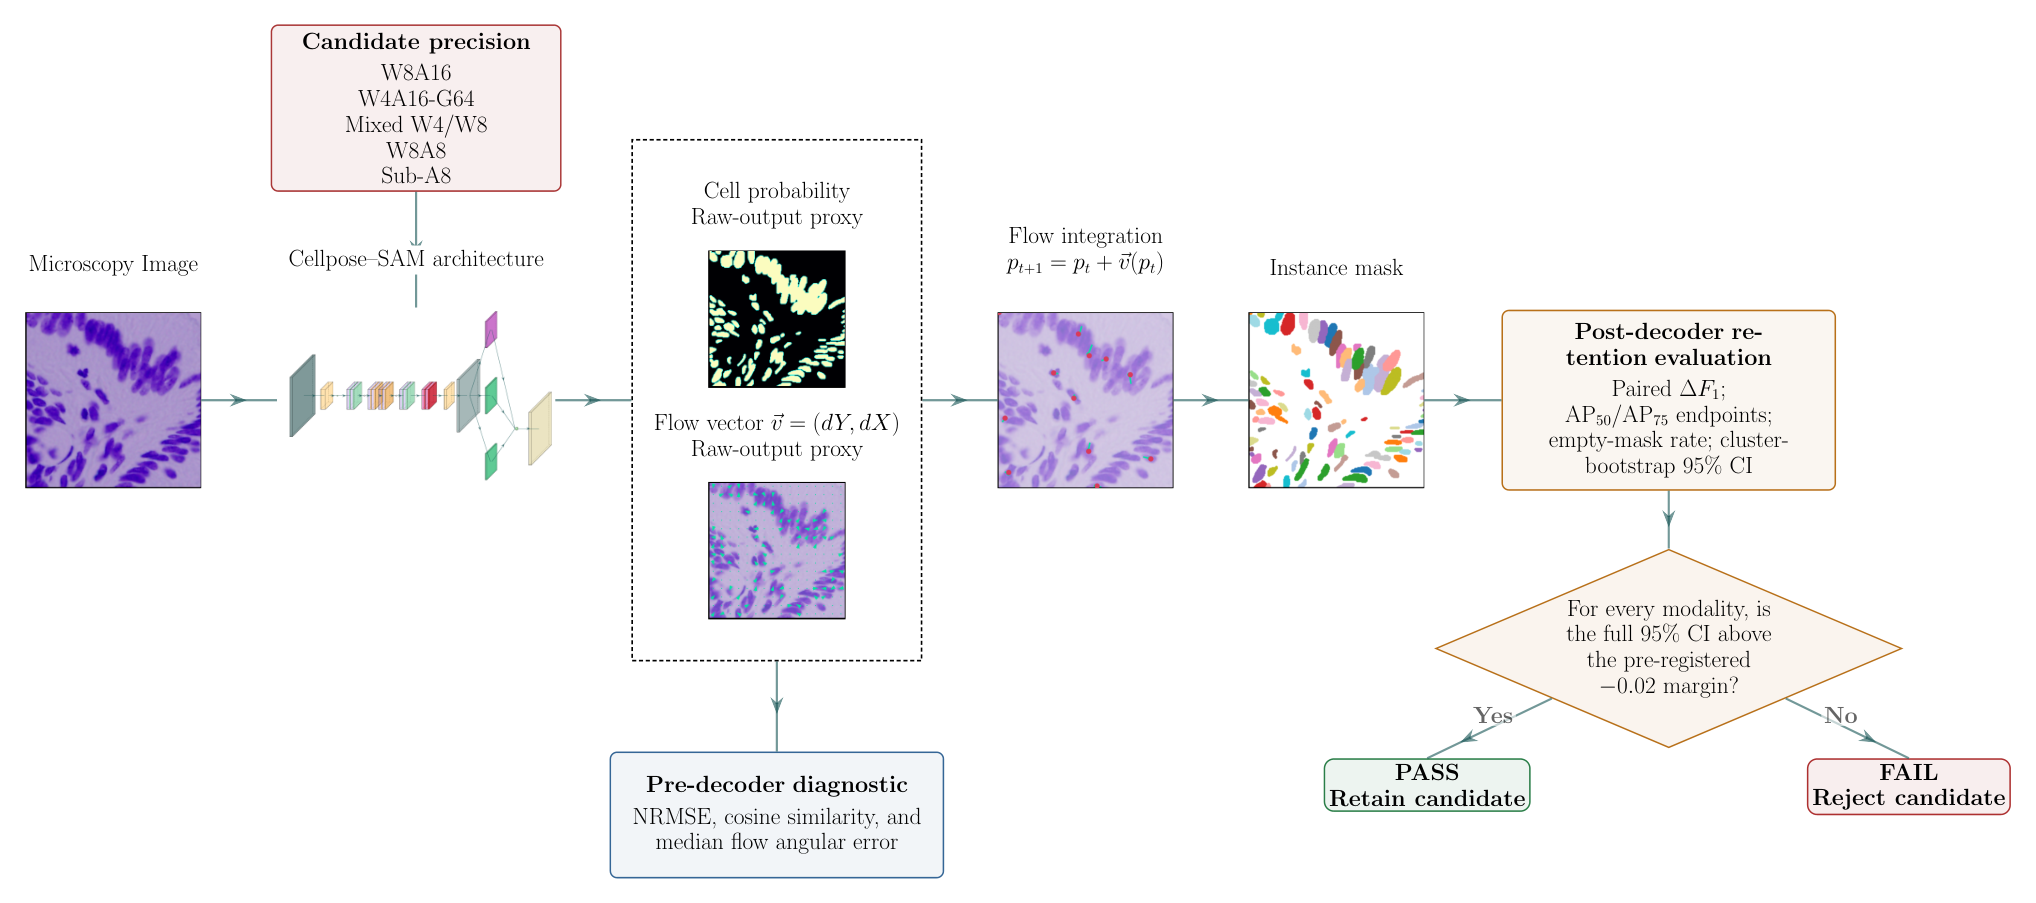
诱导多能干细胞(iPSC)培养日益依赖分割基础模型,但在实验室 CPU 与边缘硬件上部署,需要既高效又可审计的压缩方案。 本文提出面向部署的压缩 Cellpose-SAM 评估,采用预先设定的保留准则:对每一种成像模态,相对 FP32 的平均变化其 95% cluster-bootstrap 区间都必须高于固定的 -0.02 边际。 实验在分层 176 视野面板上进行,覆盖 BBBC038 细胞核、BBBC039 U2OS 荧光与 NIST iPSC 图像及不同密度区间: - 仅权重的 W8A16 在所有模态上保持 instance F1; - 敏感性引导的混合 W4/W8 方案(含 4 个 INT8 例外)将权重存储降低 6.76 倍,未观察到灾难性失败(0/176 视野),在该样本量下与 W8A16 持平; - 三值仅权重量化虽达到 12.08 倍压缩,却在 169/176 视野上灾难性失败。 结果表明,压缩应以模态分层的下游保留度来评估,而非单一精度数字,并为受监管干细胞成像中压缩基础模型的审计建立了可复现协议。
论文精读
TL;DR 用预定义保留标准(95% bootstrap 区间变化 > -0.02)量化 Cellpose-SAM,混合 W4/W8 方案实现 6.76× 压缩且分割 F1 与 FP32 相当、零灾难性失败,证明压缩评估需按模态分层下游保留而非单一准确率。
问题
问题背景
iPSC 培养 中的细胞分割越来越多依赖 分割基础模型(如 Cellpose-SAM),但实验室 CPU 与边缘硬件算力有限,需要将 FP32 模型压缩为低比特权重格式。
现有方法局限
常见的训练后量化评估仅报告总体平均指标(如 aggregate F1 或 mIoU),存在两个盲点:
- 忽视模态分层:不同成像模态(BBBC038 核、BBBC039 荧光、NIST iPSC)与细胞密度对量化误差敏感度不同,一个模态的轻微退化可能被其他模态的大样本稀释。
- 缺乏失败检测:例如三元权重量化可达到 12.08× 压缩,却在 176 个视野中 169 个出现灾难性失败;只看平均分极易漏掉这种不可部署风险。 现有评估也常跳过统计显著性判断,没有给出退化区间的置信范围,难以区分真实性能损失与随机波动。
为什么这个问题难 / 重要
压缩后的分割模型需在多模态、多密度的干细胞图像上保持稳定,任何单一异常都可能导致下游培养决策失误。此外,受监管环境要求可审计,压缩评估必须预先指定保留标准(如 95% cluster-bootstrap 区间不低于 −0.02 的 F1 变化),而不能事后挑选有利指标。技术难点在于:图像内细胞存在空间聚类,普通 bootstrap 会低估方差;混合精度方案需要依据敏感性分析选择少量高敏感层保留 INT8,平衡压缩比与可靠性。
行业类比
类似自动驾驶感知模型在车端芯片部署时,压缩不能只看整体 mAP——必须按天气、光照、障碍物类型分层验证“无灾难性失效”,否则单点感知错误可能酿成安全事件。
核心洞察
- 提出将“保留约束”作为压缩模型部署的通过/不通过标准,替代单一聚合精度。该工作预先规定每个成像模态的均值变化 95% cluster-bootstrap 区间必须位于 -0.02 以上,审计者无需依赖点估计即可判断模型是否满足要求。与常规量化评估仅报告平均精度或 mAP 不同,此方法直接对接受监管的干细胞成像场景中的可审计性和模态分层风险建模,避免全局均值掩盖某模态的严重退化。
- 混合精度量化方案中的少数 INT8 敏感层例外可在安全性和压缩率之间取得实用平衡,并需以最坏情况失败次数而非平均降幅为关键指标。使用四个 INT8 异常的 W4/W8 方案实现 6.76x 权重存储降低,0/176 场灾难性失败;而三元量化达 12.08x 但 169/176 场失败。这揭示分割基础模型存在极端量化阈值,工程上应通过敏感度分析定位关键层,并用分层面板验证各模态的失败率。
方法
方法概述
输入:从三种成像模态(BBBC038 核、BBBC039 U2OS 荧光、NIST iPSC)分层采样 176 个视野,覆盖不同细胞密度区间,构成多模态测试面板。
关键模块:
模型与压缩:以 Cellpose-SAM 分割基础模型为基座,采用训练后量化(PTQ)生成压缩变体:
- W8A16:权重 INT8、激活 FP16,仅压缩权重。
- Sensitivity-guided mixed W4/W8:逐层分析权重量化敏感度,大部分层使用 INT4,对高敏感层设置 四个 INT8 例外,平衡压缩率与功能保留。
- Ternary weight-only:权重三值化(-1, 0, +1),实现更高压缩比。
保留标准:对每个压缩模型,在各成像模态上计算实例级 F1 分数变化(相对 FP32 基线)。利用 cluster-bootstrap 构建变化均值的 95% 置信区间,要求区间下界不低于 -0.02 margin。同时对每个视野单独监测是否存在灾难性失败(输出显著退化)。
输出:各模态下的保留/失败判定、灾难性失败视野比例、权重存储压缩比。
方法差异:与仅报告全局平均精度的传统压缩评估不同,本方法采用模态分层 + 下游任务保留 + 预设边界的审计协议,强调压缩安全边界而非单一指标。
实验
实验设计
论文对 Cellpose-SAM 进行部署导向的后训练量化评估。采用分层 176 视野面板,覆盖 BBBC038、BBBC039、NIST iPSC 三种成像模态及不同细胞密度。预定义保留标准:每个模态的 FP32 平均变化 95% cluster-bootstrap 区间必须高于 -0.02。对比方案包括权重-only W8A16、敏感度引导混合 W4/W8(四个 INT8 异常)、三元权重-only。
关键发现
- W8A16 在所有模态上保持实例 F1。
- 混合 W4/W8 实现 6.76x 权重存储减少,0/176 视野灾难性失败,与 W8A16 匹配。
- 三元量化实现 12.08x 压缩,但在 169/176 视野上灾难性失败。
与基线对比
论文强调压缩评估应基于模态分层下游保留,而非单一准确度数字。混合 W4/W8 在接近三元压缩率的同时保持与 W8A16 相当的稳健性,展示了敏感度引导混合精度的工程价值。该协议为受监管干细胞成像中的压缩基础模型审计提供可复现范式。
行业影响
落地场景
该量化方案可直接用于 细胞治疗生产 与 干细胞研发平台 的显微镜图像分割部署。例如,生物制药公司的 iPSC 培养监测系统需要在实验室 CPU 或边缘设备上实时运行 Cellpose-SAM,以完成克隆形态、汇合度与密度计数。W8A16 及混合 W4/W8 方案可在不牺牲实例 F1 的前提下将权重存储降低 6.76 倍,使模型能在低成本工作站或嵌入式设备上稳定运行。另一个典型场景是 CDMO 的质量控制流程,需对每一批次的 iPSC 图像进行审计级分割,量化压缩后的模型可直接嵌入现有图像分析流水线。
商业价值
主要价值来自 降本与合规。权重压缩降低硬件采购与云推理成本,使分割基础模型摆脱对高性能 GPU 的依赖;同时,预定义的保留准则(95% cluster-bootstrap 区间不低于 -0.02)提供了可量化的性能保障,满足 GMP 环境下对软件工具审计追踪的要求。相较于单点准确率,模态分层下游保留评估能更早暴露灾难性失败(如三元量化 169/176 场失败),避免在生产环境中造成批次放行错误,从而减少质量事故与监管风险。对产品化而言,这是一条可复现的验证协议。
与现有工作流接口
集成方式与主流量化工具链兼容:方案基于 post-training quantization,可直接用于 ONNX Runtime、TensorRT 或 OpenVINO 等推理引擎,模型格式无需从头训练。团队可将该压缩评估脚本作为 CI/CD 中的一个 stage,对每个候选模型自动生成分层保留报告;同时,混合 W4/W8 的敏感度分析(四个 INT8 例外)可作为超参数模板,适配不同模态的新数据集。与现有显微镜软件(如 CellProfiler、ImageJ 插件)的对接可通过导出量化权重后的 ONNX 模型完成,无需改变前端标注或分析流程。
局限
- 样本量与泛化性有限:论文使用 176 场图像覆盖三个数据集(BBBC038、BBBC039、NIST iPSC),但各模态和密度区间的样本可能不足以代表真实 iPSC 培养中所有成像变异,例如不同显微镜型号、染色方案、细胞系差异。预定义的 retention margin `-0.02` 是人为设定,虽然提供了清晰的审计标准,但其合理性未经过跨实验室或跨数据集的独立验证。此外,评估仅针对 Cellpose-SAM 单一模型,未验证其他分割基础模型(如 SAM 2、MedSAM)在相同量化约束下的表现,限制了结论的普适性。
- 量化方案与压缩手段覆盖不足:仅评估了权重仅量化(W8A16、混合 W4/W8、三元)三种方案,未涉及激活量化(如 W8A8)、更细粒度的混合精度(如按层或按通道混合),也未与剪枝、知识蒸馏等正交压缩方法结合或对比。三元量化失败(169/176 场)的原因未深入分析,仅给出整体失败率,缺乏层级敏感性诊断,无法指导后续改进,例如定位哪些层对量化最敏感并针对性调整。
- 评估指标与部署收益衡量不全面:论文仅使用 instance F1 作为分割性能指标,未评估下游任务(如细胞计数误差、集落形态参数、融合度估计)的影响,而这些指标在实际干细胞制造质量控制中更为关键。同时,边缘硬件上的实际推理延迟、内存占用和能耗未直接测量,仅报告权重存储压缩比,无法全面反映部署收益。与现有量化工具(如 GPTQ、AWQ)或 AutoGPTQ 等成熟方案缺乏直接对比,难以判断本方案在效率与精度权衡中的相对优势。