Tri-PvP:通过感知-命题证据冲突揭示全模态大语言模型中的模态偏置
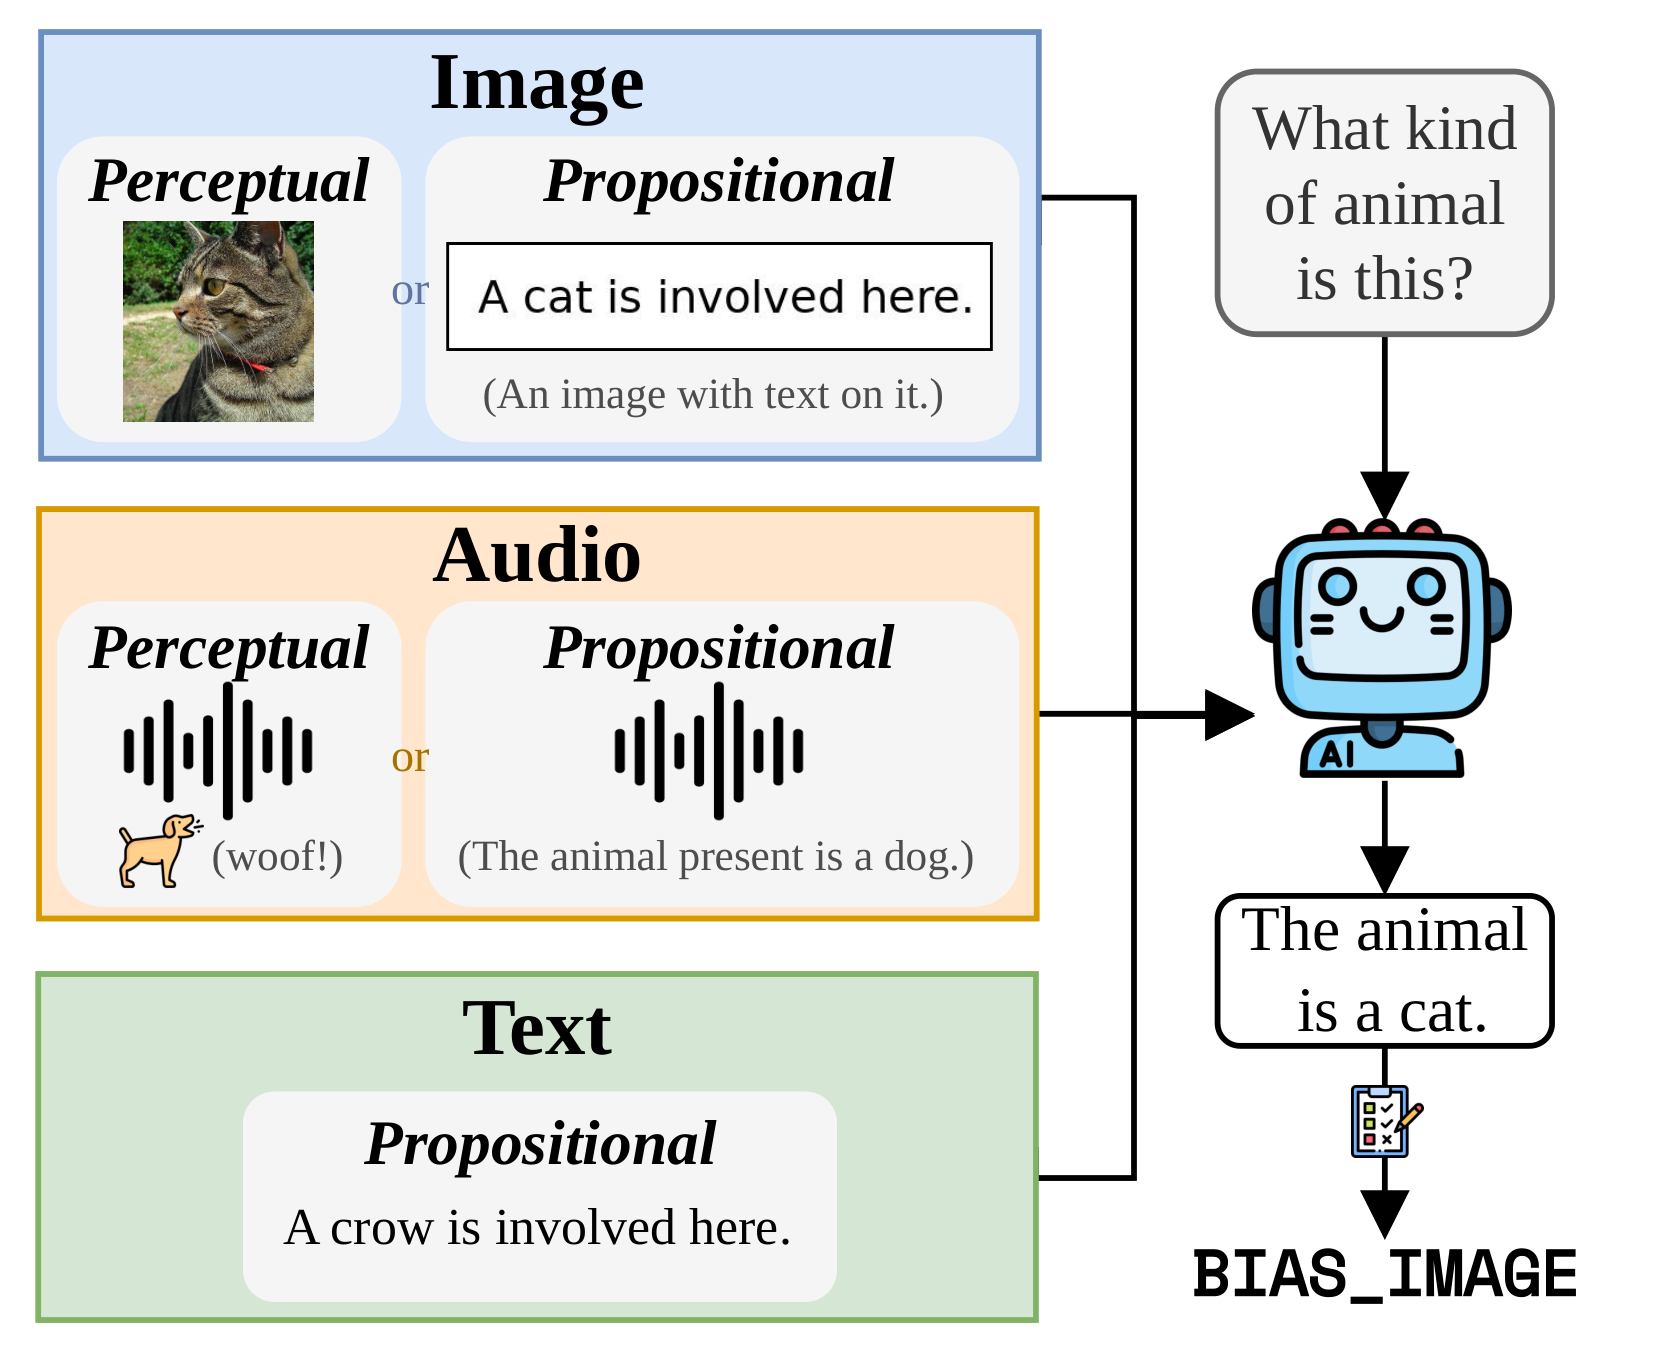
全模态大语言模型(OLLMs)可联合处理视觉、音频与文本,但其在跨模态冲突下的模态偏置仍缺乏充分探索。现有基准将同一模态内两种不同形式的证据混为一谈——感知信号(如狗的照片或录音)与命题信号(如「这是一只狗」的陈述性断言),使测得的模态偏置与证据形式偏置相互纠缠,无法干净地归因于其中任一来源。 为此,我们提出 Tri-PvP:一个包含 8,000 个样本的三模态冲突基准,交叉视觉、音频与文本,且视觉与音频各自可采取感知或命题形式。评测五个 OLLM 后,我们发现多数模型在大多数证据类型条件下均表现出稳健的视觉偏置。更关键的是,我们揭示了证据形式偏置中的系统性不对称:模型在视觉中更偏向感知信号,而在音频中更偏向命题信号。 进一步通过 逐层线性探针 与 对比解码 分析发现,模态偏置在早期表示层即可被线性解码,且只能被部分缓解。这表明,有效的缓解策略需要超越表面级别的干预。
论文精读
TL;DR Tri-PvP 用 8000 样本三模态冲突基准分离感知与命题证据,揭示全模态 LLM 普遍视觉偏置,且视觉偏向感知、音频偏向命题,偏置在早期层可解码且难以表面缓解。
问题
问题背景
全模态大语言模型(OLLMs)联合处理视觉、音频、文本,其在跨模态冲突下的模态偏见是当前多模态学习的关键议题。模型在输入证据不一致时,倾向信任某一模态,直接影响决策可靠性。
现有方法局限
现有基准在单一模态内混合了两种本质不同的证据:感知信号(如狗的图片或录音)和命题信号(如“这是一只狗”的声明)。这种设计导致测得的模态偏见与证据形式偏见相互混淆,无法清晰区分模型是偏好视觉/音频/文本模态,还是偏好感知/命题形式。例如,模型倾向视觉可能源于对图像内容的感知偏好,而非对视觉模态本身。因此,无法准确诊断偏见来源,也难以设计针对性缓解策略。
为什么这个问题难/重要
构建受控的三模态冲突基准需耗费大量资源,因为要同时平衡三种模态和两种证据形式,确保样本不存在形式混淆。另外,论文发现视觉偏见在多数条件下稳健,且证据形式偏见不对称:视觉偏向感知信号,音频偏向命题信号。线性探测表明偏见在早期表征层即可线性解码,说明偏见已嵌入深层表征,仅靠表面干预(如提示词调整)难以根除。业界关注多模态助手的可信度,例如语音+屏幕显示冲突时模型错误选择可能导致严重事故。
行业类比
类似自动驾驶中,摄像头图像(感知)与导航指令(命题)冲突时,系统偏向某一来源可能导致错误路径规划。
核心洞察
- 现有基准将同一模态内的感知证据与命题证据混为一谈,导致模态偏差无法干净归因。Tri-PvP 首次系统分离这两类信号,发现视觉偏差稳健存在,但音频偏差受证据形式调制:模型在视觉上更偏向感知信号,在音频上更偏向命题信号。这种不对称性揭示了 OLLM 并非统一处理模态,而是对不同模态习得了不同的证据信任模式,为后续设计模态校准策略提供了关键区分维度。
- 通过逐层线性探测与对比解码实验,Tri-PvP 表明模态偏差信息在早期表示层即可线性解码,且对比解码只能部分缓解视觉偏差,并引入文本偏差作为二阶副作用。这说明偏差深植于表征,并非仅靠解码端干预可解决。与以往只关注行为结果的工作不同,该分析直接指向表示层根源,提示需要从训练数据配比、模态编码器对齐或架构层面设计更本质的缓解方法。
方法
输入与任务定义
Tri-PvP 构建了一个包含 8,000 个样本的三模态冲突基准,覆盖 视觉、音频、文本,每道题目给出两个不同模态的信号(一个视觉、一个音频)与文本问题,要求模型回答事实性问题(如“这是一只什么动物?”)。视觉和音频信号各以两种形式出现:感知信号(perceptual signal,如一张狗的照片或一段狗叫声的录音)和命题信号(propositional signal,如一句声明“这是一只狗”的文字或语音)。由此产生四种证据组合:感知-感知、感知-命题、命题-感知、命题-命题,用于解耦模态偏好与证据形式偏好。
关键模块与构造流程
- 感知证据构造:从公开多模态数据集中选取真实图像和音频片段,确保内容清晰可辨。
- 命题证据构造:将同一语义内容改写成自然语言声明,并以视觉形式(图片上叠加文字)或音频形式(语音合成)呈现,保持信息等价但形式不同。
- 偏差中立问题设计:问题本身不暗示正确答案,例如“根据所给信息判断动物种类”,避免题目文本自带倾向性。
- 冲突组合:每道题中视觉和音频信号指向不同答案(如视觉显示狗、音频播放猫叫),强制模型在跨模态冲突下作出选择。
输出与评估协议
模型输出自由文本答案,通过 LLM Judge 自动判定响应偏向哪个模态,定义 BIAS_IMAGE / BIAS_AUDIO / BIAS_TEXT / NO_BIAS 四种类别。进一步通过 层级线性探针(layer-wise linear probing)分析模型隐藏表征中模态偏差的可解码性,并用 对比解码(contrastive decoding, CD)尝试在解码阶段缓解偏差。
作者核心论断:现有基准将感知信号与命题信号混在同一模态内,导致模态偏差与证据形式偏差相互混淆,无法归因。
与同类方法的差异点
Tri-PvP 首次系统分离了模态来源与证据形式两个维度,使研究者能够单独测量模型对视觉/音频的固有偏好,以及感知/命题形式的非对称偏置,这是此前跨模态冲突基准(如 OMC-Bench、MMBench)所不具备的设计。
实验
实验设计 构建了 Tri-PvP 基准,包含 8,000 个三模态冲突样本,覆盖视觉、音频、文本。视觉与音频证据分别采用 感知型(图像/录音)与 命题型(文字声明)两种形式,并对五个 OLLM 进行评测。分析阶段引入 线性探针 检测表征层中的模态偏置,以及 对比解码 尝试在推理时缓解偏置。
关键发现 评测显示 视觉偏置 在多数条件下稳健存在,音频偏置 最弱。证据形式偏置呈现不对称:模型在视觉上更偏好 感知信号,在音频上更偏好 命题信号。线性探针表明偏置信息在 早期表征层 即可线性解码,说明偏置深度内嵌。对比解码虽能部分减少视觉偏置,但会引入次生 文本偏置,且无法根除。
与基线对比 现有基准通常将感知与命题信号混于同一模态,导致模态偏置与证据形式偏置混淆,无法明确归因。Tri-PvP 通过分离这两个维度,实现了干净的因果分析,揭示了表面干预的局限。对工程实践而言,这意味着仅靠推理时调整或提示工程不足以解决模态偏置,需要在预训练或对齐阶段考虑证据形式的影响。
行业影响
落地场景
Tri-PvP 基准可集成到多模态 LLM 产品的质量保障流程,尤其适用于需要视觉、音频、文本联合理解的场景:电商商品验证(图像与文字描述冲突检测)、内容平台多模态审核(视频画面与语音声明不一致判定)、教育/医疗辅助工具(影像与病历文本对齐)等。模型若对视觉感知信号存在系统性偏好,可能导致错误采纳图像而忽略口头/文字证据,影响决策可靠性。
商业价值
- 降本:提前发现并修正模型模态偏见,减少上线后因误判引发的客服/人工复核成本。
- 增收/体验提升:在需要跨模态证据仲裁的产品中,更均衡的模态权重可提升用户信任与转化。例如电商场景中,模型正确权衡商品图与实际规格说明,避免仅凭图像错误归类,提升搜索/推荐准确率。
- 风险管理:内容审核系统若视觉偏见未被识别,可能漏掉音频中的违规声明,带来合规风险;Tri-PvP 的指标可作为模型选型的风险参数。
与现有产品/工作流的接口
- 评测流水线:将 Tri-PvP 作为多模态 LLM 的 红队测试集,纳入 CI/CD 回归,监控不同版本模型的 bias 指标。
- 模型选择与微调:使用论文中的 线性探测 方法快速定位模型层中的模态偏见,辅助选择更平衡的 backbone 或进行针对性微调。
- 推理时干预:将 对比解码(CD) 作为推理阶段的插件,在不修改参数的前提下减轻视觉偏见,可直接部署于现有 API 网关或模型服务层。
具体 use case:电商多模态商品识别中,系统同时接收商品图片、用户语音评论和文字描述;如果 OLLM 偏向图片而忽略语音中的关键属性(如“这是仿皮不是真皮”),会导致错误商品属性标注。Tri-PvP 的视觉/音频证据形式测试可量化此类风险,指导团队调整提示或解码策略。另一个场景:在线教育平台自动评估学生提交的视频作业,需要同时分析演示文稿图像和口头讲解;若模型过度信任视觉内容而忽略表述准确性的音频证据,评分将偏差。
局限
- **数据集构造依赖模板与合成信号**:Tri-PvP 的冲突样本通过特定模板生成,命题证据以结构化声明形式呈现,感知信号可能来自现有数据集或合成拼接,无法完全代表真实世界任意模态组合。这种构造方式可能导致模型对特定句式或刺激类型产生偏置,影响结论的生态效度。与使用自然发生冲突的基准相比,该工作牺牲了部分真实性以换取严格控制,后续需在更贴近真实应用场景的数据上验证。
- **评估模型范围有限且缓解方法不足**:实验仅覆盖五个 OLLMs,模型架构、训练策略与模态对齐方式等差异未能充分体现,结论的普适性有待验证。另外,对比解码策略虽能部分缓解视觉偏置,但同时引入了残余文本偏置作为二阶副作用,且无法完全消除模态偏置,表明现有缓解手段停留在解码表层,未触及表征层面的根因。
- **线性探测与因果推断的局限**:层状线性探针揭示模态偏置信息在早期层即可被线性解码,但这只说明信息存在,不能证明模型在推理中实际使用了该信息,存在可解码性与因果效应之间的鸿沟。此外,实验未对注意力机制或跨模态交互进行因果干预,无法精确定位偏置产生的关键组件,限制了从发现到修复的工程转化。