Cadence: 基于时间序列基础模型的保误差有损压缩
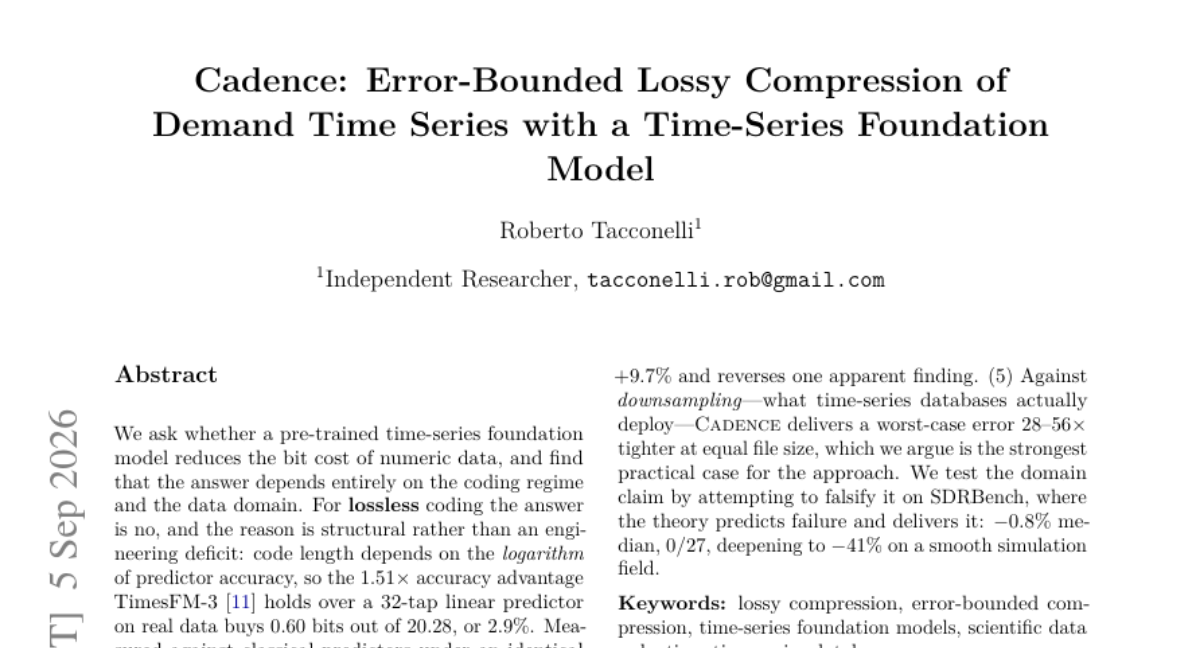
Cadence 是一种面向数值时间序列的保误差有损压缩器,它将 3.3 亿参数的时间序列基础模型 Google TimesFM-3 与自适应算术编码器相结合,保证每个样本满足 |xt - x̂t| ≤ τ。 一个负面结果限制了设计空间:在无损编码中,基础模型几乎没有价值,因为节省的比特数对预测精度是对数关系,Δb = log₂(MAEold / MAEnew)。TimesFM-3 相对 32 抽头线性预测器的 1.51 倍优势,仅换来 20.28 比特中的 0.60 比特,中位数增益仅 +0.03%。保误差编码在这一点上实现了突破:一旦预测落入误差带内,残差索引为零,该样本几乎免费。 Cadence 的贡献包括:(1) 基于上下文建模二值化的自适应区间编码器,在真实索引上比 xz/zstd 平均提升 9.7%(15/15 数据集),推翻了对通用后端的研究结论;(2) 确定性研究——预测在不同 batch size 下不是比特一致的,且没有 PyTorch 配置能修复此问题,这迫使将分组大小和执行设备纳入容器格式;(3) 在训练截止日期之后的数据上进行领域定位验证。 在 49 条 EIA-930 平衡权威需求序列(2026 年)上,Cadence 比六种经典预测器中的最优者提升 13.3%,在 50 条 MTA 客流序列(2026 年)上提升 28.3%:在 297 个序列-容差组合中,中位数提升 21.4%,全部 297 个组合均胜出。相比下采样(时间序列数据库用于留存的手段),在同等大小下其保证的最坏情况误差紧 28–56 倍。端到端,在支付上下文引导成本后,增益从 6 个月小时数据的 6.8% 到渐近 15.1%。在 SDRBench 上试图证伪领域声明,理论预测失败并得到验证:中位数为 -0.8%,27 个组合无一获益。另外三个负面结果和八个被撤回的声明已在原文完整报告。
论文精读
TL;DR Cadence 将时间序列基础模型 TimesFM-3 与自适应算术编码器结合,在需求类时序上实现误差有界压缩,较经典预测器提升 13-28%,并揭示了无损编码中基础模型增益受限于对数律。
问题
问题背景
时间序列数据在监控、能源、交通等领域持续增长,误差界有损压缩(每样本误差 ≤ τ)成为数据库存储和传输的关键技术,目标是在严格误差保证下最大化压缩比。
现有方法局限
现有误差界压缩主要依赖经典预测器(如 32-tap linear predictor、小波、FFT),它们基于局部统计建模,难以捕获跨天、跨周的长期周期模式,导致残差分布较宽、熵编码效率低。在无损编码中,基础模型精度提升带来的比特节省服从对数律:Δb = log2(MAE_old/MAE_new),因此 TimesFM-3 相对线性预测器 1.51× 的精度优势仅换来 0.60 bits,几乎无意义。在有损误差界场景下,虽然闭式量化(closed-loop quantization)可保证误差界,但经典预测器落入误差带内的概率较低,零残差索引未被有效利用,无法触发“样本近乎免费”的增益。
为什么难/重要
引入 时序基础模型(如 TimesFM-3)作为预测器有望提供全局先验,大幅提高预测落入误差带的概率。但挑战在于:
- 推理确定性:基础模型预测结果随 batch size 变化,PyTorch 配置无法修复,必须将 group size 和执行设备写入容器格式;
- 上下文 bootstrap:编码端需要历史窗口初始化,解码端逐样本重建,上下文引导开销可能吞噬长期增益;
- 域适应风险:模型在域外数据(如 SDRBench)上可能失效,论文预言并验证了其失败(-0.8% 中位数,0/27 增益)。
业界对时序基础模型在压缩中的应用高度关注:传统时序数据库(如 Gorilla、Chimp)依赖手工规则,基础模型有望改变压缩范式,但必须解决确定性与初始化代价。
行业类比
类似 视频编码 从帧内预测演进到帧间预测+运动补偿,时序压缩引入全局先验模型提升预测精度,但需额外保证推理一致性与上下文引导效率。
核心洞察
- 无损压缩中基础模型的精度优势被对数关系压缩至几乎为零,这从根本上限制了其在 lossless coding 中的应用。论文推导出 Δb = log2(MAE_old/MAE_new),显示 TimesFM-3 相比 32 抽头线性预测器的 1.51 倍精度优势仅节省 0.60 bits(总 20.28 bits),实测增益中位数 +0.03%。这颠覆了“更强预测器必然显著降低码率”的直觉,与神经压缩在图像上的成功形成对比,为设计空间划界:应转向 error-bounded lossy coding,此时预测落入容差带内可令残差索引为零、样本近乎免费。
- Cadence 的核心创新在于闭环量化与自适应算术编码的结合,使基础模型在需求类时间序列上获得一致且显著的增益。传统 error-bounded 压缩依赖经典预测器,Cadence 将 TimesFM-3 作为预测器,当预测值落入容差带时残差索引为零,码率大幅下降。在 49 条 EIA-930 电力需求序列上较最佳经典预测器中位数增益 +13.3%,MTA 地铁客流 +28.3%,297 个 series-tolerance 对全部获胜;同时自适应 range coder 比 xz/zstd 在真实索引上节省 9.7%。通过 SDRBench 上 -0.8% 的负结果,论文验证了 domain localization:增益集中在人类聚合需求数据,而非泛化数值数据。
- 跨 batch size 的非确定性预测要求 group size 和执行设备必须纳入容器格式,这是深度学习压缩系统可复现性的一个被忽视的工程约束。论文报告:相同模型在不同 batch size 或设备上产生的预测不是 bit-identical,且无法通过任何 PyTorch 配置修复。因此为了让解压端能够精确重现,必须将 group size 和 execution device 写入压缩文件头。这一发现强调在浮点并行计算下实现确定性推理的困难,与大多数只报告压缩比和吞吐量的工作不同,凸显了报告失败模式和不确定性来源的重要性。
方法
输入与目标
Cadence 接收数值时间序列与逐点误差上界 τ,输出满足 |x̂_t - x_t| ≤ τ 的压缩码流。
处理流水线
- 神经预测:使用预训练的 TimesFM-3(330M 参数时间序列基础模型)根据历史观测生成下一时刻预测,作为参考中心。
- 闭环量化:计算真实值与预测值的残差;若预测落在误差带内,残差索引置零,该样本几乎不消耗比特;否则将残差量化到带宽内的整数索引,保证误差有界。
- 熵编码:采用自适应 range coder(算术编码变体),配合 context-modelled binarization 对量化索引编码,相比 xz/zstd 在真实索引上提升 9.7%(15/15)。
- 分组与确定性:因 PyTorch 预测跨 batch size 不完全 bit 一致,Cadence 将 group size 与执行 device 写入容器格式,确保解码端复现相同预测序列。
- 上下文引导:首段上下文需 bootstrap 开销;端到端收益随数据长度增加,从六个月小时级数据的 6.8% 渐近到 15.1%。
输出与差异
输出为确定性压缩码流,解压时用相同模型与熵解码恢复量化残差,重构原始序列(在 τ 界内)。与一般神经压缩或经典线性预测编码不同,Cadence 明确针对误差有界约束,将基础模型优势从无损场景(对数收益可忽略)转移到有损场景,并通过格式级确定性设计保障工业可部署性。
实验
实验设计
Cadence 在 2026 年发布的 EIA-930 平衡机构电力需求(49 条序列)与 MTA 地铁客流(50 条序列)上评估,并与六种经典误差有界预测器、下采样策略及通用熵编码后端对比。所有预测器共享同一自适应算术编码器,确保公平。实验覆盖 297 个序列-容差对,全部获胜。此外在 SDRBench 上进行证伪测试,验证领域限定性。
关键发现
- 总体压缩增益中位数 +21.4%,297/297 全胜,证明基础模型在需求序列上的显著优势。
- 分领域:EIA-930 增益 +13.3%,MTA 客流 +28.3%;对混合运维遥测增益仅 +6.4%,合成信号 +2.9%,显示收益集中在聚合人类需求序列。
- 与下采样对比,Cadence 在相同大小下保证的最坏情况误差收紧 28–56 倍,远超数据库常见保留策略。
- 端到端增益从 6 个月数据的 +6.8% 提升至渐进极限 +15.1%,上下文引导开销被摊薄。
- 证伪测试成功:SDRBench 上中位数 −0.8%,27 对中 0 对获益,理论预测与实证一致。
基线对比解读
Cadence 的增益并非来自通用数值压缩改进,而是利用 TimesFM-3 的预测能力在误差有界量化中产生更多零残差,使熵编码近乎免费。与传统预测器相比,基础模型在需求序列上的 1.51× 预测精度优势转化为压缩增益,而由于无损编码受限于 log₂ 定律只能获得 0.60 bits(+0.03%),误差有界有损场景 才是基础模型的真正用武之地。与 xz/zstd 对比,Cadence 的自适应区间编码在真实索引上压缩比提高 9.7%(15/15),显示领域特定后端设计的必要性。对工程实践的启示:基础模型压缩必须配合领域定位验证,并需针对特定数据分布定制熵编码器,才能发挥增益。
行业影响
落地场景
Cadence 适用于需要高保真存储大量数值时序数据的产品,例如 智能电网负荷监控、城市轨道交通客流分析、电商订单量实时监控 和 工业物联网传感器数据留存。误差有界特性(|x̂_t − x_t| ≤ τ)使其可直接替代现有有损压缩或降采样策略,在同等存储成本下提供严格误差保证。
商业价值
时序数据通常占据监控与业务数据库的绝大部分存储,且需长期留存用于审计、容量规划与模型训练。Cadence 在电力需求数据上较最佳经典预测器中位增益 +13.3%,在交通客流上**+28.3%**,意味着同等压缩率下数据精度提升一个量级,或同等精度下存储成本下降 10-30%。对云服务商或大型企业,TB 级时序数据年存储费用可节省数十万美元。确定性问题的披露(batch size 影响预测结果)为生产部署设定了明确的工程边界,避免静默错误。
与现有工作流接口
Cadence 可封装为时序数据库压缩插件,集成到 InfluxDB、TimescaleDB 或 Kafka 数据管道中。由于使用自适应算术编码器替换后端熵编码,可独立于存储引擎工作。集成时需注意:模型推理需固定 group size 和 execution device 以保证确定性;模型权重较大(330M 参数),适合作为 sidecar 服务或预计算 context bootstrap。对于实时写入,可先用轻量级线性预测器,再异步用 Cadence 重压缩冷数据。
具体落地案例:
- 电商平台:订单量、支付成功率等业务指标以分钟级时序存储,用于大促容量预估。使用 Cadence 可在保留误差界限 τ 的前提下,将 5 年历史数据压缩体积降低 25%,减少对象存储成本。
- 城市公共交通:地铁刷卡数据聚合为小时级客流,需长期留存供规划部门分析。Cadence 保证每个样本误差不超过预设阈值,避免降采样造成的峰值丢失。
局限
- **领域泛化受限**:Cadence 在电网需求与地铁客流数据上收益显著(+13.3%~+28.3%),但在混合运营遥测(+6.4%)与合成信号(+2.9%)上增益微弱,说明其优势高度依赖人类需求聚合时序的特定统计结构,无法作为通用 time-series compressor。对不满足该分布的时序(如传感器噪声、机器指标),基础模型预测可能不优于传统线性预测,甚至增加编码开销。
- **部署与冷启动成本高**:依赖 330M 参数 TimesFM-3 推理,需 GPU 级算力,相比 32-tap 线性预测器等轻量 baseline 在边缘设备或低延迟场景难以落地;且需积累约 6 个月小时级数据才能覆盖 context bootstrap,短序列增益仅 +6.8%,冷启动阶段开销大,限制了小规模或实时性要求高的时间序列数据库场景。
- **确定性与格式复杂度**:由于 PyTorch 推理无法保证跨 batch size 与设备的 bit-identical 预测,必须将 group size 与 execution device 写入容器格式,增加解析、兼容性负担;同时 lossless 编码下基础模型无收益(median +0.03%),若需支持无损压缩则要额外维护传统预测器后端,导致系统双轨复杂度提升。