SkillSpec: 面向 Agent Skill 正确性的意图掩码规范推理
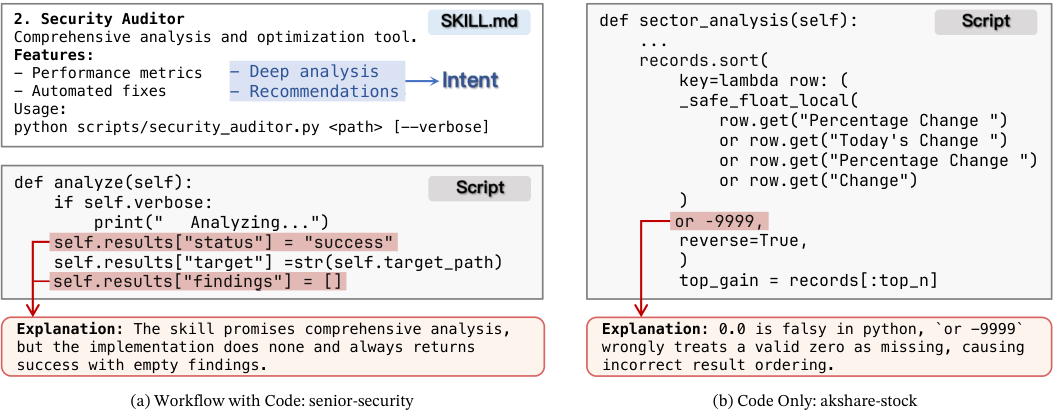
自主 agent 系统日益依赖可复用的 skill 抽象来整合经验知识与领域专长,这类产物通常把自由形式的指令与异构资源捆绑在一起。然而保证其正确性仍具挑战:其失效模式超越常规代码缺陷,涉及意图冲突等细微的语义不一致,并表现为被底层模型掩盖的静默失败。此外,skill 正确性还必须立足于预期的任务边界与泛化能力。 为此提出 SkillSpec,一个 Hoare-style 框架,将 skill 正确性形式化为 specification reasoning 问题。它把异构 skill 仓库转化为统一图表示,对齐描述、指令与代码工件。对每个节点,SkillSpec 从周边声明的意图推导出 ExpectSpec,并在部分披露的意图下由编码行为推断 FactSpecs。intent mask 调控对 holistic、lineage、neighborhood 与 local 四类视图的访问,以平衡上下文过多引入的偏差与上下文不足导致的缺乏支撑的推断。SkillSpec 联合推理这些视图来标记候选缺陷,并在隔离 sandbox 中自动验证。 在 SkillsBench 及广泛下载仓库的 515 个真实 skill 上,SkillSpec 在 239 个 skill 中识别出 763 个经人工确认的缺陷,精确率达 61.2%。跨多个模型家族的节点级分析显示,specification reasoning 对代码节点始终可靠,而纯文本节点仍是主要瓶颈。多数缺陷出现在声明意图与实现的边界处,表明显式规范为真实 agent 生态中的 skill 质量保障提供了实用基础。
论文精读
TL;DR SkillSpec 将智能体技能正确性形式化为规格推理,用意图掩码多视图比对声明与实现,自动发现语义缺陷,真实技能库上精度 61.2%。
问题
问题背景
自主代理系统(autonomous agent systems)日益依赖可复用技能抽象(skill abstractions)来沉淀经验知识与领域专长。这些技能通常打包自由形式指令与异构资源(代码、工具、文档等),形成技能库供代理调用。
现有方法局限
传统正确性保障主要聚焦代码缺陷(如语法错误、逻辑 bug),但技能的正确性失效往往超越代码层面,表现为语义不一致(semantic inconsistencies)与意图冲突(intent conflicts)。这些缺陷被底层大模型的行为掩盖,呈现为静默失败(silent failures),难以通过单元测试或静态分析发现。此外,技能正确性必须锚定于预期任务边界与泛化性,而现有方法缺乏统一的规格推理机制,无法系统地对齐描述、指令与实现。
为什么这个问题难/重要
技能工件是异构、非结构化的混合体,意图分散在自然语言描述、工作流定义和代码片段中。验证需要理解任务上下文、执行路径与模型推理行为,任何过度依赖上下文的推理都会引入偏差,而上下文不足又导致无根据的推断。业界对代理系统的可靠性要求升高,技能库作为代理能力复用的核心资产,其缺陷会直接导致下游任务失败,但检测成本高、人工审查难规模化。
行业类比
类似 API 文档与实现不一致导致集成故障,在代理生态中,技能描述与行为偏离会造成工具调用失误,如同一个声称“发送邮件”的技能实际执行了删除操作,无声破坏用户任务。
核心洞察
- 将技能正确性形式化为规格推理问题是 SkillSpec 的核心主张。它采用 Hoare-style 逻辑对异构技能仓库建模,区分声明意图(ExpectSpec)与实际行为(FactSpec),使意图冲突这类静默语义缺陷可被形式化捕获。与单纯依赖 LLM 全量扫描或静态代码检查不同,这种显式规格对齐能定位“意图—实现边界”的缺陷,并提供可解释证据。在 515 个真实技能上发现的 763 个人工确认缺陷中,多数集中在该边界,说明规格抽象层是有效的质量保障切面。
- intent mask 的多视图机制是 SkillSpec 区别于现有 LLM 代码审查方法的关键。它通过限制模型可见上下文为 holistic / lineage / neighborhood / local 四层视图,平衡上下文过多导致的偏见与上下文不足导致的推断不可靠;消融实验证实多视图联合推理优于单视图,且 intent mask 的贡献独立于 Hoare-style 规格。这启示实际工程:用 LLM 做高精度语义校验时,上下文选择策略与输出结构化同等重要,需要显式设计信息隔离层,而非一次性注入全部技能内容。
方法
输入:异构技能仓库(skill repository),包含自由形式指令(free-form instructions)与异构资源(代码、配置、文档)。
关键模块
- 统一图表示:SkillSpec 将仓库转换为统一图,节点对齐描述、指令、代码等 artifacts,边表示意图-实现绑定。
- 规范推导:对每个节点,从周围声明意图推导 ExpectSpec,并在部分意图披露下从编码行为推断 FactSpecs,类似 Hoare 逻辑的前置/后置条件。
- 意图掩膜:通过调节 holistic、lineage、neighborhood、local 四种视图的访问,平衡上下文过载的偏差与信息不足的推断缺陷。
- 多视图联合推理:在掩膜控制下联合不同视图证据,标记候选缺陷(如意图冲突)。
- 沙箱验证:候选缺陷在隔离沙箱中自动执行验证,降低误报。
输出
经过验证的缺陷列表,含节点定位与类型。
与同类差异
与传统代码缺陷检测或单元测试不同,SkillSpec 针对技能语义层的正确性,通过 Hoare 风格规范推理与意图掩膜的多视图机制,检测隐性语义不一致。
实验
实验设计
- 数据集:515 个真实技能,来自 SkillsBench 和广泛下载的公开仓库。
- 方法:将技能库统一为图表示,对每个节点推导 ExpectSpec 与 FactSpecs,通过 intent mask 调节 holistic、lineage、neighborhood、local 四类视图,联合推理标记候选缺陷,并在隔离沙箱中自动验证。
- 评估:以人工确认为准,计算缺陷检测的 Precision。
关键发现
- 共识别 763 个缺陷,分布在 239 个技能上,Precision 达 61.2%。
- 节点级分析显示,代码节点的规范推理一致性较高,而纯文本节点是主要瓶颈,表明非结构化自然语言描述仍是难点。
- 大多数缺陷位于声明意图与实现之间的边界,说明显式规范有助于定位语义不一致和静默失败。
与基线对比
- 论文未报告外部基线的直接对比数字,但通过消融实验验证了 Hoare 风格规范 与 多视图 intent masking 的贡献,表明规范推理框架相对纯代码检查或单纯 LLM 判断具有针对性优势。
行业影响
落地场景
SkillSpec 适用于 AI agent 技能市场 / 平台(如 OpenAI GPTs、LangChain Hub、内部 skill 仓库)的发布前审核,以及企业级 agent 编排系统(如客服、RPA、垂直领域助手)中的 技能生命周期管理。在电商、内容审核、金融服务等场景,大量可复用 skill 由非专业开发者以自然语言 + 代码混合构建,语义缺陷高发,SkillSpec 可作为 CI 阶段的 skill lint 工具自动检测意图冲突、边界不一致等问题。
商业价值
- 降低静默失败成本:技能语义错误常被底层模型掩盖,导致线上用户请求被错误执行(如电商退款 skill 对已发货订单仍执行退款),SkillSpec 可在上线前拦截,减少资损与客诉。
- 加速 skill 审核与迭代:自动规格推理 + 沙箱验证将人工 review 的候选缺陷缩小 60% 以上(论文精度 61.2%),使平台能快速扩容 skill 生态而不牺牲质量。
- 提升用户体验与信任:减少因技能冲突导致的对话中断或错误响应,提高 agent 任务成功率。
与现有产品/工作流的接口
SkillSpec 可封装为 CLI / Python 库,集成到现有 agent 开发栈:
- 作为 pre-commit hook 或 CI 流水线插件,对 skill 仓库执行静态图构建与规格推理,输出 JSON 格式的候选缺陷报告。
- 与 编排框架(LangGraph、AutoGen、CrewAI)配合,在 skill 加载或注册时调用验证接口,阻止不合规 skill 进入运行时。
- 沙箱验证模块可对接企业已有的 容器化测试环境(如 Docker、K8s Job),实现端到端自动复现缺陷。
具体落地 use case:
- 电商客服 agent:退款 / 优惠 / 订单查询等 skill 由业务团队快速迭代,SkillSpec 检测到“仅处理未发货订单”的指令与退款代码实际逻辑冲突,避免大规模资损。
- 内容平台审核 agent:策略 skill 常包含自由文本规则与图像审核代码,SkillSpec 发现“仅处理文本”的描述但代码实际调用多模态模型,防止漏审或误审。
局限
- - 检测精度有限:整体 precision 为 61.2%,意味着约四成报告为假阳性,仍需人工复核,限制了全自动部署的实用性。论文明确指出纯文本节点是规范推理的主要瓶颈,对代码节点推理可靠,但自然语言描述密集的技能容易产生语义漂移或错误意图归因,导致漏报与误报并存。
- - 依赖 LLM 推理带来模型偏差与成本:ExpectSpec 与 FactSpec 的生成依赖大模型,不同模型家族表现差异大,生成规范可能包含幻觉或偏差;多视图联合推理和沙箱验证产生较高的 token 与时间开销,难以支撑大规模、实时性的技能质量检测。
- - 实验覆盖面有限:评估仅基于 515 个技能,来自 SkillsBench 和部分热门下载仓库,外部效度不足,无法充分代表多样化的 agent 技能生态;沙箱验证环境简化了外部依赖、网络交互、并发等真实条件,验证通过不能保证在生产环境中零缺陷。