SceneMosaic: 通过混合智能体布局演化实现高效且多样的仿真就绪场景生成
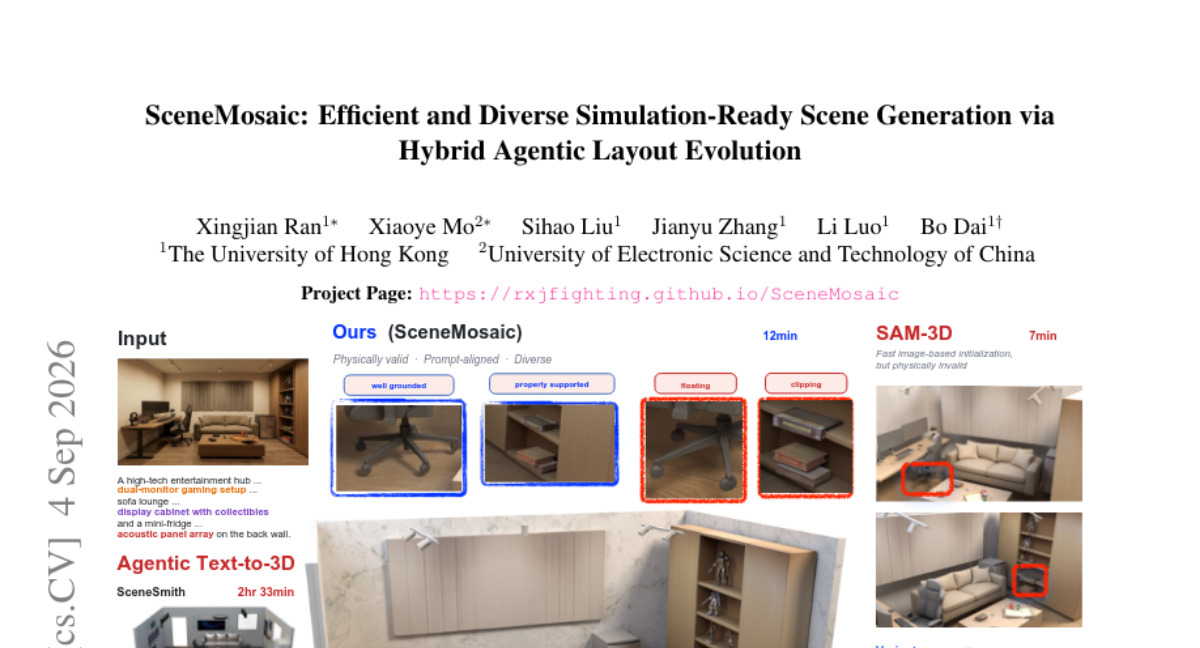
多样且仿真就绪的室内场景对于交互式娱乐和具身 AI 至关重要,但其可扩展生成仍具挑战。最近的基于智能体的文本到 3D 场景管线依赖视觉语言模型(VLM),能生成高保真场景,但需要昂贵的迭代式物体放置与细化。另一主流范式——参数化图像到 3D 场景模型——从 2D 图像学习的强先验中高效生成场景,但往往导致不精确且物理上无效的场景。更重要的是,两种范式都难以针对单一输入输出多样场景,从而难以反映真实场景的动态变化本质。 为此,本文提出 SceneMosaic,一个结合两种范式优点的框架。它从基于图像学习的先验中获得初始候选,随后通过 VLM 智能体 演化结果,确保效率与物理有效性。在演化过程中,SceneMosaic 利用自然场景的局部性,将场景分解为独立局部单元,允许在各单元内分别演化,再通过笛卡尔积组合成全局场景。 在 SceneEval-100 上,SceneMosaic 在语义布局质量上匹敌最强智能体基线,同时实现 24 倍加速,大幅减少物理违规,并获得最高的人工评分。代码已开源:https://github.com/rxjfighting/SceneMosaic。
论文精读
TL;DR SceneMosaic 用图像先验初始化,再由 VLM 智能体分解局部单元进化并通过笛卡尔积组合,高效生成多样且物理有效的室内场景,速度提升 24 倍且人类评分最高。
问题
室内场景生成是 embodied AI 和交互娱乐的关键上游任务,业界需要大量多样且可直接用于物理仿真的场景。
现有方法局限
- agentic text-to-3D 借助 VLM 迭代摆放物体,保真度高但耗时昂贵,单场景需数十次模型调用,难以规模化。
- parametric image-to-3D 从 2D 先验快速生成,但缺乏 3D 物理约束,常出现穿模、悬空等物理违规,且布局多样性不足。
- 两者都难以对同一输入产生足够多样的布局,无法反映真实场景的动态变化。
工程上这意味着必须在推理成本和场景质量之间取舍,缺少一个同时兼顾效率、物理有效性和多样性的统一框架。
为什么这个问题难/重要
- 技术挑战:效率、物理有效性、多样性三个目标相互冲突;自然场景具有局部独立性,需分解并行处理;VLM 的 3D 空间推理能力有限,直接操作全局场景易产生累积误差。
- 业界关注:simulation-ready 场景是机器人学习、游戏开发、数字孪生的基础资源,但手工构建成本极高,自动化生成需求强烈。
行业类比
类似 diffusion model 生成图像时需要平衡采样速度与多样性,室内场景生成需要同时保证布局多样和物理可模拟,否则无法直接用于下游仿真训练。
核心洞察
- SceneMosaic 将参数化图像先验作为初始布局,再由 VLM agent 进行迭代演化,实现高效与物理有效的兼顾。纯 agentic 方法每次生成需大量对象放置与细化步骤,计算开销大;参数化图像到 3D 模型虽快但常产生穿透、漂浮等物理违规。SceneMosaic 混合两种范式,用先验提供合理起点,agent 仅需局部修正,在 SceneEval-100 上达到与最强 agentic 基线相当的语义布局质量,同时 24 倍加速,并大幅减少物理违规。
- SceneMosaic 通过将场景分解为独立局部单元并分别演化,再经笛卡尔积组合,从单一输入产生多样化场景。现有方法对单个输入通常只输出一个确定性结果,无法反映真实场景的动态变化;SceneMosaic 利用自然场景的局部性(如房间中不同家具组合独立),每个单元可产生多个变体,最后组合出多个全局布局,并通过 novelty-aware 距离和贪心选择保证多样性,在人类评估中获得最高评分。
- SceneMosaic 引入物理仿真稳定化与 critic-actor 代理架构,提升布局物理有效性并降低 agent 操作复杂度。在演化过程中,物理仿真用于稳定物体姿态,避免违反物理约束;critic-actor 代理(critic 评估布局,actor 执行修改)在正射投影 2D 抽象上操作,而非直接处理 3D 视角,减少了空间推理难度,使 agent 迭代更快收敛,同时保持物理合理性。
方法
输入与初始化
SceneMosaic 以室内场景的 文本描述或参考图像 为输入,先通过 parametric image-to-3D 先验模型生成一张初始候选布局,获得对象类别、位置与朝向的粗略估计。此步骤复用 2D 图像先验的效率,避免从零开始的多轮 agent 放置。
关键模块
- 场景重建与结构化:对初始布局进行 object-centric 重建,并依据对象间的空间关系构建关系图,将场景划分为相对独立的局部单元。
- Agentic 布局演化:针对每个局部单元,使用 Critic-Actor 双 VLM agent 迭代修正布局。Critic 通过正交 2D 空间抽象判断物理违规与语义不合理之处,Actor 结合批评与短期记忆生成改进方案;physics-based stabilization 工具保证无穿透与支撑稳定。
- 多样性驱动合成:对每个局部单元保留多个候选变体,借助 Cartesian product 组合全局场景,计算
novelty-aware scene distance并用 greedy selection 筛选出语义质量与多样性平衡的场景集合。
输出
最终输出一组 simulation-ready 室内场景,满足物理仿真约束,并覆盖输入条件下多种合理布局。
与同类方法相比,SceneMosaic 将 VLM agent 的迭代搜索限制在局部单元内,通过组合式多样性避免了全局场景级的昂贵重复优化,在保持 agentic 精度的同时获得约 24x 加速。
实验
实验设计与关键发现
论文在 SceneEval-100 数据集上评估 SceneMosaic,对比两类基线:基于 VLM 的 agentic 文本到 3D 场景管线,以及参数化 image-to-3D 场景模型。定量指标涵盖语义布局质量、物理违规数量、生成速度与人类主观评分。
核心发现:SceneMosaic 在语义布局质量上与最强的 agentic 基线相当,但实现了 24 倍加速;大幅减少物理违规,并在人类评分中获得最高分。这验证了混合范式的有效性:利用图像先验获得高效初始候选,再通过 VLM agent 演化确保物理有效性与多样性。
关键设计解读:方法将场景分解为独立局部单元,分别演化后通过 笛卡尔积 组合,既保留局部合理性又生成全局多样结果。相比纯 agentic 方法,避免了逐物体迭代放置的高成本;相比纯参数化模型,解决了物理无效和多样性不足问题。消融研究表明图像初始化、物理模拟、正交 2D 抽象和局部单元分解均对性能有贡献。工程上,该框架将先验强归纳与 agentic 灵活性解耦,适合需要快速生成大量仿真就绪室内场景的交互娱乐与具身 AI 应用。
行业影响
落地场景
SceneMosaic 面向 仿真就绪室内场景 生成,可直接用于:
- 家具电商:输入“北欧风客厅”,输出多个物理有效且布局多样的房间,用于虚拟样板间与产品组合推荐。
- 游戏 / 虚拟制作:快速搭建大量室内关卡或场景资产,替代手工摆放。
- 具身智能:为机器人导航、操作任务批量生成不同布局的仿真训练环境,提升泛化能力。
- 室内设计工具:根据客户图片或文字需求,生成候选布局供选择。
商业价值
- 降本增效:相比纯 VLM agent 管线,SceneMosaic 在 SceneEval-100 上达到同等级语义布局质量,但速度提升 24x,显著降低推理成本与等待时间。
- 多样性提升:通过局部单元组合(Cartesian product),单输入可产出大量物理有效变体,改善用户体验和 A/B 测试效率。
- 物理有效性:减少穿透、悬空等违规,降低人工修复成本,提高下游仿真可用性。
与现有产品 / 工作流接口
- 可作为 插件或微服务 集成到现有 3D 内容管线:接收文本/图像,输出结构化场景描述(物体类别、位姿、布局图)。
- 可对接现有 物体生成模型(如 Objaverse 检索、扩散模型)填充几何与材质,或导入 游戏引擎 / 仿真器(Unity、Isaac Sim)进行渲染与交互测试。
- 其局部单元分解支持并行演化,适合部署在 GPU 集群或 serverless 函数上,便于与云渲染、API 服务结合。
局限
- **图像先验依赖**:SceneMosaic 的初始候选来自参数化图像到 3D 场景模型,其多样性受限于该模型在训练数据中学习到的先验分布。对于训练集中罕见的场景类型、风格或非典型布局,初始空间可能覆盖不足,后续 VLM 演化虽能局部调整,但难以突破整体结构约束。此外,局部单元分解假设场景可拆分为相对独立的子区域,这在实际中可能不成立,例如紧凑型小空间内家具之间存在强耦合,导致组合后的全局场景仍可能出现语义或物理冲突。
- **物理有效性评估有限**:论文在 SceneEval-100 上验证了物理违规的减少,但该数据集的物理约束可能只涵盖基础的碰撞、支撑和可达性等,未涉及更复杂的物理交互(如柔性物体、堆叠稳定性、门开合等)。同时,基于 VLM 的 critic-actor 演化依赖于视觉语言模型的判断,可能产生不稳定的修正,且跨单元约束提取的完备性未得到严格证明,某些隐式约束可能被遗漏,导致生成场景在真实仿真器中仍然不可用。
- **计算开销与开放域灵活性折中**:相比纯参数化方法,SceneMosaic 引入了多轮 VLM 代理演化,虽然相比纯 agentic 方法有 24 倍加速,但相比单次前向的生成模型仍存在额外延迟和推理成本,且 VLM 的调用可能带来不确定性和 token 成本。与全开放域的 agentic 方法(如直接由文本生成任意布局)相比,SceneMosaic 受限于图像先验的输出空间,对于需要高度自定义或与训练分布差异大的场景,其灵活性可能不足,无法像纯语言驱动方法那样自由探索新颖布局。