RECAP-Forcing: 保留内容外观以实现长视频生成
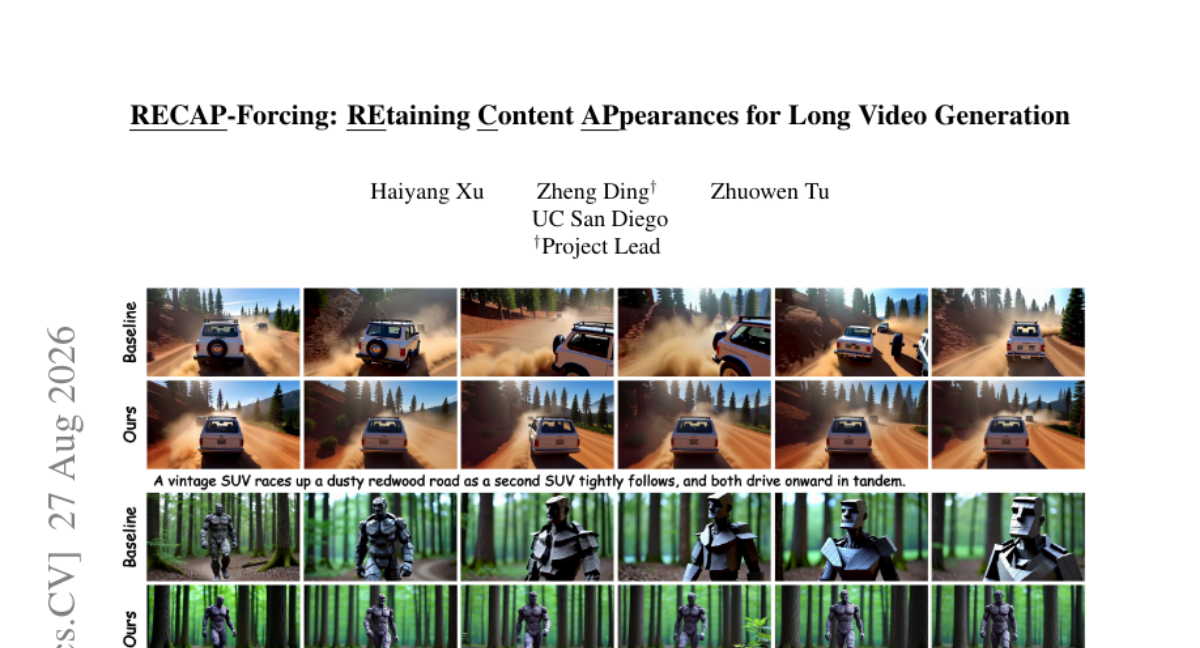
长自回归视频生成面临一个根本性的记忆挑战:在有限的注意力窗口下,模型必须决定从不断扩展的历史中保留哪些信息。现有方法按时间组织记忆,保留近期帧的同时压缩或丢弃较旧的帧。我们提出 RECAP-Forcing,按外观新颖性组织记忆。长视频不仅仅是帧序列,更是主体、物体和场景的不断演化组合,其身份必须随时间保持一致。我们通过在新内容首次出现时保留其相关的 KV cache(如进入的主体、去遮挡区域和新引入的场景)来组织记忆,优先考虑新颖性而非时间邻近性。记忆规模应与新引入的内容量成正比,而非视频长度。这种外观索引的记忆使长程一致性成为记忆结构的显式属性。 我们的框架在单一原则下统一了两种机制:在视频开头,当所有可见内容均为新颖时,注意力汇聚(attention sink)保留初始场景;随着视频演进,基于光流的新颖性库将同一原则扩展,选择性地保留新揭示的内容。作为一种无需训练、无额外可学习参数的推理方法,RECAP-Forcing 在多个强基线上持续提升视觉质量和语义保真度,并优于现有记忆方法。
论文精读
TL;DR RECAP-Forcing 提出按外观新颖性而非时间顺序组织长视频生成的 KV 缓存,仅保留新出现内容的注意力记忆,使记忆随新内容而非视频长度增长,无训练、无额外参数,显著提升长视频一致性与质量。
问题
长视频自回归生成 的核心挑战在于:有限注意力窗口无法覆盖完整历史,模型必须在持续增长的帧序列中选择保留哪些信息。当前领域关注如何在推理阶段高效管理 KV cache,以维持长程时空一致性。
现有方法普遍按时间序组织记忆:保留最近若干帧的完整 token,对更早内容做压缩或随机丢弃。这种策略存在明显局限:1)早期出现的主体或场景一旦被压缩,其精确外观特征可能永久丢失;2)当该主体在后期重新进入画面时,模型缺乏可参照的原始表观信息,导致身份漂移;3)记忆规模随视频长度线性增长,即使内容重复,缓存仍不断膨胀,未真正利用内容冗余。
该问题的难点在于:新颖性判定必须在无监督在线场景下完成,既不能依赖额外标注,也不能引入可学习参数;同时,记忆选取需与自回归生成机制耦合,保证 KV cache 读写开销可控。业界对长视频生成(虚拟角色、影视预演、游戏过场动画等)的身份一致性要求极高,因此该问题具有直接工程价值。
行业类比:类似长上下文 LLM 的 KV cache 压缩问题,但视频生成还必须处理空间遮挡与重新显露,对记忆的组织粒度提出更高要求。
核心洞察
- RECAP-Forcing 的核心是将长视频生成的记忆组织从时间近因切换为外观新颖性,即只保留新出现内容的 KV cache,而非近期帧。与现有方法按时间滑动窗口或压缩旧帧不同,该工作让记忆规模随视频的内容增量(如新主体、去遮挡区域、新场景)而非时长线性增长,从根本上缓解长视频生成中的身份漂移,且训练无关,可直接接入现有自回归视频模型。
- 该方法将 attention sink 和光流新颖性银行统一在同一原理下:初始场景作为首个新颖性记忆,后续帧通过光流检测新揭示区域并选择性入池。现有记忆方法往往分别处理初始锚定与后续压缩,缺乏统一原则;RECAP-Forcing 把长期一致性显式化为记忆结构属性,使模型在有限注意力预算下自动保留对身份维持最重要的 token,无需额外参数,工程上可低成本提升多个 baseline 的视觉质量和语义保真度。
方法
输入与问题设定
自回归视频模型逐块生成视频,每步产生当前块的 KV cache,但受限于有限注意力窗口,无法保留全部历史。输入为已生成帧序列及其对应 KV cache,输出为外观索引的记忆结构,用于后续生成步的注意力补充。
关键模块:外观新颖性记忆
RECAP-Forcing 将记忆组织从时间索引改为外观索引,核心是判断“该 token 是否引入新外观内容”:
- Attention sink(首帧阶段):初始场景所有内容均为新颖,保留整个首帧的 KV cache 作为
attention sink,作为外观锚点,稳定后续生成中的背景与全局风格。 - 光流新颖性银行(后续帧):对每帧计算光流,识别新出现区域——如主体进入画面、去遮挡区域、新场景元素。仅将其对应 token 的 KV cache 存入 bank,随生成逐步累积。选择标准是“视觉内容首次可见”,而非时间上的近期。
输出与推理流程
每个生成步,模型在常规滑动窗口 KV 之外,可额外 attends 到外观记忆 bank 中的 KV,使长期身份与场景一致性成为显式结构特性。由于无需训练、无新增参数,可直接应用于不同基线。
原作者观点:记忆规模应随新引入内容量增长,而非视频长度。
与同类方法差异
现有方法(如时间压缩或 rolling buffer)按时间顺序保留最近帧并压缩旧帧;RECAP-Forcing 按外观新颖性组织 KV cache,把长期一致性从“隐式拟合”变为“显式存储约定”。
实验
实验设计
论文通过 定量结果、消融研究、人类研究 和 定性结果 四个维度验证 RECAP-Forcing 的有效性。评估聚焦于长视频生成中的 视觉质量 和 语义保真度,与多个强基线及现有记忆方法进行对比。由于论文未披露具体数据集和量化指标,此处不列出数值。
关键发现
RECAP-Forcing 作为训练免费的推理方法,在多个强基线模型上一致提升视觉质量与语义保真度,并优于现有基于时间组织的记忆方法。其核心机制——按外观新颖性组织 KV cache——使记忆规模与新增内容量成正比,而非视频长度,从而缓解长视频生成的记忆瓶颈。
与基线对比解读
传统记忆方法优先保留最近帧,丢弃或压缩旧帧,导致长程一致性依赖隐式学习。RECAP-Forcing 显式将记忆索引于 外观新颖性,通过 首帧注意力 sink 和 光流新颖性 bank 保留新出现的内容(如新主体、去遮挡区域、新场景),使长程一致性成为记忆结构的固有属性。这种结构性差异是其在长视频场景下超越基于时间记忆方法的关键。
行业影响
落地场景
RECAP-Forcing 直接适用于自回归长视频生成管线,尤其适合需要长时间角色/物体一致性的场景:
- 电商产品视频:自动生成多镜头服装展示或产品测评视频,模特外观、产品纹理在长序列中保持稳定,避免每几秒更换形象的违和感。
- 教育内容生产:虚拟讲师在数十秒到数分钟的课程视频中维持一致身份,减少人工剪辑和重录。
- 游戏/虚拟制片:预演长镜头中 NPC 或交互物体外观连贯,降低后期修复成本。
商业价值
主要落在降本与体验提升两条线:
- 降低推理成本:记忆规模随新内容量而非视频长度增长,长视频生成的内存增长更可控,可直接降低 GPU 显存占用与单视频推理费用。
- 减少人工后处理:一致性提升意味着更少的人工重生成或手动编辑,缩短生产周期。
- 提升用户体验:长视频观看体验更自然,减少因外观漂移导致的跳出或差评。
与现有产品 / 工作流的接口
RECAP-Forcing 是训练免、无新增参数的推理时方法,可作为现有自回归视频生成服务(如基于 block-wise 生成 + KV cache 压缩的框架)的插件:
- 直接替换或增强现有记忆模块(如 sliding window、temporal compression),无需重训模型。
- 可集成到如 vLLM 等推理引擎的 KV cache 管理自定义层,或作为 Hugging Face 模型推理管线的后处理步骤。
- 与光流计算模块(如 RAFT)配对,只需在生成过程中实时计算帧间光流,额外开销可控。
局限
- **依赖光流估计准确性**:方法使用光流检测新揭示内容(如去遮挡区域),光流估计在快速运动、严重遮挡、纹理贫乏或运动模糊场景中可能不可靠,导致新颖性判断错误——要么保留无关区域的 KV cache,要么遗漏关键新内容。此外,光流计算本身引入额外推理开销,虽然论文声称训练无关,但实际部署时可能增加延迟,影响长视频生成的实时性。未来可考虑用更鲁棒的运动表征或学习式新颖性检测替代光流。
- **训练无关的固有表达瓶颈**:RECAP-Forcing 仅重新组织现有 KV cache,不新增可学习参数,因此无法扩展模型记忆容量或改进底层模型的长程推理能力。若底层视频模型本身缺乏稳定的身份追踪或场景理解,仅靠记忆选择可能无法根本解决长期遗忘(如主体外观漂移)。相比需要训练的记忆压缩方法(如可学习记忆槽或记忆蒸馏),本方法的改进上限受限于预训练模型的能力。
- **评估维度与泛化性有限**:实验主要报告视觉质量和语义保真度,但长视频生成中叙事一致性、动作长期连贯、风格与光照稳定性等维度未被充分量化。人类研究可能规模有限,且评测数据可能局限于特定场景(如人物、物体运动),对任意长度、复杂镜头切换或高度动态场景的泛化性尚待验证。此外,方法仅针对自回归 Transformer 架构,对扩散模型或其他生成范式的适用性未知。