PonderPounce: 预训练 MLLM 作为机器人控制的情景上下文引擎
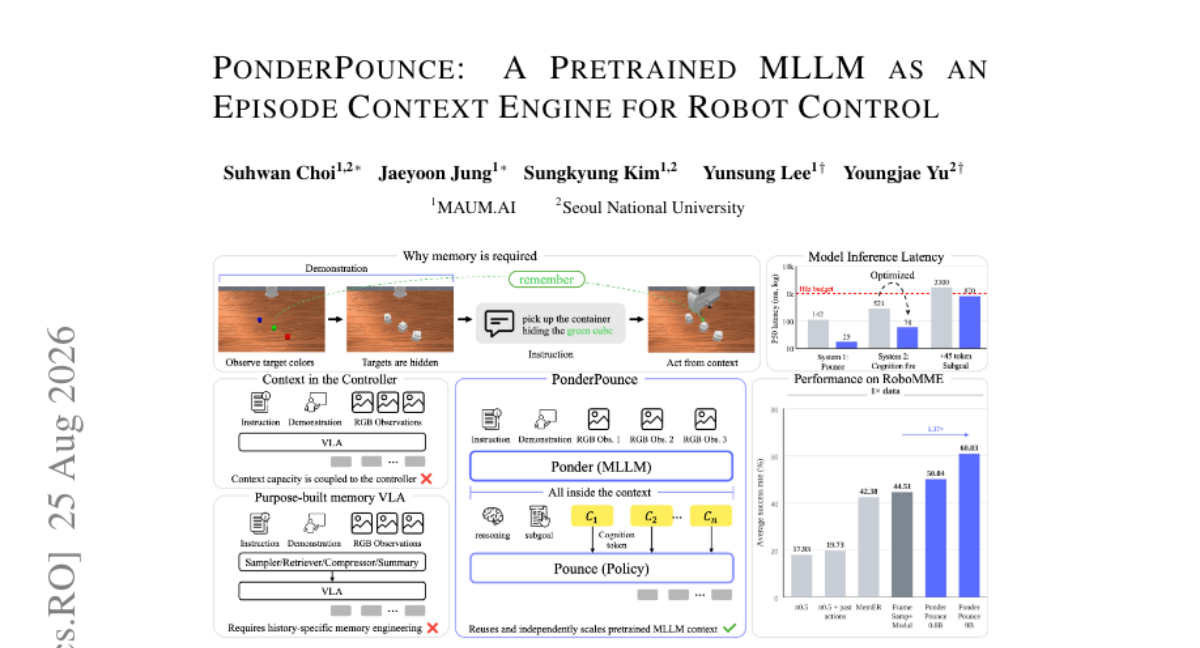
多模态大语言模型(MLLMs)能整合长视觉历史、在部分可观测条件下推理、并从少数示例推断行为。然而,视觉-语言-动作(VLA)模型通常继承预训练表示,却未利用这种上下文能力作为回合记忆。依赖记忆的策略通过专用历史机制解决这一差距。 PonderPounce 重新利用 MLLM 的原生因果上下文作为机器人记忆。Ponder(System2 MLLM)在原生因果上下文中累积回合观测、演示和先前认知,并生成子目标文本和演示推理供内部使用。Pounce(System1 VLA)直接接收当前观测、指令和本体感觉;通过 Ponder--Pounce 接口 异步仅接收最新连续认知令牌及其年龄。两者端到端联合训练,无需专用记忆模块或单独桥接预训练。优化后的服务实现 78ms 的认知刷新 p50 延迟和 25ms 的动作模型调用延迟,支持 20Hz 动作回放。 在 RoboMME 上,使用基础规模训练数据,PonderPounce 在相同 Pounce 架构和接口下达到 60.83%(9B)和 50.04%(0.8B),而 FrameSamp+Modul 为 44.51%,当前观测 π{0.5} 为 17.93%。使用 9 倍数据,达到 75.54%,而 FrameSamp+Modul 为 57.88%。在 RoboCasa-DC 上,同一接口仅从动作监督学习,达到 12.5%,而最强已发表演示条件基线为 11.6%;当认知被学习到的空状态替换时降至 8.6%。
论文精读
TL;DR PonderPounce 复用预训练 MLLM 的原生因果上下文作为机器人情节记忆,通过异步认知 token 连接 System2 推理与 System1 动作模型,无需专用记忆模块即大幅提升长程操控性能。
问题
机器人控制领域近期关注 VLA (Vision-Language-Action) 模型:它们将预训练 MLLM 的表征直接用于端到端动作预测,以同时获得指令理解、视觉感知与长程任务执行能力。
现有方法存在以下局限:
- 主流 VLA 只把 MLLM 当作视觉-语言特征提取器,未利用其原生因果上下文进行 episode 级记忆。
- 当前观测式策略在部分可观测或需要回忆历史状态的任务中性能退化,也难以从少量演示推理行为。
- 记忆依赖型策略多引入独立历史编码器、专用记忆模块或额外 bridge 预训练,数据与训练成本高,且难保留预训练 MLLM 的语境推理与演示泛化能力。
该问题难在:需在不引入专用记忆架构的前提下,把 MLLM 原生因果上下文训练成可用的 robot memory,同时满足 20Hz 动作回放的低延迟约束。System 2 推理与 System 1 执行之间的异步接口、认知 token 刷新频率与 staleness 控制、端到端 joint training 的稳定性,均无成熟方案。业界对长程操作、稀疏奖励下的演示适应与实时部署有明确需求,该问题处于 VLA、memory 机制与推理系统优化的交叉点。
类似编程助手中利用大模型原生长上下文作为会话记忆、避免外挂检索库;这里把推理上下文直接变成机器人策略的隐性工作记忆,不额外构建 memory store。
核心洞察
- PonderPounce 将预训练 MLLM 的原生因果上下文直接用作机器人情节记忆,而非构建专用记忆模块。这跳过了 FrameSamp+Modul 等基线使用的固定帧采样与模块化历史编码,充分利用 MLLM 在长视觉历史整合与少样本推理上的预训练能力。端到端联合训练 Ponder 和 Pounce,无需额外桥接预训练,避免表征鸿沟,同时以 78ms 认知刷新延迟支持实时控制,在 RoboMME 上显著超越当前观察基线 π0.5。
- Ponder--Pounce 接口通过异步传递最新连续认知 token 及其 age,实现 System2 推理与 System1 动作闭环的解耦。与常规 VLA 将历史帧简单拼接或依赖外部记忆机制不同,Pounce 只接收一个带新鲜度信息的连续 token,隐式建模认知时序与不确定性,同时将动作模型延迟控制在 25ms,保持 20Hz 控制频率。该机制在 RoboCasa-DC 上仅靠动作监督即可学习,替换为学习到的 null state 后性能降至 8.6%,证明认知通道本身携带可泛化的任务信息。
方法
输入与模块
PonderPounce 由两个异步协作的模型组成:Ponder(System 2 MLLM)与 Pounce(System 1 VLA)。
- Ponder 输入:完整的 episode 观测历史、人类演示(demonstrations)以及模型自身的先前认知(prior cognition)。这些信息被直接累积到 MLLM 的原生因果上下文(native causal context)中,无需额外记忆模块。
- Pounce 输入:当前观测、语言指令和本体感受(proprioception)。此外,通过 Ponder–Pounce 接口,Pounce 异步接收 最新连续认知 token(continuous cognition token)及其 年龄(age),年龄用于表征 token 的新鲜度,以应对异步调度带来的延迟。
关键模块与接口
- Ponder 在原生上下文中进行 System 2 推理,可生成子目标文本(subgoal text)和演示推理(demonstration reasoning)作为内部信号,并将最终认知压缩为一个连续 token 传递给 Pounce。
- Pounce 作为快速动作模型,仅接收当前观测和最新认知 token,输出机器人动作,支持 20 Hz 回放。
训练与调度
联合端到端训练 Ponder 与 Pounce,不引入专用记忆模块或单独的桥接预训练。训练中使用 schedule sampling 和梯度缩放等技巧,并辅以子目标与演示推理的监督信号(具体实现见论文附录 A)。推理时采用异步调度:Ponder 的认知刷新延迟 p50 为 78 ms,Pounce 动作调用延迟 25 ms,确保实时性。
与同类方法的差异
不同于依赖 purpose-built 记忆机制或跨模态桥接预训练的方法,PonderPounce 直接复用 MLLM 的原生因果上下文作为机器人 episodic memory,实现推理与控制的端到端联合训练。
实验
实验设计
PonderPounce 在 RoboMME 与 RoboCasa-DC 两个基准上评估。RoboMME 提供长程任务与分步推理标注,比较不同数据规模(base-scale 与 9x)下模型效果。RoboCasa-DC 则关注仅动作监督条件下的学习,验证认知接口是否必须依赖文本监督。所有模型共享同一 Pounce 架构与 Ponder–Pounce 接口,仅改变认知来源(预训练 MLLM 上下文 vs 专用模块 vs 当前观测)。
关键发现
- RoboMME base-scale:PonderPounce 9B 达到 60.83%,0.8B 为 50.04%,均显著超过 FrameSamp+Modul 的 44.51% 与仅当前观测 π_{0.5} 的 17.93%。
- 数据扩展至 9x 后,PonderPounce 提升至 75.54%,对比 FrameSamp+Modul 仅 57.88%,差距扩大。
- RoboCasa-DC:仅动作监督下 PonderPounce 达 12.5%,超过最强已发表演示条件基线 11.6%;将认知替换为学习到的 null state 后降至 8.6%,证明认知通道的有效性。
- 服务优化:认知刷新 p50 78ms,动作模型调用 25ms,支持 20Hz 实时动作播放。
与基线对比解读
FrameSamp+Modul 采用帧采样加专用记忆模块,但受限于固定历史窗口;PonderPounce 直接复用 MLLM 原生因果上下文,在长程依赖上更具优势。在数据规模扩大时,PonderPounce 的收益更明显,表明预训练上下文容量可迁移至控制任务。RoboCasa-DC 结果显示,即使没有文本子目标监督,认知 token 仍能承载有用信息,避免为每个任务设计显式记忆结构。
行业影响
落地场景
PonderPounce 的架构适用于需要长时程记忆与实时控制的机器人场景,例如电商仓储的拣选/分拣机器人、家庭服务机器人、以及自动驾驶中的决策规划。其利用预训练 MLLM 作为情景记忆引擎,减少对专用记忆模块的依赖,可快速部署到已有 VLA 系统。
商业价值
- 降低开发成本:复用预训练 MLLM,无需额外 bridge 预训练或专用记忆网络,减少训练数据与工程投入。
- 提升任务成功率:在 RoboMME 上,9B 模型 base-scale 达到 60.83%,较 baseline 提升明显;9x 数据达到 75.54%,带来更可靠的自动化,减少人工干预。
- 延迟支持实时控制:p50 认知刷新 78ms、动作模型 25ms,可支撑 20Hz 动作播放,满足商业化实时性要求。
跟现有工作流的集成
- 可作为已有 VLA 模型(如 π0.5 类)的增强模块:保留现有 Pounce 架构,仅通过异步接口注入认知 token,无需重构动作解码器。
- 支持从动作监督单独学习(RoboCasa-DC 上 12.5% vs 11.6% 的 demonstration-conditioned baseline),降低对昂贵推理标注的依赖。
- 推理优化后,可部署在边缘设备:Ponder 与 Pounce 异步运行,适合与 ROS 或云端控制栈结合。
局限
- Ponder 生成子目标文本和示范推理需要额外标注监督,这限制了方法在缺乏人工推理标注的数据集上的可扩展性;且推理内容完全依赖预训练 MLLM 的因果上下文能力,低质量或过时的 MLLM 权重可能导致认知 token 语义模糊。此外,Pounce 仅接收单个连续认知 token,虽然延迟极低,但该 token 的信息带宽有限,可能无法充分表达复杂、多步的长期规划或环境变迁,从而在高度非马尔可夫任务中限制策略性能。
- 实验仅在仿真基准 RoboMME 和 RoboCasa-DC 上开展,真实机器人部署面临的传感器噪声、动态干扰和实时通信延迟未得到验证。异步认知刷新导致的 staleness 虽被分析,但在快速变化任务中,陈旧认知 token 可能导致动作选择滞后;同时,性能提升对训练数据规模敏感:9x 数据下 9B 模型达 75.54%,但 base-scale 下 0.8B 模型仅 50.04%,数据受限时优势可能收窄。
- 与显式记忆模块相比,PonderPounce 完全依赖 MLLM 原生上下文长度,长时程任务可能遭遇上下文窗口溢出或注意力稀释,且未探索动态截断或检索增强的混合方案。此外,仅报告 9B 和 0.8B 两种 Pounce 规模,认知 token 在不同 VLA 骨干间的泛化性未知;端到端联合训练 System1/System2 也引入优化复杂性,可能影响训练稳定性或增大调参成本。