交接税:LLM 代理中延续非原生轨迹
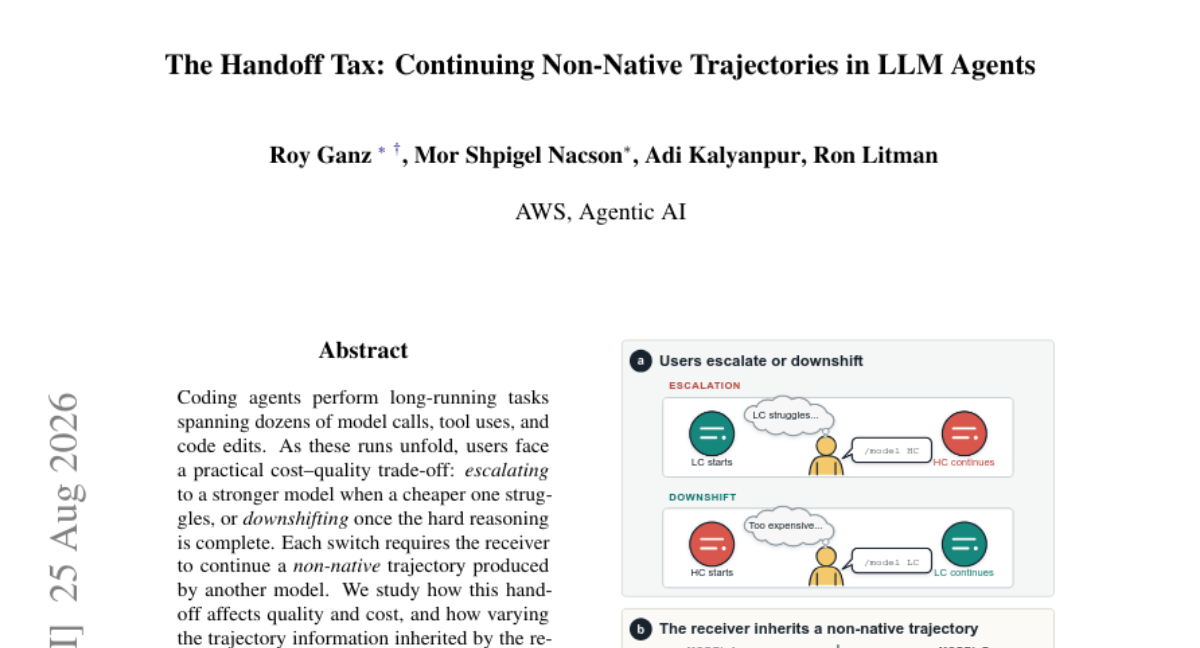
编程代理执行长时任务,涵盖数十次模型调用、工具使用和代码编辑。运行过程中,用户面临成本与质量的权衡: 当廉价模型遇到困难时升级到更强模型,或在困难推理完成后降级。每次切换都要求接收模型继续由另一模型产生的非原生轨迹。 我们研究交接对质量与成本的影响,以及接收者继承的轨迹信息变化如何改变结果。使用来自 Claude 与 GPT 家族的廉价低能力(LC)与高成本高能力(HC)模型配对,改变交接方向、时机与接口,比较 完整轨迹转移、压缩 与 轨迹移除(同时保留仓库状态)。 结果表明,在两个模型家族中,完整轨迹升级 仅恢复不到 LC 到 HC 质量差距的一半,却带来显著成本溢价。我们将这种成本-质量惩罚称为 交接税。相比之下,降级 提供了有利的成本-质量平衡点。有趣的是,首选接口随方向反转: 减少 LC 模型轨迹信息可提升升级质量,而移除 HC 模型轨迹则会降低降级质量。
论文精读
TL;DR 论文量化了 LLM agent 模型切换的 handoff tax:升级时继续非原生轨迹仅恢复不足一半质量差距且成本昂贵,降级则更划算;轨迹信息价值随方向反转。
问题
问题背景
长时运行 LLM Agent 中,用户需要在成本与质量之间动态权衡,切换不同能力模型已成为实际需求。
现有方法局限
主流做法是全程使用单一模型,要么高成本强模型(HC),要么低成本弱模型(LC)。实践中虽有人尝试 mid-run 切换,但缺乏系统指导:切换方向(升级/降级)、切换时机、传递轨迹信息的方式(完整 trajectory / compaction / 丢弃)对质量和成本的影响未明。尤其接收模型继续非自身产生的轨迹时,可能因推理风格不匹配或错误累积而效果打折,现有工具链仅提供简单上下文继承,未考虑模型间差异性。
为什么难/重要
多模型接力是复杂推理任务中降本增效的关键路径,但切换本身引入额外开销与不确定性。模型间的推理风格、上下文利用方式差异大,如何量化“切换税”并设计最优切换策略是尚未解决的研究问题。业界对可控成本下的质量保障高度关注,任何节省推理成本的方案都有直接落地价值。
行业类比
类似于推荐系统中召回-粗排-精排的级联架构,若中间阶段输出的候选分布与下一阶段模型训练分布不一致,精排模型性能会显著下降,需要重新校准或传递额外信息。
核心洞察
- Handoff Tax 的提出:当低能力模型升级到高能力模型时,完整继承前序轨迹只能恢复不到一半的质量缺口,但每步计算成本显著高于直接以高能力模型重新开始,这种成本-质量损失称为 Handoff Tax。该发现独特之处在于,它首次量化了模型切换的隐性代价,并指出直接沿用非原生轨迹可能是一种次优策略,为 Agent 系统中的模型选择与成本控制提供了反直觉的实证依据。
- 轨迹信息的价值随切换方向反转:从低能力升级到高能力时,移除低能力模型的轨迹信息反而提升质量;而从高能力降级到低能力时,保留完整轨迹对质量至关重要。这与“更多上下文总是更好”的常见假设相悖,揭示了模型间轨迹的非对称性,提示设计 Handoff 接口时应根据切换方向动态调整传递的信息内容,而非采用统一策略。
方法
输入
选择长时程 coding agent 任务,覆盖 SWE-bench Verified、Lost in Conversation、BrowseComp。每条轨迹由多次模型调用、工具使用和代码编辑构成。
关键模块
- 模型配对与方向:将模型分为 LC(低成本低能力)与 HC(高成本高能力),覆盖 Claude 与 GPT 家族。切换方向为
escalation(LC→HC)与downshift(HC→LC)。 - 切换时机:通过预校准的 switch point 在轨迹中定位切换位置,并区分 early/late switch 与任务难度。
- 轨迹继承接口:接收方获得不同信息:full-trajectory 完整继承前序轨迹;compaction 压缩轨迹;trajectory removal 移除轨迹但保留仓库状态。
- 评估:在 switched subset 上比较成功率与 API 成本,用 normalized metrics 量化 handoff tax(升级时的成本-质量惩罚)与 downshift 的成本-质量优势。
输出
得到不同方向、时机、接口下的质量恢复比例与成本开销,揭示轨迹信息价值的方向依赖性。
与同类方法差异:不同于仅比较模型或更换系统提示的工作,本研究将“继续另一模型轨迹”本身作为实验变量,系统改变继承接口,从而分离轨迹内容对接收方性能的影响。
实验
实验设计
研究在 SWE-bench Verified、Lost in Conversation、BrowseComp 等基准上模拟编码 agent 长时任务,使用 Claude 与 GPT 家族的 LC / HC 模型对,改变切换方向(LC→HC escalation,HC→LC downshift)、切换时机与接口(full-trajectory transfer、compaction、trajectory removal,同时保留 repository state)。评估在切换子集上的质量与 token 成本,采用 normalized metrics。
关键发现
- Raw escalation 仅能恢复 LC-HC 质量差距的 一半以下,却带来显著成本溢价,论文称之为 handoff tax。
- Downshift 提供更优的成本-质量平衡:HC 轨迹为 LC 提供了更好的起点。
- 接口影响随方向反转:escalation 时减少 LC 轨迹信息(如 compaction 或 removal)可提升质量;downshift 时移除 HC 轨迹会降低质量。
- 任务难度更高时,escalation 的相对价值上升,但成本依然高昂。
与基线对比解读
基线包括 直接从 HC 开始或一直使用 LC。raw escalation 在某些情形下甚至劣于直接用 HC 重启,因为非本机轨迹中的错误或低效推理可能误导接收模型。compaction 或 removal 通过选择性丢弃低质信息部分减轻此问题,但牺牲上下文连续性。downshift 的优势源于 HC 轨迹的高信息密度,使 LC 能在已探索的正确路径上继续,降低重新推理成本。工程实践 应针对切换方向设计不同的轨迹传递策略,而非统一接口。
行业影响
落地场景
多模型协作的 LLM Agent 系统(如编码助手、任务自动化平台、企业级数据分析代理)可在长任务中根据难度动态切换模型。论文量化的 Handoff Tax 指导模型切换决策:当低能力模型卡住时,是继续其轨迹升级还是重启,直接关系到任务完成率与推理成本。
商业价值
- 降本:避免无效升级(全轨迹升级只恢复不到一半质量差距但成本显著),通过优化切换策略可节省大规模推理开支。
- 增收/体验:提高任务成功率,减少用户等待和重试,提升自动化服务的可靠性与客户满意度。
- 支持 Pareto 优化:在成本与质量之间找到更优平衡点,为企业提供可操作的模型路由策略。
跟现有产品/工作流的接口
可集成到 LangChain / AutoGen / LlamaIndex 等编排框架,作为 handoff 策略模块 或模型路由中间件。具体接口包括:
- 定义标准化的 handoff protocol,例如轨迹传递、压缩、丢弃选项。
- 接入现有 agent 循环,在切换点调用策略引擎决定方向与接口。
- 与企业 MLOps 平台结合,监控成本质量指标,动态调整切换阈值。
具体 use case:
- 电商平台的商品描述生成流水线:低端模型生成初稿,高端模型仅对关键片段润色(降级方向减少不必要成本)。
- 金融文档分析代理:低端模型预处理摘要,高端模型做合规判断,根据任务难度动态升级但避免全轨迹继承。
局限
- **任务与模型覆盖有限**:实验主要基于编码代理任务(SWE-bench Verified、Lost in Conversation)和两个专有模型家族(Claude、GPT),虽然作者在“Beyond the Coding-Agent Setting”中尝试扩展到浏览和对话场景,但结论的泛化性仍受限于特定任务结构和模型行为。开源模型或不同规模的模型可能表现出不同的轨迹敏感性和交接成本,这限制了“交接税”作为普遍规律的适用性。
- **切换时机非自适应**:研究中的切换点通过预定义规则(如固定步数或基于难度校准)确定,而非模拟真实用户根据代理中间状态、信心或成本预算进行的动态决策。实际部署中,用户或编排系统可能依据更丰富的信号(如测试通过率、困惑度、剩余预算)选择切换时机,这可能显著影响交接效果,导致论文中报告的定量结果与真实场景存在偏差。
- **交接接口设计空间未穷尽**:论文比较了全轨迹、压缩和轨迹移除三种接口,但轨迹压缩的具体实现可能过于粗糙,未能充分探索更精细的总结、选择性关键信息保留或接收方引导(如让 HC 模型先阅读 LC 轨迹再生成计划)等方法。不同压缩策略或提示设计可能改变交接质量,而论文未对这些变体进行系统对比,因此结论中“减少 LC 轨迹信息提升升级质量”可能高度依赖于所使用的压缩方法。