Rubrics 作为自演进 UI 到代码生成中的视觉修复上下文
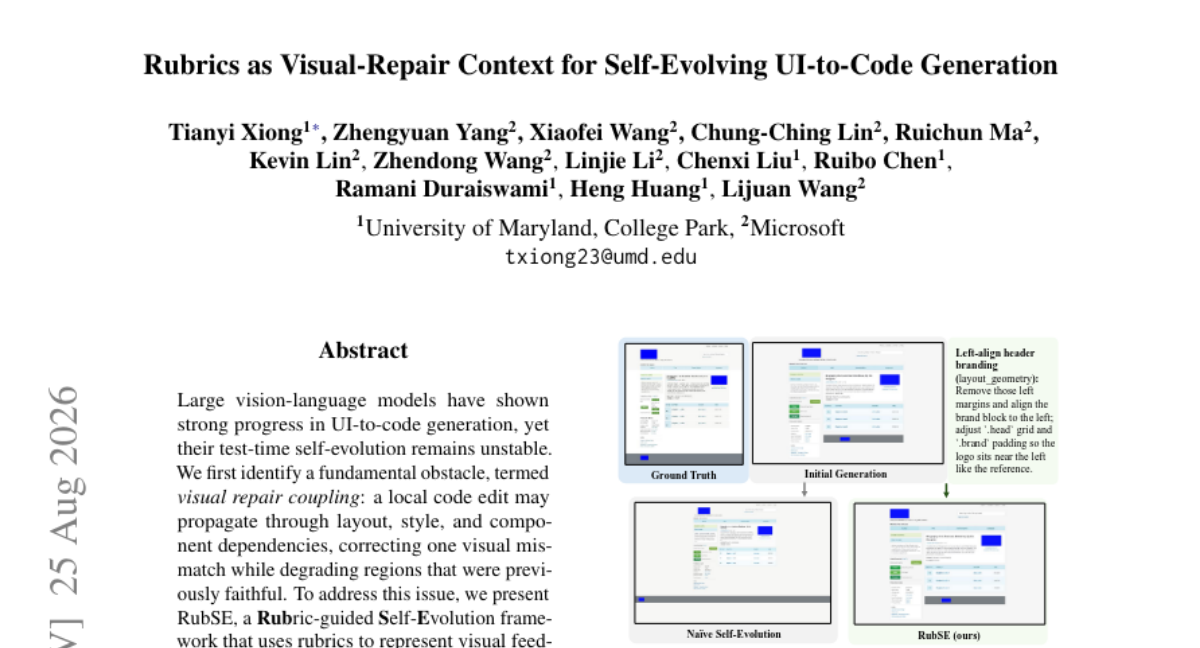
大视觉语言模型在 UI 到代码生成方面表现出强劲进展,但其测试时自演进仍不稳定。我们首先识别出一个根本障碍,即视觉修复耦合:局部代码编辑可能通过布局、样式和组件依赖传播,在纠正一处视觉失配的同时破坏原本忠实的区域。 为解决这一问题,我们提出 RubSE,一个基于评分细则引导的自演进框架。该框架使用 rubrics 将视觉反馈表示为结构化的视觉修复上下文。在每轮细化中,RubSE 生成类型化候选 rubrics,选择一个优先修复目标,并将先前选中的 rubrics 存储为历史,从而引导每次修订朝向范围明确的视觉修复,同时避免重复或过度宽泛的更改。 在六个 VLM 和三个 UI 到代码基准上的评估表明,RubSE 在最终轮次和最佳轮次设置中均显著优于朴素自演进,实现了更稳定的细化轨迹和更高的轨迹级性能上限。进一步分析显示,RubSE 通过改善对严重视觉回归的恢复来缓解轨迹崩溃,且更强的 rubric 生成器可以将有效的视觉修复指导迁移给较弱的代码改进器。
论文精读
TL;DR RubSE 用结构化打分细则(typed rubrics)作为视觉修复上下文,每轮迭代只选一个优先修复目标并记录历史,从而抑制局部代码修改引发的连锁视觉退化,让 UI-to-code 自进化轨迹更稳定、上限更高。
问题
UI-to-code 生成是视觉语言模型(VLM)的关键应用方向,目标是将界面截图或设计稿转换为可运行的前端代码。近期大视觉语言模型在该任务上展现了较强的一次性生成能力,但测试时自演化(self-evolution)仍不稳定。
现有自演化方法通常将视觉反馈(如截图差异或自然语言描述)直接作为上下文,要求模型在每轮直接修改代码。这种做法忽略了 视觉修复耦合(visual repair coupling):局部代码编辑会通过布局、样式、组件依赖传播,修复一处视觉不匹配的同时可能破坏之前已经正确的区域。模型缺乏对修改范围和优先级的显式约束,导致反复修改同一区域或过度扩张改动,最终引发轨迹震荡甚至轨迹崩溃。此外,朴素自演化没有记忆机制,无法避免重复尝试无效修复。
UI 代码的视觉渲染具有高度非局部性:一个 CSS 属性或 DOM 结构变化可能影响多个元素的布局和样式。这种耦合使得局部修复的全局影响难以预测,模型容易陷入“按下葫芦浮起瓢”的困境。对于实际工程而言,稳定的自演化是降低人工介入成本、实现自动化前端生成的关键;如果每轮修复都可能引入新的回归,测试时优化就失去了实用价值。业界对 UI-to-code 工具的需求正在增长,但稳定性不足严重阻碍其从原型走向生产环境。
类似在低代码平台或设计转代码工具中,开发者调整一个组件样式时可能引发整页布局连锁变化,需要类似 lint 规则或修复优先级列表来约束自动修改范围。
核心洞察
- 将视觉反馈表示为结构化 rubric,而非直接使用原始图像差异或自由文本描述,把开放式视觉修复转化为离散的、可优先排序的修复目标。这一设计显著缩小了每次迭代的搜索空间,并提供了可解释的修复轨迹。不同于以往依赖 CLIP 相似度或整体评分作为反馈信号的方法,RubSE 的 typed candidate rubrics 显式区分布局、样式、组件等维度,使模型能够针对具体视觉缺陷生成并选择最有价值的修复项,避免了模糊反馈导致的盲目修改。
- 显式建模 visual repair coupling 现象——局部代码编辑会通过布局、样式和组件依赖传播,修复一处同时破坏其他已正确区域——这是 self-evolution 轨迹崩溃的根本原因。现有自进化方法通常将每轮迭代视为独立改进问题,缺乏对跨区域耦合效应的约束。RubSE 通过维护历史 rubrics 并每轮仅选择一个优先修复目标,强制模型在增量修复中保持对既有正确区域的保护,从而将全量重绘式的过宽修改转化为受控的局部修复,从机制上抑制了轨迹振荡。
- RubSE 的 rubric 选择与历史记忆机制引入了一种有状态的增量修复策略,区别于无状态的 naive self-evolution。在每轮中生成多个候选 rubric 而非直接生成代码补丁,再通过优先级选择确定单一修复方向,这相当于在代码修改前先进行语义层面的规划。该策略使弱代码改进器也能从强 rubric 生成器获得可迁移的视觉修复指导,实现了跨模型能力的解耦与复用,为提升测试时计算效率与稳定性提供了新的架构视角。
方法
RubSE 方法流程
输入包括当前 UI 截图、待修改的 UI 代码、历史 rubric 记录与可选的视觉差异图。系统以多轮自进化方式运行,每轮输入为上一轮输出的代码与当前视觉反馈。
关键模块分三步:
- Typed Rubric 生成器:基于当前视觉差异与代码状态,生成一组带类型的候选 rubric,每个 rubric 描述一个具体的视觉缺陷(如
layout-misalignment、style-inconsistency、component-overflow)及其对应的修复目标。类型标注使反馈从模糊的自然语言批评变为可定位的修复指令。 - Rubric 选择与优先级排序:在候选中选择一个优先修复目标。选择依据包括视觉回归严重度、与历史 rubric 的差异度以及修复范围的可控性,避免重复修同一区域或一次性大范围改动。
- 历史存储与约束:已选 rubric 被写入历史记录,作为后续轮次的显式上下文。代码改进器(code improver)必须同时遵守当前 rubric 与历史记录,从而将每轮编辑限制在一个明确、局部的修复范围。
输出为满足当前 rubric 的改进代码,并进入下一轮视觉对比。历史记忆使长期迭代保持稳定,减少对已修复区域的回退。
差异点:与直接使用整张渲染图或非结构化自然语言作为反馈的 naïve self-evolution 相比,RubSE 把视觉反馈编码为结构化、分类型、可选择的 rubric,并配以历史记忆约束编辑范围,从机制上抑制视觉修复耦合带来的轨迹崩溃。
实验
实验设计
在六个大型视觉语言模型(VLM)与三个 UI-to-code 基准上,对比 RubSE 与 naïve self-evolution。评估涵盖 final-round / best-round 性能、轨迹稳定性和轨迹级性能上限;消融实验验证各组件作用,并分析轨迹崩溃的缓解机制及 rubric 生成器向较弱代码改进器的迁移能力。
关键发现
- RubSE 在 final-round 和 best-round 设置中显著优于 naïve self-evolution,实现更稳定的细化轨迹与更高的性能天花板。
- 进一步分析显示 RubSE 通过提升从严重视觉回归中的恢复能力来缓解轨迹崩溃。
- 更强的 rubric 生成器能将有效的视觉修复指导迁移给较弱的代码改进器。
对比解读
naïve self-evolution 受 visual repair coupling 影响,局部编辑可能传播至布局、样式和组件依赖,导致修复一处却破坏其他已正确区域。RubSE 通过生成类型化候选 rubrics、选择优先修复目标、维护历史选择,将每次修改约束在明确范围内,避免重复或过度修改,从而获得更鲁棒的迭代过程。
行业影响
落地场景
- 设计转代码工具:Figma 插件、浏览器扩展可直接将设计稿转为 React/Vue 组件,RubSE 作为后处理模块稳定多轮输出,减少视觉回归。
- 营销页面生成:电商大促、SaaS 落地页等高频变更场景,通过 VLM 生成初版代码并用 RubSE 精修,降低人工介入,支持快速迭代。
- 低代码平台:用户上传 UI 截图即可获得可维护前端代码,RubSE 提升生成质量,减少非专业开发者弃用率。
商业价值
- 降本:减少前端工程师从设计到代码的手工切图与样式微调时间,特别是多轮视觉回归修复的重复人工成本。
- 提效:营销活动页上线周期从小时级压缩到分钟级,支持快速 A/B 测试与活动迭代。
- 体验提升:生成代码视觉还原度更高,用户手动修正次数显著下降,增强工具可信度与付费意愿。
与现有产品/工作流接口
- 作为 refinement 模块:接入主流 design-to-code 工具链(如 Builder.io、Locofy),接收 VLM 初版代码与 UI 截图,输出修正后代码及 rubric 历史。
- API 集成:封装为同步/异步 REST API,与 GPT-4V、Claude 等 VLM 组合,作为 SaaS 后处理服务提供。
- CI/CD 嵌入:在代码生成 pipeline 中增加 rubric 选择与修复步骤,与既有视觉回归测试或 lint 检查联动,实现自动化质量门禁。
局限
- **计算开销明显增加**:RubSE 每轮需生成多个候选 rubrics 并进行选择与历史存储,相比 naïve self-evolution 额外引入多次前向推理,尤其在使用 API 或开源模型时显著提升 latency 和 token 成本。论文虽分析了计算成本,但在实时 UI 生成或大规模批量处理场景下,该开销可能成为工程落地的瓶颈,限制了其在资源敏感环境中的实用性。
- **高度依赖 rubric generator 质量**:方法性能受制于生成 rubrics 的 VLM 能力。若 generator 较弱,可能产生模糊、错误或冗余的修复目标,误导代码改进方向;实验显示强 generator 可向弱 improver 传递有效指导,但反向场景(弱 generator + 强 improver)未充分验证,导致系统鲁棒性存在隐患,实际部署需额外筛选或提升生成器性能。
- **领域泛化有限**:RubSE 针对 UI-to-code 设计,利用布局、样式、组件依赖等结构特性,其 rubric 表示和选择机制可能无法直接迁移至一般图像生成或通用代码修复任务。评估仅覆盖三个 UI-to-code benchmarks,缺乏跨任务验证,因此方法的适用范围和可迁移性尚不明确。