GameXpert-Bench: 编码智能体距离专业游戏开发还有多远?
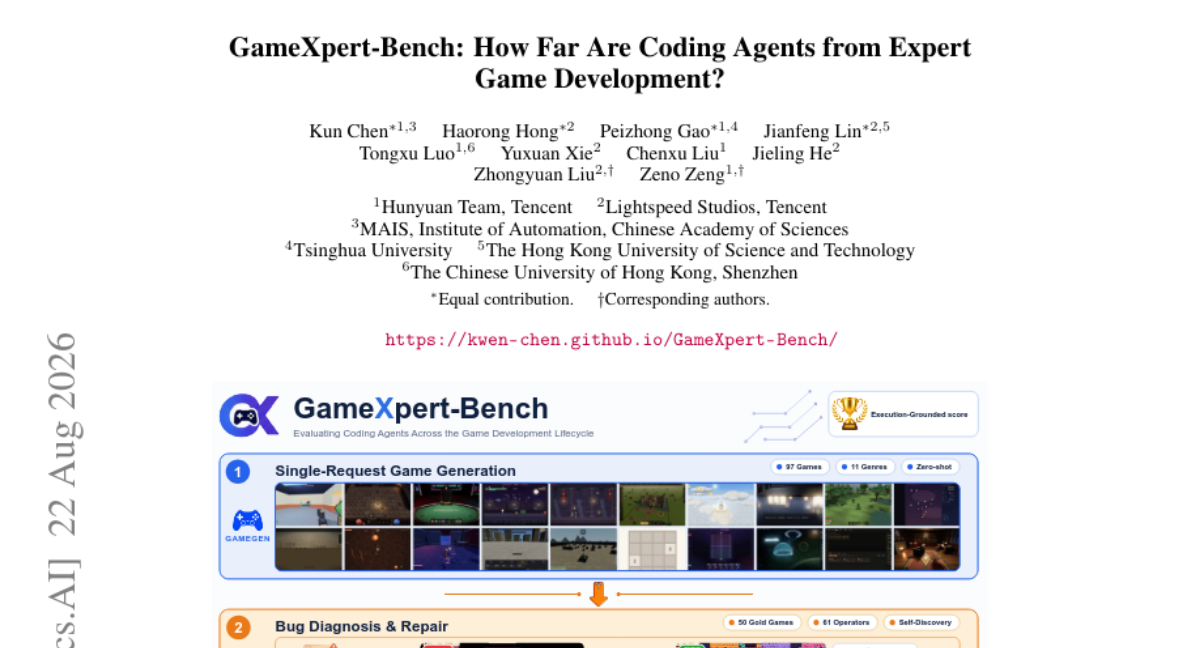
近年大语言模型可充当编码智能体,从自然语言请求构建完整游戏。游戏开发要求程序逻辑、视觉与音频内容、界面、交互和可玩性在一个可执行产物中协同工作,因此评估需同时顾及游戏产品和开发过程。现有基准多只评测最终产物或孤立的开发阶段,较难反映真实开发全貌。 我们分析完整的人机开发轨迹,识别出三个关键阶段:初始游戏生成、缺陷诊断与修复、多轮优化。为此提出 GameXpert-Bench,将其操作化为三个互补轨道:GameGen 在空白工作区中从单个请求生成完整游戏;GameFix 评测在缺陷被报告或需自行发现时的诊断与修复;GameOpt 借助源自真实用户与智能体开发轨迹的请求链,评测累积式优化。各轨道分别采用实时游戏交互、确定性行为测试或最终产品标准配合回归检查。 套件包含 97 个生成任务(覆盖 11 个类型)、100 个修复任务(来自 50 个人类验证关卡,每关注入 19–27 个缺陷),以及 17 个优化链(每链 6 轮,共 102 个请求)。三个轨道的结果表明,当前智能体在生成可玩基础与实现明确需求方面表现可靠,但在缺陷发现、运行时行为验证和跨变更保持功能上仍较为薄弱。
论文精读
TL;DR GameXpert-Bench 用 97 个生成任务、100 个修复任务和 17 条优化链,度量 coding agents 在游戏开发全生命周期的能力,发现当前模型擅长搭可玩骨架,但在自主发现 bug 与保持功能不退化上差距明显。
问题
问题背景
大型语言模型驱动的 coding agents 正从单步代码补全走向端到端软件交付,游戏开发因其融合逻辑、视觉/音频资产、交互与可玩性,成为检验 agents 综合工程能力的典型场景。
现有方法局限
已有基准大多将游戏开发拆解为孤立阶段进行评测,例如只评估最终产物或单独测试缺陷修复,忽略了真实开发中“生成—诊断修复—多轮优化”的完整生命周期。更关键的是,多数评估依赖静态代码检查或有限人工评分,缺乏在真实游戏运行时中执行确定性行为测试与回归检查的手段,无法区分“代码存在”与“功能可用”。比如仅验证碰撞检测 API 被调用,却不验证碰撞是否在正确的物理坐标触发,导致对 agent 的实际可用性高估。
为什么这个问题难/重要
游戏是交互式软件,正确性不只体现在代码逻辑,更体现在动态运行时行为。模型可以生成可编译、甚至表面完整的游戏,但缺陷往往隐藏在多轮交互与需求变更中;同时,后续修改容易引入回归,破坏此前已实现的功能。业界对能自主完成复杂软件任务的 agents 需求强烈,游戏开发作为软件工程的缩影,其评估结果能揭示 agents 在长程任务、自主调试和需求演化上的真实短板,为构建更可靠的 AI 软件工程师提供基准与改进方向。
行业类比
类似自动驾驶评估不能只测感知模块离线精度,而必须在仿真环境中验证端到端规划与控制,并检测多次更新后是否出现功能回退。
核心洞察
- 游戏开发评估需要覆盖生成、修复、优化全生命周期,而非仅评最终产物或单阶段。GameXpert-Bench 以三个互补 track 实现这一点:GameGen 评估单请求生成,GameFix 评估缺陷诊断与修复,GameOpt 评估多轮优化。其独特之处在于将开发过程与产品结果同时纳入,并针对每个 track 设计匹配的评估手段(实时交互、确定性行为测试、回归检查)。这比现有基准只关注最终 artifact 或隔离的单阶段更能暴露 agent 在迭代中的回归风险与功能保持能力。
- GameFix 通过控制两种查询模式(Explicit Issue 与 Self-Discovery)量化了模型诊断与修复能力的分离,揭示出自主发现缺陷的显著短板。该 track 在 50 个经过人工验证的游戏关卡中注入 19-27 个 bug,并采用多 bug 隔离的 F2P/P2P 测试,确保无交叉污染。与以往代码修复基准不同,它区分了“被告知问题后修复”与“主动探索发现问题”两个场景,发现即使更强模型也保留较小的 Cliff,说明运行时行为验证和缺陷定位是当前 agent 的核心瓶颈。
方法
方法概览
GameXpert-Bench 将游戏开发生命周期划分为三个阶段:初始生成、缺陷修复、多轮优化,并对应三个基准 track。
输入与关键模块
- GameGen:输入为单条自然语言请求及空工作区。关键模块为完整游戏生成,输出为可运行的交互式游戏。评估采用实时游戏交互、确定性行为测试和最终产物标准(含回归检查),结合自动化指标与人工评分(视觉质量、玩家体验)。
- GameFix:输入为包含人工植入 bug 的游戏(每个任务 19-27 个 bug)以及两种查询模式:显式缺陷报告或代理自我发现。关键模块为 bug 诊断与修复,输出为修复后的游戏。评估使用可执行测试 F2P(First-to-Pass)和 P2P(Pass-to-Pass),分别衡量首次通过率与持续通过率。
- GameOpt:输入为从真实用户-代理开发轨迹中提取的请求链(17 条链,6 轮,102 个请求)。关键模块为在已有游戏上的累积式优化,输出为多轮修改后的游戏。评估包括轨迹回放与最终产物评判,并按难度加权。
输出与评估框架
三个 track 统一输出可量化分数,覆盖功能完整性、行为正确性与回归稳定性。评估方法强调运行时验证——通过实际交互捕获游戏状态,而非仅静态代码检查。
与同类方法的差异点:现有基准多孤立评估最终产物或单一开发阶段,GameXpert-Bench 首次覆盖从生成、修复到优化的完整生命周期,并同时考察缺陷发现能力与跨改动功能保持。
实验
实验设计
基准拆为三个互补 track:GameGen(97 任务、11 类型,单请求生成)、GameFix(50 关卡→100 修复任务,每任务注入 19-27 bug,含 Explicit Issue / Self-Discovery 两模式)、GameOpt(17 条真实交互轨迹,6 轮 102 请求)。评测用 live game interaction 、deterministic behavioral tests 与 regression checks,覆盖运行时行为。
关键发现
模型在“产出可玩基础、实现显式需求”上可靠,但在缺陷发现、运行时验证、跨修改保持功能上明显不足。“Implemented Does Not Mean Functional” 是核心教训:UI 错位常见,自动功能分与人类感知质量强相关。GameFix 远未饱和,模型在 Self-Discovery 模式下分化明显,而 Explicit Issue 区分度低。
与基线对比的解读
现有基准多只评最终 artifact 或孤立阶段,GameXpert-Bench 首次覆盖生成-修复-优化完整生命周期。它借鉴 runtime-grounded 评测,但扩展到 bug 诊断与多轮优化。对工程实践,短板不在“写初始代码”,而在维护性与可验证性——需加强 agent 的自我验证、回归测试与缺陷定位,而非仅提升单次生成质量。trajectory-based 构建增强生态效度。
行业影响
落地场景
GameXpert-Bench 直接服务于需要自动化游戏生成与维护的团队:游戏工作室原型开发、互动内容平台批量生产 H5 小游戏、以及教育场景下编程任务生成。评估覆盖生成、缺陷修复、多轮优化 三个阶段,可用于 coding agent 选型与迭代监控。
具体 use case:
- 电商平台营销活动需要定制化小游戏,团队用 GameGen 任务评估多个模型产出可玩性与美术质量,筛选后接入自动生成流水线;
- 企业服务公司提供低代码游戏编辑器,用 GameFix 和 GameOpt 检测模型在用户反馈缺陷与迭代请求下的稳定性,避免线上回归。
商业价值
- 降本:减少手工游戏测试与缺陷修复成本,GameFix 的自动回归测试可节省 QA 人力;GameOpt 的 request chain 模拟真实用户迭代,提前暴露回归风险,避免线上故障。
- 增收:快速产出高质量互动内容提升用户时长和转化率,例如营销游戏带来广告或购买转化。
- 体验提升:GameGen 的人类评估维度(视觉质量、玩家体验)与自动化评分关联强,可指导模型优化方向,最终提高玩家留存。
与现有产品/工作流的接口
可将 GameXpert-Bench 作为评测集嵌入 ML 实验平台或 agent 框架,如 LangChain、AutoGen、CrewAI。每个任务产生结构化结果(F2P/P2P 测试、回归分数),可接入 CI/CD 流水线作为模型发布门禁。推荐做法:
- 游戏引擎(如 Godot/Unity)容器化,提供统一交互 API;
- 将 GameGen/GameFix/GameOpt 转换为 pytest 或集成测试套件,与现有 LLM 评估工具(如 lm-eval-harness)协同;
- 利用其“推理轨迹分析”能力,辅助开发者定位 agent 弱项,用于 prompt engineering 或 fine-tuning。
局限
- 数据集规模与覆盖范围有限:GameGen 包含 97 个任务,GameFix 基于 50 个关卡生成 100 个修复任务,但 GameOpt 仅有 17 条优化链共 102 个请求,样本量偏小,难以充分反映真实用户与 agent 多轮交互的多样性。任务多为 2D 或轻量 3D 游戏,复杂商业级游戏(大型 3D、多人联机、资源密集型)未覆盖,限制了结论的外推性。
- 评估依赖人工与主观标准:GameGen 的 Visual Quality 和 Player Experience 维度依赖人工评分,尽管有 hybrid automated scoring 校准,但人工部分仍存在主观性与可重复性问题。GameFix 和 GameOpt 的困难度判别权重等指标也需要专家设计,可能引入偏差。此外,bug 注入是人工构造的,其分布可能与真实开发中的 bug 特征不同,影响对模型缺陷定位能力的评估真实性。
- 缺乏对真实开发环境的模拟:评估使用确定性行为测试和回归检查,但对游戏的可玩性、长期稳定性、性能等难以覆盖。三个 track 分开评估,未考察同一 agent 在完整项目迭代中的持续表现(如从生成到修复再到优化的连续任务)。论文未讨论多 agent 协作或使用外部资源(如资产库、引擎插件)的情况,这些在真实游戏开发中常见,限制了 benchmark 与现实开发的对应程度。