更好的检索,更差的鲁棒性:多跳 RAG 如何放大上游 ASR 错误
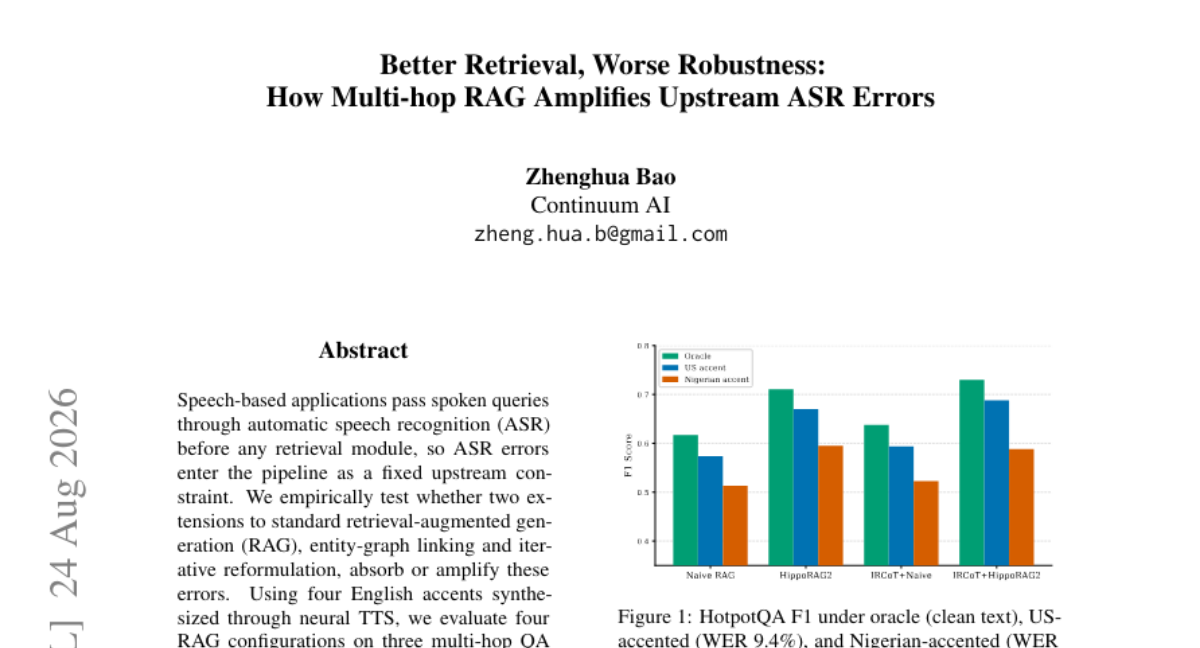
语音应用将口语查询通过自动语音识别(ASR)送入检索模块,使 ASR 错误成为固定的上游约束。本研究考察标准检索增强生成(RAG)的两种扩展——实体图链接 (entity-graph linking) 和迭代改写 (iterative reformulation)——是吸收还是放大这些错误。 我们使用神经 TTS 合成四种英语口音,在三个多跳 QA 基准(HotpotQA、2WikiMultiHopQA、MuSiQue)上评估四种 RAG 配置,并与干净文本 oracle 对比。实验发现:结构更丰富的配置在 ASR 输入下通常保持更高绝对 F1,但两种扩展均放大错误——它们的组合使干净文本到最高 WER 口音的 F1 差距 比朴素密集检索扩大 36-67%(三个基准均如此)。 主要失败模式是查询实体被破坏,占 2WikiMultiHopQA 上全部方法退化案例的 87-96%。两种轻量级表面形式缓解措施仅能恢复少量差距,表明下游检索结构放大了剩余实体错误。我们已发布代码和数据。
论文精读
TL;DR 多跳 RAG 的实体图链接与迭代重构虽提升了绝对 F1,却会放大 ASR 错误:实体损坏是主要失效模式,且表层缓解难以弥补结构差距。
问题
问题背景
语音交互成为主流入口,用户通过 ASR 将语音查询转为文本后进入基于检索的生成(RAG)流程。在多跳问答中,下游系统需准确解析多个实体及其关系,ASR 错误会作为固定上游约束进入检索链路。
现有方法局限
多跳 RAG 扩展在 干净文本 上显著提升性能,如 实体图链接 和 迭代重构 能有效组织推理路径。然而这些方法默认 ASR 输出接近完美,忽略语音识别错误对实体提及的破坏。现有语音问答研究多聚焦单跳场景或简单检索,缺乏对复杂多跳链路中错误传播的量化分析。当实体名称被 ASR 误写为同音词或罕见词变形时,检索结果偏离,后续生成难以纠正。
为什么这个问题难/重要
多跳推理要求链路中多个实体同时准确,任何一环损坏会导致级联失败。ASR 错误在高 WER 口音下更严重,且错误模式与实体语言特征耦合(如专名、低频词)。构建鲁棒语音 RAG 需要理解检索结构如何放大而非吸收上游错误,这涉及 错误传播机制 与 检索拓扑复杂度 的交互,目前缺乏系统基准和诊断方法。
行业类比
类似于多传感器融合自动驾驶中,单个传感器噪声会通过融合算法放大并影响规划,语音 RAG 前端 ASR 错误同样需要针对检索结构的鲁棒性设计。
核心洞察
- 多跳 RAG 的结构化扩展(实体图链接 + 迭代改写)不是吸收而是放大 ASR 错误:在最差口音下,其与干净文本的 F1 差距比朴素稠密检索扩大 36–67%。这一发现独特之处在于,已有工作多在干净文本上比较 RAG 架构或单独研究 ASR 鲁棒性,很少量化检索结构化程度对上游语音错误传播的影响;本文通过 clean-text oracle 与四种配置在同一 ASR 条件下的对比,分离出结构复杂度本身带来的鲁棒性损失,而不仅仅是绝对性能高低。
- 实体损坏是多跳 RAG 在 ASR 输入下的主要失败模式,占 2WikiMultiHopQA 退化案例的 87–96%。这解释了为何 N-best 解码、音素纠正等 surface-form 缓解效果有限:下游图链接和迭代改写会在实体错误上产生级联。相比单跳 QA,多跳任务对实体准确率要求更高,这一视角区别于单纯提升 ASR 转录准确率的做法,提示需将 ASR 置信度或音素信息直接接入实体消歧和图构建,而非事后修复文本。
方法
输入与 ASR 转录
口语查询通过 neural TTS 合成四种英语口音(如美式、英式、印度式、澳式),模拟真实语音输入。随后由 Whisper ASR 模型转录为文本,作为下游 RAG 的输入。转录可能引入实体错误、同音字替换或词序扰动,成为固定的上游约束。
关键模块:四种 RAG 配置
- naive dense retrieval:对转录文本直接做密集向量检索,返回相关段落,再送入生成模型。
- entity-graph linking:识别查询中的实体,将其链接到知识图谱,基于图结构进行多跳检索,利用实体间关系扩展证据链。
- iterative reformulation:迭代式查询重构,每轮检索后根据已检索内容重新生成查询,直到收集足够证据。
- combination:结合实体图连接与迭代重构,形成结构最复杂的配置。
缓解策略与输出
两种轻量级缓解方案:N-best decoding(利用 ASR 的多个候选转录)和 phonetic entity correction(基于发音相似度修正实体)。最终系统输出多跳问答答案,并与干净文本 oracle 对比 F1 和错误类型分布。
跟同类方法的差异点:不同于仅优化检索组件或假设干净文本输入的工作,该研究显式将 ASR 错误作为上游固定约束,系统评估下游检索结构对错误的吸收或放大效应。
实验
实验设计
实验构建 spoken multi-hop RAG pipeline:使用 neural TTS 合成四种英语口音的语音查询,经 Whisper 转录后输入四种 RAG 配置——naive dense retrieval、entity-graph linking、iterative reformulation 及二者组合。在 HotpotQA、2WikiMultiHopQA、MuSiQue 三个多跳 QA 基准上,与 clean-text oracle 对比 F1。
关键发现
- ASR 错误导致 F1 下降,且随 WER 升高而加剧。
- 结构更丰富的配置虽维持更高绝对 F1,但相对 clean text 的 F1 gap 被放大:组合方法在最高 WER 口音下的 gap 比 naive dense retrieval 大 36–67%(三个基准均如此)。
- 实体损坏 为主导失败模式,在 2WikiMultiHopQA 上占 87–96% 的退化案例。
- N-best decoding 与 phonetic entity correction 两项轻量缓解只缩小部分 gap,剩余结构性 gap 仍显著。
基线对比解读
与 naive dense retrieval 相比,entity-graph linking 和 iterative reformulation 通过结构化检索路径与查询改写提升多跳推理能力,但也增加了对查询实体的依赖。ASR 对实体词的错误转录会被实体链接与多跳扩展逐步放大,导致错误沿链路传播。这说明下游检索结构本身是误差放大器,而非吸收器;工程上应在管道入口引入 ASR 置信度感知或实体级不确定性传播,而非仅依赖表面修正。
行业影响
落地场景
语音交互产品中,用户通过口语提出多跳推理问题,如“帮我找一款适合干性皮肤、价格低于 500 元且用户评价高的面霜”,系统需先 ASR 转写,再经多跳 RAG 检索商品属性、价格、评论等。论文表明复杂 RAG 结构(实体图链接 与 迭代重述 的组合)在 ASR 错误下 F1 下降更严重,因此团队需要重新评估语音多跳 QA 系统的架构选择。
商业价值
- 降低错误成本:识别出 ASR 错误在复杂检索流程中被放大,可避免部署看似检索指标更高但实际语音场景更脆弱的方案,减少错误回答带来的客服升级或用户流失。
- 体验提升:针对实体损坏的轻量缓解不足,提示需投入更强的实体纠错或鲁棒检索,提升语音助手在嘈杂环境 / 口音下的可用性,直接改善用户信任与留存。
- 降本:优先在入口做实体级校验比事后修复更便宜,可减少多轮澄清或人工接管。
跟现有产品/工作流的接口
- 在现有 RAG pipeline 中增加 ASR 错误注入测试:用多口音 TTS 合成查询,量化不同检索结构下的 F1 gap,作为上线前评估。
- 将 实体识别与链接 模块前置,在检索前对 ASR 输出做实体校验(如利用知识库别名、音似匹配),再输入多跳 RAG,避免错误在图中传播。
- 监控线上查询的实体损坏率,设置 fallback 到 naive dense retrieval 或澄清对话。
具体 use case:电商语音导购、企业知识库语音助手。
局限
- **合成语音与单一 ASR 模型** 的限制:实验采用神经 TTS 合成四种英语口音,并用 **Whisper** 作为唯一 ASR 系统。虽然附录包含真实语音验证,但 TTS 生成的语音错误分布可能与真实用户口音、噪声环境存在差异;单一 ASR 模型也无法代表不同厂商 / 架构的转录误差特性。这限制了结论在多样化语音交互场景下的泛化性,未来需在更多真实语音数据和多种 ASR 引擎上复现。
- **缓解策略有效性有限**:论文提出的 **N-best 解码** 和 **音素实体校正** 两种轻量级表面形式缓解,仅能缩小部分 F1 差距,未能从根本上解决结构化 RAG 对实体错误的放大问题。这表明下游检索结构对残留实体误差的敏感性更强,但论文未探索更深入的结构化鲁棒方法(如语音感知的检索或联合训练),后续工作需从 RAG 架构内部设计容错机制。
- **实验范围与错误分析局限**:研究主要聚焦于实体腐蚀这一主要失败模式,对其他错误类型(关系抽取错误、数值推理偏差、指代消解失败等)的分析不足;多跳 RAG 扩展仅选取了两个代表性结构,未涵盖全部变体;所有数据集均为英文,缺乏跨语言验证。因此,虽然揭示了重要现象,但全面理解 ASR 错误在多跳 RAG 中的传播仍需更广泛的错误分类和跨语言实验。