OmniAssistBench: 面向 Omni-LLMs 的助手式交互基准
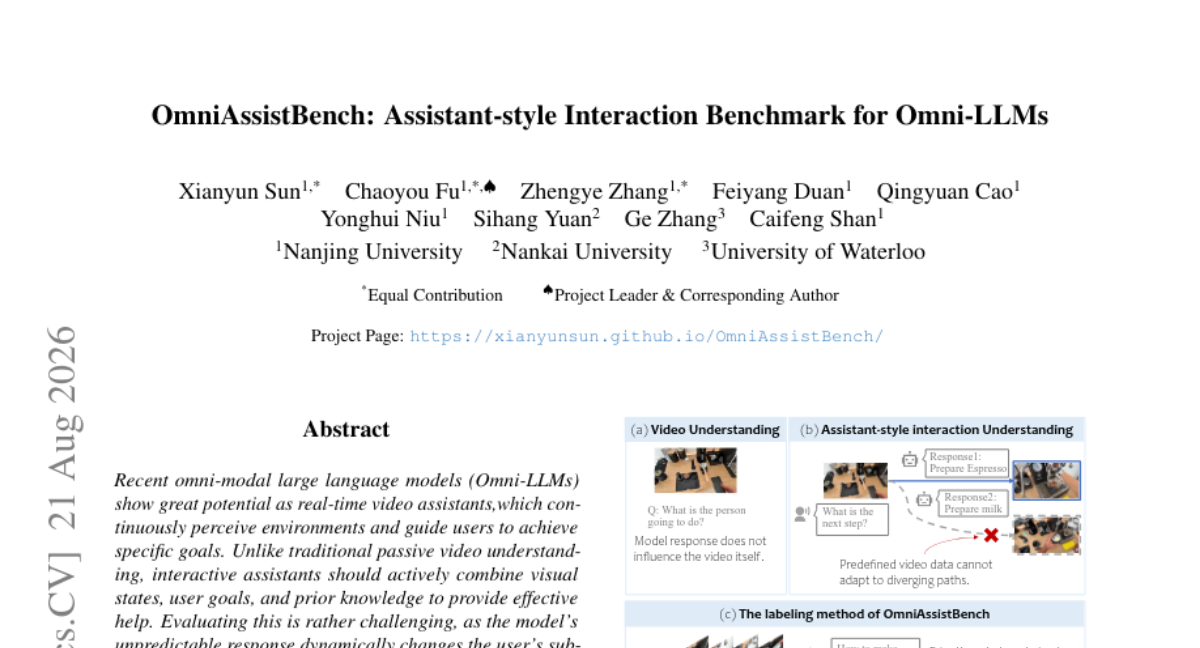
近期,Omni-LLMs 作为实时视频助手展现出巨大潜力,能够持续感知环境并指导用户实现具体目标。然而,与传统被动视频理解不同,交互式助手需要主动结合视觉状态、用户目标与先验知识来提供有效帮助。这给评估带来了挑战:模型不可预测的响应会动态改变用户的后续行为,静态离线数据集难以覆盖。 为解决这一瓶颈,我们提出了 OmniAssistBench。该基准通过逆向工程现有互联网视频构建数据集:推断合理的用户目标,并将视频切分为多轮片段以模拟连续交互。为处理同一用户目标可由多种方式实现所导致的路径发散问题,我们为模型提供源自源视频的预定义先验,要求它们引导用户沿完全相同路线执行。这一流程耗时超过 1000 个专家工时。 实验结果显示,专有模型 Gemini-3-Pro 达到 66.4 分(满分 100),开源模型 Qwen3-Omni-Instruct 获得 51.2 分。尽管当前模型普遍能理解用户输入,但它们常常给出错误或不完整的回答;具体表现为:难以处理视觉提示(如手势)、多轮交互中无法保持历史上下文,以及未能将响应延迟至目标事件发生。 总体而言,该结果表明模型在成为可靠助手之前仍有较大改进空间。
论文精读
TL;DR OmniAssistBench 通过逆向构建多轮交互视频基准,评估 Omni-LLMs 作为实时助手的引导能力;当前模型普遍难以处理视觉提示、历史上下文与及时响应,距实用仍有较大差距。
问题
问题背景
实时视频助手正成为 Omni-LLMs 的关键应用方向,模型需要结合视觉状态、用户目标与先验知识,在多轮交互中主动引导用户完成具体任务。然而,现有评测体系仍聚焦于被动视频理解,无法反映助手式交互的动态特性。
现有方法局限
传统视频理解基准(如 Video-MME、MVBench)以单轮问答或描述为主,假设用户问题固定、模型输出不影响后续输入。这一假设在交互场景中不成立:模型的错误回答会改变用户动作,导致后续视频状态偏离预期,静态离线数据集无法复现这种闭环依赖。此外,同一用户目标可通过不同路径达成,缺乏对齐约束的交互评测会引入路径发散问题,使不同模型之间难以公平比较。真实交互视频数据稀缺,人工采集成本极高,进一步限制了基准构建。
为什么这个问题难/重要
交互评测的核心难点在于动态路径对齐与上下文一致性:模型不仅要理解当前视觉状态,还要维持多轮历史信息,并在正确时机响应(如等待目标事件出现)。论文发现现有模型普遍存在三类缺陷:对视觉手势提示理解不足、多轮交互中丢失历史上下文、无法延迟响应至目标事件。这些恰好是真实助手场景的刚需能力,也是 Omni-LLMs 从“能看”走向“能帮忙”的关键瓶颈。业界对具身智能、实时 AI 助手的关注度持续上升,但缺乏可靠评测工具来量化进展。
行业类比
这一挑战与自动驾驶中的闭环仿真类似:开环评测只看单帧感知准确性,而闭环评测需要验证系统决策对环境的连锁影响。OmniAssistBench 相当于为视频助手构建了一条强制对齐路径的闭环测试轨道,用预定义先验消除路径分叉,使评测可重复、可比较。
核心洞察
- 通过从源视频提取预定义先验并强制模型引导用户沿相同路线,解决了交互式评估中因用户目标多路径实现导致的发散问题。与传统静态视频理解基准(如 Video-MME)的被动问答不同,OmniAssistBench 将用户目标绑定到视频中的具体路径,使动态交互轨迹可重复、可比较,为交互式助手提供了可规模化构建的评估范式。
- 评测揭示现有 Omni-LLMs 虽能理解用户输入,但在视觉提示(如手势)、多轮历史上下文保持和适时延迟响应三方面频繁出错。这些能力缺失直接对应真实交互中的关键需求:用户通过手势等非语言信号传达意图、对话中引用历史指令、等待正确时机给出建议。OmniAssistBench 将评估焦点从“看懂了什么”转移到“何时该说、说什么”,为模型优化提供了具体到子任务的诊断信号。
方法
输入与数据来源
以互联网视频为原始素材,通过反向工程(reverse-engineering)推断用户的逻辑目标(logical user goals),并将视频分割为多轮交互片段(multi-turn clips),模拟助手与用户之间的连续对话。
关键模块
- 先验约束:从源视频提取预定义先验(predefined priors),要求模型引导用户沿与视频完全相同的路径行动,解决同一目标下多条交互路径导致评测发散的问题。
- 任务分层:包含基础交互理解(Basic Interactive Understanding)与高级交互理解(Advanced Interactive Understanding),覆盖视觉提示(如手势)、多轮历史上下文保持、延迟响应至目标事件等能力;另设真实世界案例(Real World Cases)。
- 评分机制:采用 0–100 分的评分细则(scoring rubric),结合专家人工标注或 judge 模型,对模型的回答正确性、完整性、及时性进行细粒度打分。
输出与评估
输出为多轮「用户指令—视频剪辑—模型回答」三元组,可直接用于 Omni-LLM 的交互式评测。论文测试了Gemini-3-Pro(66.4 分)与Qwen3-Omni-Instruct(51.2 分),均显示在视觉提示、上下文保持和等待触发事件方面存在明显不足。
差异点:与静态视频 QA 基准(如 Video-MME)不同,OmniAssistBench 通过先验路径约束和反向工程构造,使评测聚焦于模型在动态、多轮、指令生成 场景下的真实交互能力,而非被动的视频理解。
实验
实验设计
OmniAssistBench 通过逆向工程现有互联网视频构建多轮交互数据集,为模型注入预定义先验以保证交互路径一致,避免“同一目标多路径”导致的评测不可比。评测覆盖基础交互理解、高级交互理解及真实场景,包含多轮对话、视觉提示(如手势)和延迟响应等维度。
关键发现
- 闭源模型 Gemini-3-Pro 取得 66.4/100,开源模型 Qwen3-Omni-Instruct 取得 51.2/100,均远未达到满分。
- 模型普遍能理解用户输入,但经常给出错误或不完整答案。
- 典型失败模式:对视觉手势理解差、多轮交互中丢失历史上下文、无法在目标事件发生前保持沉默等待。
与基线对比解读
Gemini-3-Pro 比 Qwen3-Omni-Instruct 高出 15.2 分,体现闭源模型在复杂交互式多模态理解上的优势。但两者距离满分仍有 33.6 和 48.8 的差距,说明当前 Omni-LLM 在实时主动指导场景中仍存在根本性短板。相较传统被动视频理解评测,OmniAssistBench 更强调时序决策和上下文持续性,为后续模型迭代指出了明确方向。
行业影响
落地场景
OmniAssistBench 评估的实时视频助手能力,可直接用于 AR 眼镜导航、远程维修指导、电商直播导购、在线实操教学 等场景。这些场景要求模型持续感知视频流、理解用户手势或语音指令,并给出下一步行动建议。
商业价值
- 降本:用模型替代或辅助人工客服/专家,减少一对一指导的人力成本。
- 增收:在电商直播中,实时助手能提升转化率与客单价,通过精准引导用户完成购买动作。
- 体验提升:多轮交互中保持历史上下文、正确响应视觉提示(如手势)能大幅降低用户挫败感。
当前 Gemini-3-Pro 得分 66.4/100,Qwen3-Omni-Instruct 仅 51.2,说明模型离可靠助手仍有较大差距,但也意味着优化空间明确。
与现有产品/工作流的接口
可将 OmniAssistBench 作为多模态交互评估层,集成到 MLOps 流水线 或 LLM 评测框架(如 lm-evaluation-harness)。通过提供标准化的多轮指令、视觉提示和延迟响应测试集,自动生成模型能力画像,用于选型、回归测试与上线 gate。对实时视频流管道,可对接 WebRTC 或 RTSP 输入,模拟真实交互时的延迟与上下文丢失问题。
具体落地 use case
- 电商直播:虚拟导购助手实时分析主播展示商品与用户弹幕手势(如“比心”表示感兴趣),多轮对话中记住用户偏好,主动推送优惠券并引导下单。OmniAssistBench 可评估其视觉提示响应与上下文保持能力。
- 企业远程协助:工业设备维护场景,现场工人佩戴 AR 眼镜,AI 助手依据视频流逐步指导维修流程。通过测试模型是否在正确时间点给出指令(避免过早或延迟),直接降低误操作风险,提升首次修复率。
局限
- - **数据集构建基于反向工程**,而非真实用户交互录制。论文从现有互联网视频中人工推理用户目标并切分成多轮片段,这意味着用户行为和反馈是事后静态模拟,缺乏真实交互中常见的动态变化(如用户临时改变主意、模糊提问、环境突发干扰等)。因此,模型在该 benchmark 上的表现与实际部署场景之间可能存在系统性差距,对用户不确定性行为的鲁棒性未能得到验证。
- - **预定义路线约束限制了任务开放性**。为了避免同一目标可通过多条路径完成导致的评估分支爆炸,论文向模型提供源视频预定义的先验,并要求模型引导用户沿完全相同的路线。这一设计虽然保证了评估一致性,但也大幅降低了任务自由度,可能低估模型在自由交互中的规划与适应能力;同时没有评估模型在路线偏离或用户不配合情况下的表现,使得高分模型可能在真实多样化指令下失效。
- - **评估规模与多样性有限**。实验主要对比 Gemini-3-Pro 与 Qwen3-Omni-Instruct 等少数模型,且依赖 judge model 进行主观评分,可能引入评估偏差;论文未明确披露数据集规模、语言覆盖、视频来源分布及是否包含多样化人群/场景,影响结论的普适性。此外,构建过程耗时超过 1000 专家小时,扩展成本较高,不利于社区快速迭代和后续研究。