Llama-Mobile: 面向视觉语言模型的高效 2.7 比特量化
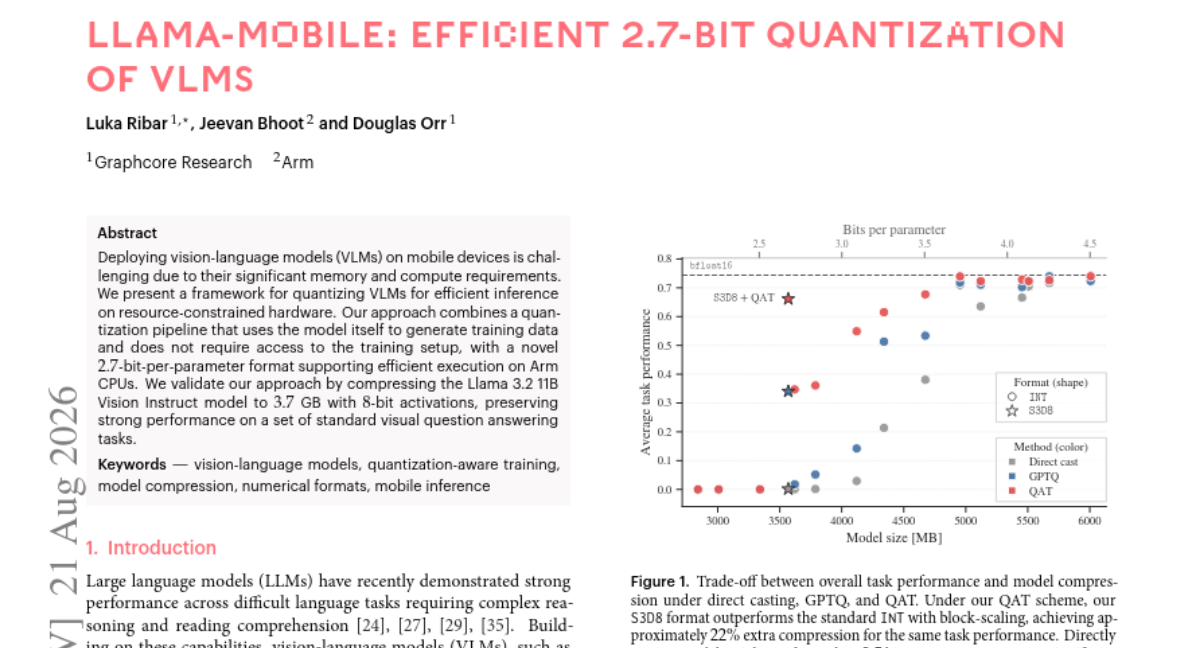
在移动设备上部署视觉语言模型(VLMs)面临显著的内存和计算挑战。本文提出一种量化框架,旨在资源受限硬件上实现高效推理。 该框架结合了两方面创新:一是量化流程完全利用模型自身生成训练数据,无需访问原始训练配置;二是设计了一种新颖的2.7-bit-per-parameter 格式,支持在 Arm CPU 上高效执行。 实验验证中,我们将 Llama 3.2 11B Vision Instruct 模型压缩至 3.7 GB,激活保持 8 比特精度,在标准视觉问答任务上仍展现出强大性能。
论文精读
TL;DR Llama-Mobile 框架通过模型自生成数据做量化感知训练,并设计 2.7-bit 权重格式,将 Llama 3.2 11B 视觉模型压缩至 3.7GB,在 Arm CPU 上高效执行且 VQA 性能保持,无需原始训练数据。
问题
问题背景
视觉语言模型 (VLM) 在移动端部署面临内存占用与计算开销双重瓶颈:主流 11B 级模型原始权重约 22 GB (FP16),远超设备可用内存,且推理延迟难以满足实时交互。
现有方法局限
- 低比特量化 (≤3-bit) 虽能大幅压缩模型,但若直接采用 GPTQ 等训练后量化 (PTQ),在 VLM 多模态分布上误差累积明显,视觉问答精度下降严重。
- 量化感知训练 (QAT) 精度更好,但依赖原始训练数据与完整训练管线;实际部署方往往无法获取,且数据分布与部署场景不匹配时效果不可控。
- 现有推理格式如 4-bit 整数 或 2-bit pack 在 Arm CPU 上要么带宽利用率不足,要么解码开销过高,缺乏专为移动端设计的权重格式与算子协同方案。
为什么这个问题难/重要
VLM 量化难在视觉 token 与文本 token 的分布不一致:视觉编码器输出特征动态范围大,直接套用 LLM 量化策略会导致关键视觉信息丢失。同时,移动端内存带宽与算力均受限,低于 3-bit 的权重表示会引入非线性解码开销,需在格式设计与硬件指令上深度耦合。业界对端侧多模态助手需求持续上升,能否将 11B 级模型压缩到 4 GB 以下且保持可用精度,直接决定 VLM 能否脱离云端。
类比:类似语音助手中端侧唤醒词模型的极致压缩——必须用极小内存与算力完成常开推理,任何精度损失都会破坏用户体验。
核心洞察
- 2.7-bit 非整数位宽格式与 Arm CPU 执行效率的协同设计,突破了传统 2/3/4 比特量化的限制。传统低比特量化常以精度损失换取压缩率,但非整数位宽的实际部署依赖硬件友好的解码路径。本文提出 S3D8,通过特定的物理布局和解码逻辑,使 2.7 位权重能在 Arm CPU 上高效执行,同时将 Llama 3.2 11B Vision Instruct 压缩到 3.7 GB。与仅关注模型精度的量化研究相比,这种格式与硬件的 co-design 确保了压缩收益真实可落地,而非停留在理论层面。
- 利用模型自生成训练数据实现 QAT,完全绕开了对原始训练数据的依赖。在实践中,开源模型往往只提供权重而训练数据不可得,这成为 QAT 部署的最大障碍。本文让 VLM 自身生成合成数据,并通过 prompt sampling 提升多样性,在标准 VQA 任务上验证了效果。相比需要预存数据或复杂数据恢复的方法,这种 self-supervised 管道显著降低了量化门槛,使非原始数据持有者也能实现低比特量化,且性能接近使用原始数据训练。
方法
输入
给定预训练 VLM(如 Llama 3.2 11B Vision Instruct),方法不要求访问原始训练数据或训练框架,仅需模型本身与一组用于触发合成数据生成的提示。
关键模块
合成 QAT 数据管线
- 从预设的 prompt 模板中采样文本提示,驱动模型对图像或文本输入生成伪标注输出,构造用于量化感知训练的校准数据集。
- 管线完全依赖模型自身的推理能力,避免外部标注和原始训练集依赖。
量化感知训练(QAT)
- 在合成数据上执行 QAT,前向传播中模拟权重低比特量化噪声,反传更新原始浮点权重,使模型逐步适应量化误差。
- 激活保持 8-bit,训练目标为视觉问答损失,对数据选择敏感,但自生成数据减轻了分布偏移问题。
S3D8 权重格式
- 提出 2.7-bit-per-parameter 权重表示:权重按组划分,每组共享 scale 与 zero-point,结合 3-bit 表示与稀疏/非均匀码本,实现实际平均 2.7 bits。
- 物理布局与解码逻辑针对 Arm CPU 的 SIMD 指令与缓存特性协同设计,支持快速反量化与矩阵乘。
输出
最终生成可直接部署在 Arm CPU 的量化模型,权重压缩至 3.7 GB,激活为 8-bit,在标准视觉问答任务上保持较强性能。
与同类方法的差异点
相比 GPTQ 等后训练量化依赖校准集且恢复能力有限,本方法用 自生成数据的 QAT 提升低比特鲁棒性;同时 S3D8 格式面向移动 CPU 原生优化,而非 GPU 张量核心。
实验
实验设计
Llama-Mobile 提出一种 VLMs 量化框架,核心包含两个部分:一是 量化感知训练(QAT) 流程,使用模型自身生成合成训练数据,避免依赖原始训练集;二是专为 Arm CPU 设计的 2.7-bit-per-parameter 格式 S3D8。实验将 Llama 3.2 11B Vision Instruct 压缩至 3.7 GB,激活量化为 8-bit,并在多个标准视觉问答任务上验证性能。
关键发现
- 模型规模缩小至 3.7 GB,权重位宽 2.7-bit,激活 8-bit,适合移动端内存约束。
- 在视觉问答任务上保持 strong performance,说明低比特量化结合 QAT 可有效保留多模态能力。
- 自生成数据 pipeline 消除了对原始训练数据的依赖,降低了量化门槛。
对比与工程启示
相较于常见的 GPTQ 等后训练量化方法,本文的 QAT 方法能更充分考虑量化误差,并通过 S3D8 格式实现 Arm CPU 上的高效执行。对于移动端部署,算法与硬件格式的协同设计是关键:不仅需要优化量化位数,还要确保解码路径在目标硬件上高效。该工作展示了在资源受限环境下部署 VLMs 的可行路径,验证了 sub-3-bit 权重压缩与 8-bit 激活组合的实用性。
行业影响
落地场景
将 Llama-Mobile 的 2.7-bit 量化方案直接推动 VLM 端侧部署,可落地于:
- 电商平台的商品视觉问答:用户拍照上传,端侧实时识别商品属性、材质、搭配建议,无需上传图片到云端,保护隐私并降低延迟。
- 内容平台的实时图像审核与自动描述:短视频 / 直播平台在移动端对违规内容进行初筛,生成图片 alt 文本以提升无障碍体验。
商业价值
- 降本:模型体积压缩至 3.7 GB(原 11B 模型通常 >22GB),内存占用减少 80% 以上,使中端手机可运行,显著降低云端推理请求量与带宽成本。
- 体验提升:推理延迟大幅降低,支持离线与强隐私场景,提升用户留存与付费意愿;对需要实时响应的 AR 辅助、视觉搜索等场景尤为关键。
与现有工作流接口
- 量化管线 无需原始训练数据,仅需模型自身生成合成数据,可快速应用到现有 VLM;
- 输出格式
S3D8已针对 Arm CPU 优化,与移动端推理框架(如 ExecuTorch、ONNX Runtime Mobile、Arm Compute Library)结合紧密; - 企业可通过模型转换工具将现有 Llama 3.2 Vision 等模型一键压缩,集成到现有 CI/CD 流程中,无需重新训练。
局限
- **合成数据生成** 依赖模型自身生成训练数据,虽然避免了访问原始训练集,但生成数据的分布可能与真实多模态数据存在偏差,导致在特定领域或稀有概念上的泛化不如使用真实数据训练的量化模型。该方法假设模型自身生成的数据足够有代表性,但未验证数据多样性对量化鲁棒性的影响。
- **评测任务单一**:论文仅在标准视觉问答(VQA)任务上验证性能,未覆盖其他重要的多模态能力(如图像描述、视觉推理、视频理解等)。量化对多模态模型中视觉编码器与语言模型交互的影响可能在不同任务上表现不一致,因此该方法在更广泛 VLM 任务上的适用性仍有待验证。
- **硬件绑定与泛化局限**:提出的 2.7-bit 格式(S3D8)针对 Arm CPU 优化,依赖特定的解码逻辑和物理布局,可能无法直接迁移到其他硬件平台(如 GPU、NPU 或 x86 CPU)。此外,仅对单个模型(Llama 3.2 11B Vision Instruct)进行了验证,缺乏对其他主流 VLM(如 Gemma 3、Qwen3-VL)的横向对比,格式的通用性需要进一步实验支持。