PhysCaP: 物理信息探索下的代码即策略智能体
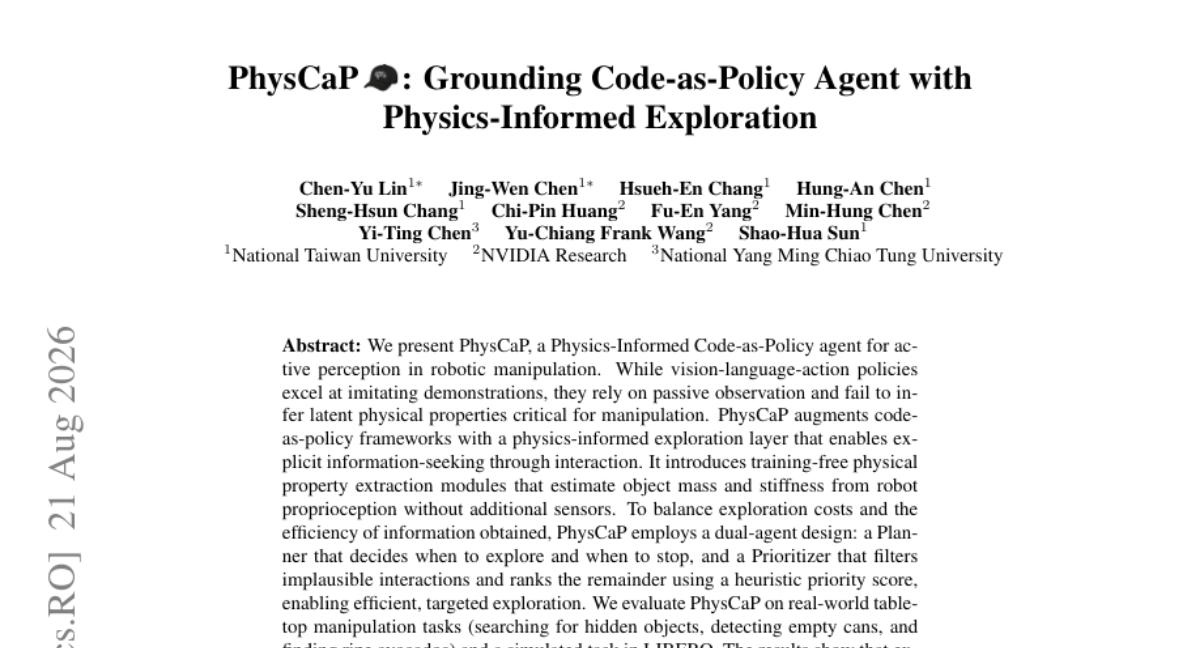
PhysCaP 是一种面向机器人操作主动感知的物理信息代码即策略智能体。现有视觉-语言-动作策略虽擅长模仿演示,但依赖被动观察,难以推断操作所需的关键潜在物理属性。PhysCaP 在代码即策略框架中引入物理信息探索层,通过主动交互显式寻求信息。 具体而言,PhysCaP 包含训练无关的物理属性提取模块,仅利用机器人本体感觉即可估计物体质量与刚度,无需额外传感器。方法采用双智能体设计:Planner 负责决策探索时机与停止条件,Prioritizer 过滤不可行交互,并按启发式优先级分数对候选交互排序,实现高效、有目的的探索。 我们在真实桌面任务(搜索隐藏物体、检测空罐、寻找成熟牛油果)及 LIBERO 模拟环境中评估了 PhysCaP。结果表明,面对隐藏物理属性,现有被动与朴素交互基线要么失败、要么过度探索;PhysCaP 则以更少交互与更短执行时间达到相当性能。消融实验进一步验证了物理属性提取模块的有效性。
论文精读
TL;DR PhysCaP 让机器人通过主动交互与本体感觉测量物体质量/刚度,无需额外传感器,再用 Planner/Prioritizer 双智能体高效筛选探索动作,在隐藏物理属性的操作任务中比被动 VLA 和朴素探索更准、更省交互。
问题
问题背景
当前机器人操作领域正从模仿学习向 视觉-语言-动作(VLA) 大模型策略演进,强调从人类演示中直接学习闭环控制。但多数方法仍以被动视觉观察为核心,将控制视为条件概率映射。
现有方法局限
- 被动 VLA 策略:仅依赖 RGB 图像 / 深度输入,无法感知物体的质量、刚度等隐式物理属性。例如“判断易拉罐是否为空”需要重量信息,“判断牛油果是否成熟”需要刚度信息,纯视觉推理容易失败。
- 朴素交互式探索:一些方法引入机器人主动触碰,但缺乏规划,常对所有候选物体逐一尝试,导致交互次数和执行时间指数增长,且可能施加过大接触力,存在安全风险。
- 代码即策略(Code-as-Policy):LLM 生成高层代码能处理结构化任务,但代码执行仍以被动感知为主,缺少显式的“信息寻求”机制,无法在运行中动态决定下一步探索对象。
为什么难 / 重要
- 物理属性无法从单目视觉直接恢复,必须通过物理交互(推、抓、压)来间接观测。但交互本身有成本:关节力矩 / 位置噪声、接触导致物体不可逆位移、时间开销。
- 如何利用训练免费的方式从机器人本体感觉(关节力矩 / 位姿)中提取质量、刚度,而不依赖额外力传感器或触觉传感器,是一个开放工程挑战。
- 业界关注高效的主动感知:在仓储分拣、服务机器人、食品处理等任务中,需要快速识别隐藏物体、区分空 / 满容器或成熟度,任何过度探索都会显著降低部署效率。
行业类比
类似于多模态检索系统按需查询关键特征,而非对全库做暴力相似度匹配——PhysCaP 希望在物理交互层面实现“有选择性、有优先级的信息获取”。
核心洞察
- 将物理属性推断从被动观察升级为主动探索,突破 VLA 的感知局限。同类 vision-language-action 策略仅从视觉输入模仿演示,无法获取质量、刚度等潜在物理量;PhysCaP 通过交互提取 proprioception 信号,显式引入训练-free 的物理属性提取模块,使 code-as-policy 代理能够根据隐藏属性制定操作决策,在需要主动感知的任务中显著优于被动 baseline。
- 双代理分工(Planner 与 Prioritizer)将探索决策与交互排序解耦,解决 naive 交互的过探索问题。与一次性随机交互或固定次数的 baseline 不同,PhysCaP 先由 Prioritizer 过滤不可信交互并按启发式优先级排序,再由 Planner 决定何时停止探索,以更少交互次数达到与被动模型相当甚至更高的成功率,同时降低执行时间,为交互式操作提供了成本可控的探索范式。
方法
输入与总览
PhysCaP 以 code-as-policy 框架为基础,输入包括 RGB 图像、机器人关节状态 / 力矩等 proprioception 信号,以及自然语言任务指令。系统将物理属性估计作为显式状态,并融入代码生成与执行流程。
关键模块
- 物理属性提取模块:训练无关,直接从
proprioception估计物体 质量(提起物体时关节力矩 / 电流变化)和 刚度(按压时力 - 位移斜率),无需额外传感器。 - Planner Agent:接收任务描述与当前属性估计,决定是否探索、何时停止,输出探索意图及最终代码策略。
- Prioritizer Agent:对候选交互(抓取、提起、按压等)做合理性过滤,用启发式优先级分数排序,返回精简后的探索候选列表。
- 底层控制原语:将探索动作转为机器人控制指令,执行后产生新的
proprioception数据供属性提取模块更新。
工作流与输出
初始化后,Planner 判断是否需要探索;若需要,调用 Prioritizer 获得排序候选,执行交互并更新属性估计,循环直到 Planner 决定停止,最后生成可执行的操作代码策略。该设计将主动感知与代码生成解耦,实际工程中可独立调试属性估计器与探索策略。
与被动 VLA 相比,PhysCaP 通过交互获取隐藏物理属性;与 naive 交互基线相比,Prioritizer 排序减少了无效探索,以更少交互达到可比性能。
实验
实验设计
PhysCaP 在 真实世界桌面操作(寻找隐藏蓝色方块、识别空罐、挑选成熟牛油果)与 LIBERO 仿真基准 上评估。对比基线包括被动 VLA(仅观察)与朴素交互式方法(无优先级过滤)。消融研究验证 质量测量 与 刚度测量 模块的有效性,并考察合并 Planner/Prioritizer 的影响。
关键发现
现有被动方法在物理属性隐式依赖任务中失败;朴素交互方法往往过度探索。
PhysCaP 通过 双智能体设计(Planner 决定何时探索/停止,Prioritizer 过滤不合理交互并按启发式优先级排序)实现更少交互次数与更短执行时间,同时达到可比成功率。消融显示物理属性提取模块独立贡献显著,移除任一模块导致性能下降。
与基线的深度对比
被动 VLA 缺乏主动感知能力,无法推断质量/刚度等隐变量;PhysCaP 的 code-as-policy 框架通过生成代码显式调用探索原语,使信息获取可解释、可控制。朴素交互方法不考虑探索成本,容易陷入低效的试错;Prioritizer 利用启发式打分(如物体可移动性、形变风险)过滤不可能的交互,将有限预算分配给高信息增益动作,这是效率提升的关键。工程上,训练无关的物理属性提取模块(基于本体感觉)可直接嵌入现有机器人系统,无需额外传感器或数据收集,为 LLM/VLM 驱动的操作策略提供了轻量级的主动感知增强路径。
行业影响
落地场景
PhysCaP 可用于电商仓储机器人分拣与食品加工等场景。例如仓储中,机器人需要区分空罐与满罐、定位隐藏物体,PhysCaP 通过本体感知测量质量与刚度,无需额外传感器即可提升操作成功率。在食品处理中,可检测鳄梨成熟度(刚度差异),减少人工质检。
商业价值
降低硬件成本:替代力矩传感器或视觉系统,仅靠关节力矩/位置估计质量与刚度,BOM 成本下降。提升操作效率:Planner 与 Prioritizer 避免盲目探索,减少平均交互次数与执行时间,在 LIBERO 模拟与真实任务中接近基线性能但交互更少。对物流和农业自动化,可降本增效,加快部署。
与现有产品/工作流接口
PhysCaP 作为 code-as-policy 框架的插件层,可与现有 VLM/LLM 高层规划器(如 Code as Policies、SayCan)结合:Coding Agent 生成操作代码,PhysCaP 在其间插入物理探索原语。训练免费,可直接应用于现有的机器人控制栈(ROS 2、MoveIt)或云端 VLA 推理服务。对于已有被动 VLA 模型,可将 PhysCaP 作为外部 active perception 模块,通过 API 调用触发探索。
局限
- - **物理属性提取模块适用范围有限**。仅支持质量和刚度估计,依赖特定交互原语(抓取提升、按压),要求物体可抓取或可按压,对易碎、不规则物体不适用。额外探索动作增加时间成本和碰撞风险,在动态或密集场景受限。
- - **双智能体设计的 LLM 依赖与实时性挑战**。Planner 和 Prioritizer 均基于 LLM,每次探索循环均需调用,可能引入秒级延迟,难以满足高速操作或实时控制。LLM 输出稳定性和物理常识理解差异可能影响探索效率,论文未讨论计算受限场景。
- - **实验规模和泛化性验证不足**。真实世界仅三个桌面任务,物体种类和交互有限;仿真对比仅在 LIBERO 特定任务。未在更广泛基准或复杂抓取中验证,也未展示对新物体或新物理属性的泛化。与 VLA 对比仅仿真,sim-to-real 差距可能被低估。