4DAnyone: 从随意单目视频创建 4D 人物
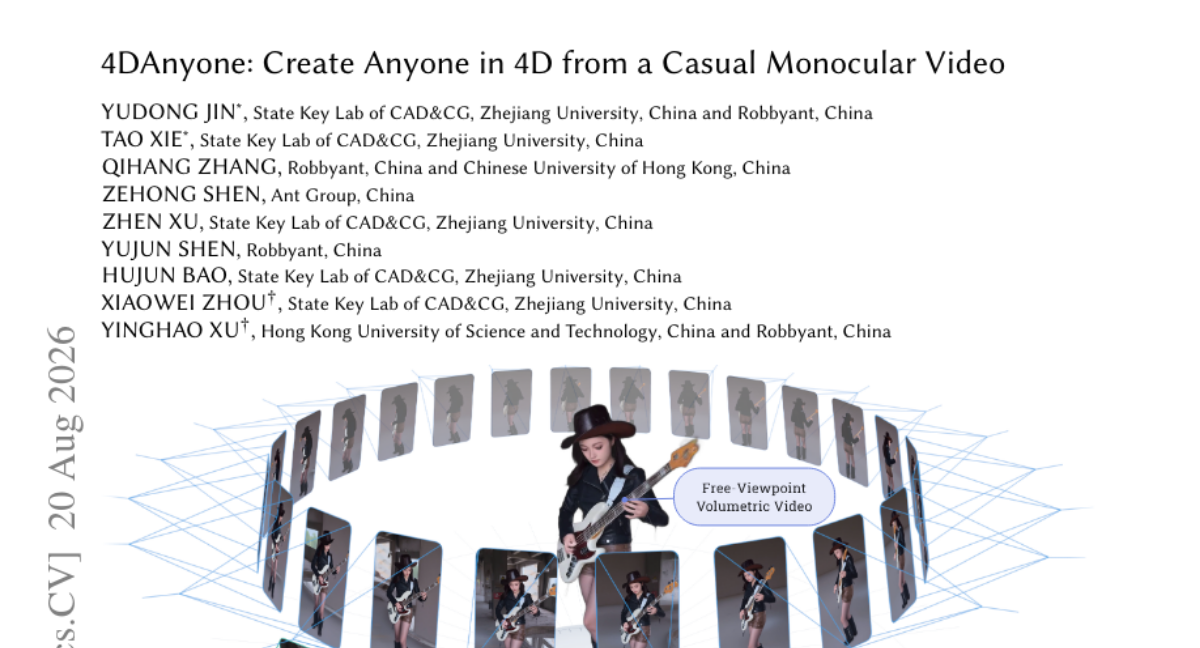
我们提出 4DAnyone,一个从无标定单目视频重建 4D 人体的框架,通过生成重建级的多视角一致视频并将其提升为 4D 高斯泼溅(4DGS)。现有的相机控制视频扩散模型能合成合理的新视角视频,但当目标视角扩展到 4DGS 重建所需的数十个视角时,无法保持一致性。我们将这种失败归因于 有界注意力上下文 问题:当目标视角超过单个 DiT 前向传播的容量时,必须拆分为若干组,从而暴露两个耦合瓶颈。 在参考上下文方面,对所有先前生成视角的条件化以 O(N) 增长,削弱了跨视角外观引导;在目标上下文方面,不连通的组无法直接交换信息,导致全局结构漂移。4DAnyone 通过两种互补设计解决这两个瓶颈:参考上下文打包(RCP) 将不断增长的参考视角压缩为固定长度的混合分辨率上下文,实现 O(1) 参考上下文复杂度;目标上下文路由(TCR) 在去噪过程中轮转目标视角分组,在高噪声步骤共享跨组上下文,在低噪声步骤稳定细节。 我们还利用自研游戏引擎构建 MVGameHuman 数据集,并将其与光阶段和真实世界视频数据集结合进行训练。在 DNA-Rendering 和 DyMVHumans 上的实验表明,4DAnyone 在新视角视频质量和下游 4DGS 重建方面均优于先前方法,并具有强大的真实世界泛化能力。
论文精读
TL;DR 4DAnyone 从单目视频重建可自由视角渲染的 4D 人类,通过 Reference Context Packing 与 Target Context Routing 破解多视角扩散模型随视角增多的一致性崩塌,使 4DGS 重建质量超越现有方法。
问题
问题背景: 从单目视频重建 4D 人体是生成式 AI 和计算机视觉交叉领域的热点,目标是从一段日常拍摄的视频中恢复动态 3D 人体,支持自由视角渲染。传统方法依赖多相机系统或精确标定,难以普及。
现有方法局限:
近期工作利用相机控制视频扩散模型 合成新颖视角视频,再交由4D Gaussian Splatting (4DGS) 重建。但当目标视角扩展到 4DGS 所需的数十个时,模型必须分批生成,一致性会急剧下降。论文指出这源于有界注意力上下文问题:参考侧条件化所有已生成视角导致复杂度为 O(N),削弱外观指导;目标侧分组间缺乏信息交换,引发全局结构漂移。
为什么这个问题难/重要: 多视角一致性 是重建质量的关键,而 DiT 的单次前向注意力容量有限,无法同时处理大量视角。在有限上下文内扩展视角数量并维持全局一致性,是视频扩散模型从“短视频生成”跨越到“重建级多视角生成”必须攻克的障碍。业界对此高度关注,因为它直接关系到低成本 4D 内容生产、数字人自动化等落地场景。
行业类比: 类似大语言模型 处理超长上下文时的外推困难:序列长度超出训练分布后,模型质量骤降,需要专门的分段与路由策略来维持全局连贯性。
核心洞察
- 将多视角一致性失败的根本原因归结为 DiT 的 bounded-attention-context 问题:当目标视图数量超过单次前向容量时,参考上下文随已生成视图线性增长(O(N)),且目标视图分组之间无法交换信息。这一定位区别于以往工作将不一致归因于训练数据不足或相机控制不精确,揭示了扩散模型在多视图生成中的架构级缩放瓶颈,为后续设计提供了明确的优化方向。
- 针对上述瓶颈,4DAnyone 采用解耦设计:Reference Context Packing (RCP) 将参考视图压缩为固定长度的混合分辨率上下文,使参考注意力复杂度降为 O(1);Target Context Routing (TCR) 在去噪早期旋转目标视图分组以共享全局结构,后期固定分组以稳定细节。区别于静态分组或全联合注意力,该方案将噪声水平作为分组策略的调节信号,在可扩展性与一致性之间取得平衡。
方法
输入与条件
输入为未标定单目视频(含轻微相机运动、未知内参和位姿)。先提取 3D-aware 骨架条件:估计视频中人体的 SMPL 姿态,投影到目标视角作为空间控制信号,引导后续视频生成。
关键模块:可扩展的多视角一致性
针对多视角 video diffusion 的扩展瓶颈,提出两个互补设计:
- Reference Context Packing (RCP):将已生成的参考视图压缩成固定长度的混合分辨率上下文,使参考上下文复杂度从 O(N) 降为 O(1),避免条件信息随视图数增长而削弱跨视角外观约束。
- Target Context Routing (TCR):在去噪迭代中轮换目标视图分组。高噪声阶段在组间共享上下文以对齐全局结构;低噪声阶段固定分组以稳定细节,缓解分组隔离导致的漂移。
输出与训练
生成 multiview-consistent 人体视频序列,随后 lift 到 4D Gaussian Splatting (4DGS),可直接从任意新视角渲染动态人体。训练使用自建 MVGameHuman 数据集(游戏引擎渲染),并与 light-stage 及 in-the-wild 视频数据混合训练,提升泛化。
跟同类方法的差异点:相比之前的 camera-controlled video diffusion(受限于 attention context 固定容量,扩展视图时一致性崩溃),RCP+TCR 将参考上下文压缩为常数级并路由目标分组,首次在数十个目标视角下保持重建级一致性。
实验
实验设计
- 评估数据集:DNA-Rendering 与 DyMVHumans,覆盖多视角动态人体序列。
- 训练数据:自建 MVGameHuman 数据集(基于游戏引擎),并混合 light-stage 与 in-the-wild 视频。
- 对比基线:与已有 camera-controlled video diffusion 及 4DGS 重建方法比较。
关键发现
- Reference Context Packing (RCP) 将多视角参考上下文压缩为固定长度,复杂度 O(1),避免随视图数线性增长。
- Target Context Routing (TCR) 在去噪不同阶段旋转目标视图分组,高噪声步骤共享全局上下文,低噪声步骤保持细节。
- 在生成数十个目标视图时仍能维持多视角一致性,显著优于基线,且 in-the-wild 视频上泛化稳健。
对比解读
现有 camera-controlled video diffusion 在视图数量超出单次 DiT 前向容量时必须分组,但参考上下文 O(N) 增长与目标组间信息割裂导致一致性与结构漂移。4DAnyone 通过 RCP 与 TCR 分别解决两侧瓶颈,使多视图生成从“可行但易崩溃”提升到“重建级”质量,为下游 4DGS 提供可靠输入。这一设计对工业界扩展多视图扩散模型有直接借鉴意义。
行业影响
落地场景
- 内容创作平台:用户上传单目视频,自动生成可自由运镜的 4D Gaussian Splatting 数字人,用于虚拟主播、短视频特效、游戏角色原型。
- 电商平台:卖家上传一段模特展示视频,自动生成多角度商品模特,嵌入商品详情页提供 360 度旋转预览,减少摄影棚多机位拍摄成本。
- 在线教育 / 企业培训:讲师录制一次教学视频,生成多视角虚拟教师,支持学员交互式观察动作细节。
商业价值
- 降本:替代传统多相机阵列采集与手工建模,将 4D 人体内容生产成本降低一个数量级,单段视频即可完成。
- 增收:提升电商转化率(AR 试穿 / 3D 展示可提高购买意愿),内容平台增加用户停留与 UGC 创作活跃度。
- 体验提升:提供电影级自由视角回放、个性化数字人生成,推动元宇宙 / 虚拟社交等新形态交互。
接口集成与 Use Case
- 技术集成:
4DAnyone输出为多视角一致视频序列,可直接喂给现有 4DGS 渲染引擎(如gsplat、diff-gaussian-rasterization),前端支持 ONNX / TensorRT 部署。模型可作为插件模块集成到 video diffusion 管线(如 AnimateDiff、SVD),或封装为 REST API 供云端 GPU 集群调用。 - 具体 Use Case:某全球电商平台将 4DAnyone 集成到卖家工作台,卖家上传 10 秒模特视频,自动生成 4D 商品模特,支持买家在 App 内旋转缩放,替代传统 3D 建模外包,降低上新成本。另一场景:在线健身平台利用用户自拍视频生成 4D 教练模型,提供多角度动作跟练矫正。
局限
- **输入视频质量依赖较强**:方法需要从单目视频中估计人体姿态(如通过 HMR),对快速运动、严重遮挡或极端视角的鲁棒性有限,姿态估计错误会直接传递到多视角生成和后续 4DGS 重建。此外,训练依赖合成数据(MVGameHuman)与光场数据,尽管结合了 in-the-wild 视频,但 sim-to-real 差距仍可能影响对真实复杂场景(如复杂光照、纹理)的泛化。
- **扩展性与高频细节损失**:Reference Context Packing 将参考视图压缩到固定长度上下文,可能丢失高频外观细节或长距离一致性;Target Context Routing 的旋转分组策略虽然缓解了组间隔离,但当目标视图数量极大(如 >100)时,分组与旋转次数增加,计算开销显著上升,实际部署需在一致性与效率之间权衡。
- **几何精度与对比不足**:相比基于显式多视角输入或深度传感器的方法,4DAnyone 从单目视频推断 3D 几何,在宽松衣物、复杂非刚性变形场景下可能缺乏几何精度。论文主要评估了渲染质量和重建指标,但与经典 MVS 或 NeRF 类方法在几何误差上的直接对比有限,其重建精度上限尚未充分验证。